
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- From
- 딥시크
- 영어학습법
- ing
- #삼립수박샌드 #수박샌드 #삼립신상 #삼립빵 #신상빵 #편의점신상 #편의점빵 #편의점디저트 #세븐일레븐신상 #세븐일레븐빵 #편의점간식 #신상과자리뷰 #신상리뷰 #수박맛 #수박맛빵 #수박바맛 #수박디저트 #여름간식 #여름디저트 #크림샌드 #크림카스테라 #카스테라 #빵리뷰 #간식추천 #편의점추천
- AS
- TO
- deekseek
- be to 부정사
- 중국AI
- \
- 김원스쿨
- #뱅크시 #뱅크시전시 #뱅크시전시회 #뱅크시서울전시 #뱅크시스틸히어 #BANKSY #BANKSYSTILLHERE #더현대뱅크시 #더현대서울뱅크시 #더현대서울전시 #더현대전시 #더현대전시회 #더현대서울ALT1 #ALT1 #현대백화점전시 #서울전시 #서울전시회 #서울전시추천 #서울전시회추천 #서울미술전시 #서울미술관 #서울가볼만한곳 #서울실내데이트 #서울데이트 #서울데이트코스 #서울데이트추천 #여의도전시 #여의도데이트 #여의도가볼만한곳 #여의도데이트코스 #
- 0528
- IS
- 자리의힘
- GPT
- put
- Into
- 자리
- 5형식
- TO 부정사
- Today
- Total
AI바라기의 인공지능
LLM : 논문 리뷰 : SELF-CONSISTENCY IMPROVES CHAIN OF THOUGHT REASONING IN LANGUAGE MODELS 본문
LLM : 논문 리뷰 : SELF-CONSISTENCY IMPROVES CHAIN OF THOUGHT REASONING IN LANGUAGE MODELS
AI바라기 2026. 9. 14. 19:21
용어 설명
- Self-Consistency (자기 일관성): 단일 탐색 경로에 의존하지 않고 여러 개의 다양한 추론 경로(Reasoning Paths)를 샘플링한 후, 가장 일관되게 도출된 최종 정답을 다수결로 선택하는 디코딩 전략.
- Sample-and-Marginalize (샘플링 및 주변화): 언어 모델 디코더에서 다양한 추론 경로를 먼저 샘플링(Sample)한 뒤, 중간 추론 경로(Latent Variable)를 소거(Marginalize out)하고 최종 답변의 빈도수를 취합하는 절차.
- Greedy Decoding (탐욕적 디코딩): 각 스텝마다 가장 높은 확률을 가진 토큰만을 선택하는 결정론적 생성 방식. 반복성 문제와 지역 최적해(Local-optimality)에 취약함.
- Self-Ensemble (자가 앙상블): 여러 개의 독립된 모델을 학습시켜 결합하는 전통적 앙상블과 달리, 단일 사전 학습 모델 내부에서 다양한 추론 경로 생성을 통해 앙상블 효과를 내는 기법.
- Normalized Weighted Sum (정규화 가중합): 생성된 시퀀스의 길이에 따른 확률 왜곡을 방지하기 위해 토큰 길이(K)로 조건부 확률을 나눈 뒤 가중치를 부여해 답변을 집계하는 방식.
- Zero-shot CoT (제로샷 생각의 연쇄): 예시(Few-shot exemplars) 없이 "Let's think step by step"과 같은 단일 프롬프트만으로 다단계 추론을 유도하는 방식.
Purpose of the Paper
- 기존 연구의 한계 극복: 기존의 Chain-of-Thought (CoT) 프롬프트 방식은 Greedy Decoding을 사용하여 한 번의 추론 실수(Compounding Error)가 발생하면 오답으로 직결되며, 탐욕적 선택으로 인한 국소 최적화와 생성 반복성 문제가 존재함.
- 추가 비용 및 감독의 한계 탈피: 생성 품질을 높이기 위한 기존 해결책(Verifier 모델 별도 학습, Human Annotation 기반 Re-ranker 훈련 등)은 막대한 추가 데이터와 훈련 비용이 소모됨.
- 새로운 패러다임 제시: 복잡한 추론 문제에는 "다양한 사고방식(Reasoning Paths)이 존재할 수 있지만 올바른 사고는 동일한 정답으로 수렴한다"는 인지적 직관에 착안, 단일 모델에서 비지도(Unsupervised) 및 오프더셸프(Off-the-shelf) 방식으로 작동하는 새로운 디코딩 알고리즘을 제안함.
Key Contributions & Novelty
- 비지도 방식의 Self-Ensemble 디코딩 전략 제안 (Novelty):
- 추가적인 훈련, 미세 조정, 외부 Verifier 모델 없이 기존 Pre-trained Language Model에 즉시 적용 가능한 자가 앙상블 디코딩 프레임워크 구현.
- 추론 경로의 잠재 변수화 및 주변화 공식화:
- 추론 경로를 잠재 변수(Latent Variable)로 모델링하고, 최종 답변 도출 시 다수결(Majority Vote)을 통해 경로를 성공적으로 Marginalize out함.
- 실험을 통해 단순 다수결(Unweighted sum)이 복잡한 확률 기반 정규화 가중합(Normalized weighted sum)과 대등한 성능을 보임을 규명 (언어 모델의 자체 확률 보정(Calibration) 한계로 인해 생성물 간 상대 확률차가 크지 않기 때문).
- 불확실성 추정(Uncertainty Estimation) 메커니즘 발견:
- 생성된 샘플들 간 정답의 일치도(Consistency Percentage)가 실제 정답률과 강한 양의 상관관계를 가짐을 밝혀내어, 모델이 "자신이 모르는 것을 아는(Know when it doesn't know)" 신뢰도 지표로 활용 가능함을 입증.
- CoT 역효과 현상 완화:
- 자연어 추론(NLI) 등 기존 CoT 적용 시 오히려 Standard Prompting보다 정확도가 떨어지던 작업에서 Self-Consistency를 통해 성능 하락을 역전시키고 추가 성능 향상을 달성.
Experimental Highlights
- 실험 설정:
- Models: UL2-20B, LaMDA-137B, GPT-3 (code-davinci-001, code-davinci-002), PaLM-540B.
- Tasks & Datasets: 산술 추론 (GSM8K, SVAMP, MultiArith, ASDiv, AQuA), 상식 및 기호 추론 (StrategyQA, CSQA, ARC-c/e, Last letter concatenation, Coinflip), 일반 NLP (ANLI, e-SNLI, RTE, BoolQ, HotpotQA).
- Settings: 디코더에서 40개의 추론 경로를 독립 샘플링(Temperature Sampling, Top-k, Nucleus 적용) 후 다수결 집계.
- 주요 성능 향상 (State-of-the-Art 갱신):
- GSM8K: PaLM-540B 기준 기존 Greedy CoT 56.5%에서 74.4%로 절대 성능 +17.9% 향상. GPT-3 (code-davinci-002)에서도 60.1%에서 78.0%로 +17.9% 향상. (수천 개의 데이터로 파인튜닝된 전용 모델 능가).
- 산술 추론 전반: SVAMP (+11.0%), AQuA (+12.2%), MultiArith (PaLM-540B: 99.3%, Code-davinci-002: 100.0% 달성).
- 상식 추론: StrategyQA (+6.4%), ARC-challenge (+3.9%).
- 비교 디코딩 및 앙상블 기법 압도:
- 동일 샘플 수 기준 Sample-and-Rank 기법 대비 큰 격차로 우수.
- Beam Search 대비 출력 다양성을 확보한 Sampling 기반 Self-Consistency가 월등히 우수함 (Beam Search 적용 시 다양성 결여로 성능 정체).
- 프롬프트 순서 변경(Permutation)이나 다중 프롬프트 작성 기반 앙상블, 다중 모델 앙상블(더 낮은 체급의 모델이 고체급 모델 성능을 깎아먹는 문제 발생) 대비 단일 고체급 모델의 Self-Consistency가 훨씬 뛰어남.
- 스케일링 특성: 모델의 파라미터 규모가 커질수록(UL2-20B < LaMDA-137B < PaLM-540B) Self-Consistency를 통한 성능 이득 폭이 비약적으로 증가함.
Limitations and Future Work
- 연산 비용 증가 (Computational Cost):
- 문제점: 단일 입력당 수십 개(예: 40개)의 시퀀스를 디코딩해야 하므로 추론 연산 비용과 레이턴시가 선형적으로 증가함.
- 극복 방향: 성능 곡선이 5~10개 샘플 부근에서 빠르게 포화(Saturate)되므로 소량 샘플링을 우선 채택하거나, Self-Consistency로 생성된 고품질 데이터를 Supervised Data로 활용해 단일 모델을 Fine-tuning하여 Single-pass 추론에서도 높은 정확도를 유지하도록 유도.
- 중간 추론의 사실성 왜곡 (Hallucination/Ungrounded Rationales):
- 문제점: 최종 정답은 일치할지라도 중간 reasoning path에 포함된 세부 수치나 근거가 사실과 다르거나 논리적 비약이 발생하는 문제(예: StrategyQA 인구수 불일치)가 여전히 잔존함.
- 극복 방향: 외부 지식과의 정합성을 맞추는 Grounding 메커니즘 연구 필요.
- 적용 영역의 제약 (Closed/Fixed Answer Domain):
- 문제점: 다수결 집계를 위해 최종 답변이 특정 범주나 수치 등 고정된 형태(Fixed answer set)로 파싱 가능해야 함.
- 극복 방향: 텍스트 간 논리적 함의(Entailment)나 모순(Contradiction)을 판정할 수 있는 메트릭을 도입하여 Open-ended 텍스트 생성 태스크로 확장.
Overall Summary
본 논문은 대규모 언어 모델의 복잡한 추론 태스크에서 기존 탐욕적 디코딩(Greedy Decoding)의 한계를 깨고, 다양한 생각의 경로를 샘플링한 후 주변화(Marginalize)하여 최빈 정답을 도출하는 Self-Consistency 기법을 제안한다. 별도의 훈련이나 추가 데이터 주석 없이 모델 자체의 잠재 추론 경로 다양성을 활용함으로써, 산술 및 상식 추론 벤치마크 전반에서 큰 폭의 성능 향상을 기록하며 새로운 State-of-the-Art를 달성했다. 또한 다수결 일치율을 모델의 신뢰도 및 불확실성 지표로 활용할 수 있음을 규명하여, 생성 모델의 추론 안정성과 자가 검증 가능성을 한 단계 끌어올린 연구로 평가받는다.
쉬운 설명
어려운 주관식 수학 문제를 한 학생이 한 번 쓱 풀고 제출하면(Greedy CoT) 중간 계산 실수로 엉뚱한 답을 낼 확률이 높습니다. 하지만 여러 명의 학생(혹은 한 학생이 여러 차례)에게 **"각자 편한 방식으로 풀이 과정을 자유롭게 써가며 풀어보라"**고 시킨 뒤 답안지를 모으면, 오답을 낸 사람들은 계산 착오나 논리 오류의 방향이 제각각이라 엉뚱한 숫자로 흩어지지만, 제대로 푼 사람들은 풀이 공식이나 접근법이 달라도 결국 똑같은 정답 숫자로 수렴하게 됩니다. Self-Consistency는 모델에게 여러 가지 다른 방식으로 문제를 풀어보게 만든 뒤, 가장 많이 나온 공통의 정답을 채택하는 **"단일 모델 기반의 다수결 검산 시스템"**입니다.
ABSTRACT
pre-trained 된 large language models와 결합된 chain-of-thought prompting은 복잡한 reasoning 태스크에서 고무적인 결과를 달성했습니다.
본 논문에서는 chain-of-thought prompting에 사용되던 단순한 greedy decoding을 대체하기 위한 새로운 decoding strategy인 self-consistency를 제안합니다. 이는 단순히 greedy한 경로 하나만을 취하는 대신 다양한 reasoning paths 세트를 먼저 sampling한 다음, sampled reasoning paths를 marginalizing out하여 가장 일관된 정답을 선택합니다.
Self-consistency는 복잡한 reasoning 문제가 일반적으로 고유한 정답으로 이어지는 여러 가지 다양한 사고 방식을 허용한다는 직관을 활용합니다.
광범위한 실증적 평가 결과에 따르면, self-consistency는 GSM8K (+17.9%), SVAMP (+11.0%), AQuA (+12.2%), StrategyQA (+6.4%), 그리고 ARC-challenge (+3.9%)를 포함하여 널리 쓰이는 다양한 산술 및 commonsense reasoning benchmarks에서 눈에 띄는 격차로 chain-of-thought prompting의 성능을 크게 향상시키는 것으로 나타났습니다.
1 INTRODUCTION
language models가 다양한 NLP 태스크 전반에 걸쳐 주목할 만한 성공을 입증해 왔음에도 불구하고, 이들의 reasoning 능력은 종종 한계점으로 지적되어 왔으며, 이는 단순히 model scale을 키우는 것만으로는 극복할 수 없습니다.
이러한 단점을 해결하기 위한 노력의 일환으로, chain-of-thought prompting이 제안되었는데, 이는 사람이 어떤 태스크를 해결할 때 사용할 법한 reasoning process를 모방하는 일련의 짧은 문장들을 생성하도록 language model에 prompting하는 방식입니다.
예를 들어 “주차장에 차가 3대 있고 2대가 더 들어온다면, 주차장에는 몇 대의 차가 있을까요?”라는 question이 주어졌을 때, 단순히 “5”라고 직접 답하는 대신 language model은 다음과 같은 전체 chain-of-thought를 답변하도록 유도됩니다: “주차장에 이미 차가 3대 있습니다. 2대가 더 옵니다. 이제 $3 + 2 = 5$대의 차가 있습니다. 정답은 5입니다.”. 이러한 chain-of-thought prompting은 다양한 multi-step reasoning 태스크에서 model performance를 크게 향상시키는 것으로 관찰되었습니다.
본 논문에서는 chain-of-thought prompting에 사용되던 greedy decoding strategy를 대체하고, language models의 reasoning performance를 상당한 격차로 더욱 끌어올리는 self-consistency라는 새로운 decoding strategy를 도입합니다.
Self-consistency는 복잡한 reasoning 태스크가 일반적으로 정답에 도달하는 복수의 reasoning paths를 허용한다는 직관을 활용합니다. 특정 문제에 대해 신중한 사고와 분석이 더 많이 요구될수록, 정답을 찾아낼 수 있는 reasoning paths의 다양성 역시 더욱 커집니다.
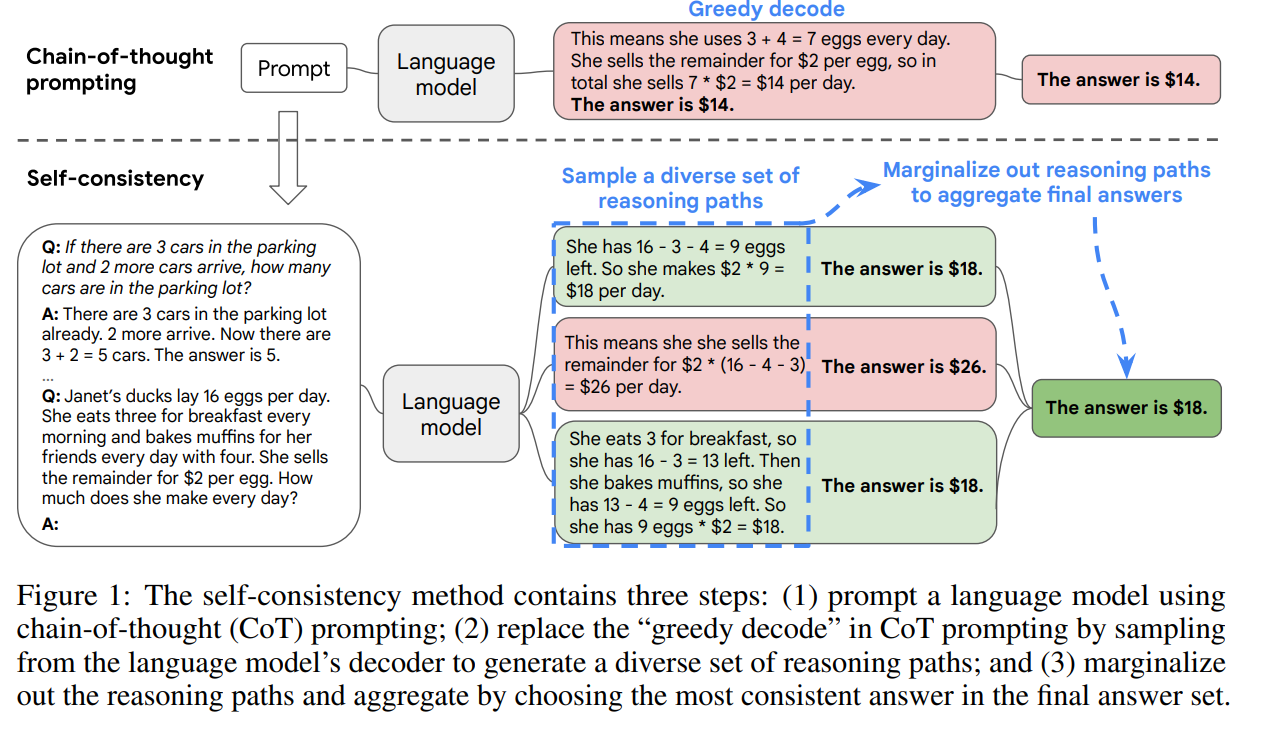
Figure 1은 self-consistency 방식을 예시와 함께 보여줍니다.
먼저 language model에 chain-of-thought prompting을 적용한 후, 최적의 reasoning path를 greedily decoding하는 대신 “sample-and-marginalize” decoding 절차를 제안합니다: 우선 language model의 decoder로부터 sampling하여 다양한 reasoning paths 세트를 생성합니다. 각 reasoning path는 서로 다른 final answer로 이어질 수 있으므로, sampled reasoning paths를 marginalizing out하여 최종 정답 세트에서 가장 일관된 정답을 찾아 최적의 정답을 결정합니다.
이러한 접근법은 여러 다양한 사고 방식이 동일한 정답으로 이어질 때 해당 최종 정답이 맞다는 확신을 더 갖게 되는 인간의 경험과 유사합니다. 다른 decoding 방법들과 비교했을 때, self-consistency는 greedy decoding을 괴롭히는 반복성과 local-optimality를 방지하는 동시에 단일 sampled generation의 무작위성을 완화합니다.
Self-consistency는 generation quality를 향상시키기 위해 추가적인 verifier를 학습시키거나 추가적인 인간 주석 데이터를 기반으로 re-ranker를 학습시키는 기존 접근 방식들보다 훨씬 단순합니다. 대신 self-consistency는 전적으로 unsupervised 방식이며, pre-trained language models에 추가 설정 없이 바로 적용 가능하고, 추가적인 인간 주석이 필요 없으며, 일체의 추가 training, auxiliary models, 또는 fine-tuning을 수반하지 않습니다. 또한 self-consistency는 여러 models를 training하고 각 model의 결과물을 집계하는 일반적인 ensemble 접근 방식과 다르며, 단일 language model 위에서 작동하는 일종의 “self-ensemble”처럼 작동합니다.
우리는 다양한 크기를 갖는 4개의 language models를 대상으로 광범위한 산술 및 commonsense reasoning 태스크에서 self-consistency를 평가합니다: 공개된 UL2-20B 및 GPT-3-175B, 그리고 밀집 활성화 기반의 decoder-only language models인 LaMDA-137B와 PaLM-540B입니다.
4개의 모든 language models에서 self-consistency는 전 태스크에 걸쳐 눈에 띄는 격차로 chain-of-thought prompting 대비 성능을 향상시킵니다. 특히 PaLM-540B 또는 GPT-3와 함께 사용될 때, self-consistency는 GSM8K (절대 정확도 향상 +17.9%), SVAMP (+11.0%), AQuA (+12.2%)를 포함한 산술 reasoning 태스크와 StrategyQA (+6.4%), ARC-challenge (+3.9%)와 같은 commonsense reasoning 태스크 전반에서 새로운 state-of-the-art 수준의 성능을 달성합니다.
추가 실험을 통해, 우리는 표준 prompting에 비해 chain-of-thought를 추가하는 것이 오히려 성능을 저하시킬 수 있는 NLP 태스크에서도 self-consistency가 성능을 견고하게 향상시킬 수 있음을 입증합니다. 아울러 self-consistency가 sample-and-rank, beam search, ensemble 기반 접근법들을 크게 능가하며, sampling strategies와 불완전한 prompts에 대해서도 강건함을 보여줍니다.
Research Note: Section 1 (INTRODUCTION)
- Problem Formulation & Motivation
- Chain-of-Thought (CoT)의 기존 한계: CoT는 복잡한 reasoning 성능을 끌어올렸으나, 표준적인 greedy decoding 방식을 채택하여 생성의 반복성(repetitiveness)과 local-optimality에 갇히는 문제가 존재함.
- 단일 stochastic sampling 역시 무작위성으로 인해 출력의 신뢰도가 낮음.
- 핵심 직관(Intuition): 복잡한 문제일수록 다양한 사고 체계(reasoning paths)가 존재할 수 있으며, 서로 다른 경로들이 동일한 정답에 수렴할 때 그 답의 신뢰도가 가장 높음.
- Core Methodology: Self-Consistency
- 메커니즘: Sample-and-Marginalize
- Decoder sampling: CoT prompt가 주어진 상태에서 다수의 독립적인 reasoning paths를 sampling.
- Marginalization: 생성된 다양한 추론 과정을 주변화(marginalize out)하여 최종 도출된 답들 중 다수결 방식으로 가장 일관된 정답(most consistent answer)을 추출.
- 엔지니어링상 강점:
- Unsupervised & Plug-and-Play: 추가 human annotation, 별도 verifier 또는 re-ranker 학습, fine-tuning이 전혀 불필요.
- Self-Ensemble: 여러 모델을 학습시키는 전통적 ensemble과 달리, 단일 pre-trained language model 위에서 바로 구동됨.
- 메커니즘: Sample-and-Marginalize
- Key Empirical Results
- 검증 모델: UL2-20B, GPT-3-175B, LaMDA-137B, PaLM-540B 전반에 걸쳐 유의미한 성능 향상 확인.
- Arithmetic reasoning SOTA: GSM8K (+17.9%p), SVAMP (+11.0%p), AQuA (+12.2%p) 절대 정확도 향상.
- Commonsense reasoning: StrategyQA (+6.4%p), ARC-challenge (+3.9%p) 향상.
- 강건성(Robustness): 기존 연구에서 CoT 적용 시 오히려 성능이 하락했던 태스크에서도 방어 및 성능 향상을 보였으며, beam search, sample-and-rank, 다양한 sampling strategies 및 불완전한 prompts 대비 우수한 robustness 입증.
쉬운 설명 :
기존의 CoT 방식은 AI에게 "생각 과정을 단계별로 말해봐"라고 시킨 뒤, 모델이 매 순간 가장 확률이 높은 단어만 고르는 방식(greedy decoding)으로 딱 한 번만 풀게 했습니다. 이 방식은 중간에 모델이 엉뚱한 길로 빠지면 그대로 오답이 나오는 치명적인 약점이 있습니다.
Self-consistency는 사람이 어려운 수학 문제를 풀 때 쓰는 방법과 같습니다. 한 가지 방식으로만 풀고 끝내는 것이 아니라, 모델에게 약간의 무작위성을 주어 여러 가지 다양한 풀이 과정을 스스로 여러 번 만들어보게 합니다. 풀이 과정은 제각각 다를 수 있지만, 가장 많은 풀이 과정이 공통으로 가리킨 최종 정답을 다수결로 채택하는 방식입니다.
별도의 정답 채점기(verifier)를 따로 학습시키거나 모델을 추가로 튜닝할 필요 없이, 이미 완성된 단일 모델에 '다양하게 풀고 다수결로 고른다'는 전략만 추가하여 복잡한 추론 문제의 정답률을 크게 끌어올렸다는 점이 핵심입니다.
2 SELF-CONSISTENCY OVER DIVERSE REASONING PATHS
인간의 두드러진 특징 중 하나는 사람들이 서로 다르게 생각한다는 점입니다. 깊은 생각이 필요한 태스크에서는 문제에 접근하는 여러 가지 방식이 존재할 가능성이 높다고 가정하는 것은 자연스럽습니다. 우리는 이러한 과정이 language model의 decoder로부터 sampling하는 방식을 통해 language models 내에서 시뮬레이션될 수 있다고 제안합니다.
예를 들어 Figure 1에 나와 있듯이, model은 수학 question에 대해 모두 동일한 정답에 도달하는 그럴듯한 여러 개의 응답을 생성할 수 있습니다(Outputs 1 및 3). language models는 완벽한 reasoners가 아니기 때문에, 잘못된 reasoning path를 생성하거나 reasoning steps 중 하나에서 실수를 범할 수도 있지만(예: Output 2), 이러한 해결책들이 동일한 정답에 도달할 가능성은 더 낮습니다. 즉, 우리는 올바른 reasoning processes가 제아무리 다양할지라도, 잘못된 프로세스들에 비해 그들의 final answer에서 더 큰 일치도를 보이는 경향이 있다는 가설을 세웁니다.
우리는 다음과 같은 self-consistency 방식을 제안함으로써 이러한 직관을 활용합니다.
먼저, language model에 수작업으로 작성된 일련의 chain-of-thought exemplars를 prompting합니다. 다음으로, language model의 decoder로부터 일련의 후보 출력들을 sampling하여 다양한 후보 reasoning paths 세트를 생성합니다. Self-consistency는 temperature sampling, top-k sampling, 그리고 nucleus sampling을 포함한 대부분의 기존 sampling algorithms와 호환됩니다. 마지막으로, sampled reasoning paths를 marginalizing out하고 생성된 답변들 중 가장 일관된 답변을 선택하여 답변들을 집계합니다.
더 구체적으로 설명하면, 생성된 답변 $a_i$가 고정된 답변 세트 $a_i \in A$에 속한다고 가정합니다. 여기서 $i = 1, \dots, m$은 decoder로부터 sampling된 $m$개의 후보 출력들을 인덱싱합니다. prompt와 question이 주어지면, self-consistency는 $i$번째 출력에서의 reasoning path를 나타내는 token 시퀀스인 추가 잠재 변수 $r_i$를 도입한 다음, $r_i \to a_i$가 되는 $(r_i, a_i)$의 생성을 결합합니다. 즉, reasoning path $r_i$를 생성하는 것은 선택적이며 오직 final answer $a_i$에 도달하기 위해서만 사용됩니다.
예시로 Figure 1의 Output 3을 보면, 첫 몇 문장인 “She eats 3 for breakfast ... So she has 9 eggs * $2 = $18.”는 $r_i$를 구성하고, 마지막 문장 “The answer is $18”에서 추출된 답변 18은 $a_i$로 파싱됩니다. model의 decoder로부터 다수의 $(r_i, a_i)$를 sampling한 후, self-consistency는 $a_i$에 대한 다수결 투표, 즉 $\arg\max_a \sum_{i=1}^m \mathbf{1}(a_i = a)$를 취함으로써 $r_i$에 대한 marginalization을 적용하며, 이는 최종 답변 세트 중에서 가장 “일관된(consistent)” 답변으로 정의됩니다.
Table 1에서는 서로 다른 답변 집계 전략을 사용하여 일련의 reasoning 태스크에 대한 테스트 정확도를 보여줍니다. 다수결 투표 외에도, 답변을 집계할 때 각 $(r_i, a_i)$에 $P(r_i, a_i \mid \text{prompt}, \text{question})$으로 가중치를 부여할 수도 있습니다. $P(r_i, a_i \mid \text{prompt}, \text{question})$을 계산하기 위해, $(\text{prompt}, \text{question})$이 주어졌을 때 model이 $(r_i, a_i)$를 생성할 비정규화 확률을 취하거나, 조건부 확률을 출력 길이로 정규화할 수 있습니다:
여기서 $\log P(t_k \mid \text{prompt}, \text{question}, t_1, \dots, t_{k-1})$는 이전 tokens를 조건부로 하여 $(r_i, a_i)$ 내의 $k$번째 token $t_k$를 생성할 로그 확률이며, $K$는 $(r_i, a_i)$에 있는 tokens의 총 개수입니다.
Table 1에서 우리는 “비가중치 합(unweighted sum)”, 즉 $a_i$에 대해 직접 다수결 투표를 취하는 것이 “정규화된 가중치 합(normalized weighted sum)”을 사용하여 집계하는 것과 매우 유사한 정확도를 산출함을 보여줍니다. 우리는 model의 출력 확률들을 면밀히 살펴보았으며, 이는 각 $(r_i, a_i)$에 대해 정규화된 조건부 확률 $P(r_i, a_i \mid \text{prompt}, \text{question})$이 서로 상당히 가깝기 때문임을 발견했습니다. 즉, language model은 해당 생성 결과물들을 “비슷한 가능성을 가진 것”으로 간주합니다.
또한 답변을 집계할 때, Table 1의 결과는 “정규화된” 가중치 합(수식 1)이 비정규화된 가중치 합에 비해 훨씬 더 높은 정확도를 산출함을 보여줍니다. 완전성을 기하기 위해 Table 1에는 “가중 평균(weighted average)”, 즉 각 $a$가 자신의 가중치 합을 $\sum_{i=1}^m \mathbf{1}(a_i = a)$로 나눈 점수를 얻는 방식을 취한 결과도 보고했는데, 이는 훨씬 더 저조한 성능으로 이어졌습니다.
Self-consistency는 개방형 텍스트 생성과 고정된 답변을 갖는 최적의 텍스트 생성 사이의 흥미로운 영역을 탐구합니다. reasoning 태스크는 일반적으로 고정된 답변을 가지며, 이것이 연구자들이 일반적으로 greedy decoding 접근법을 고려해 온 이유입니다. 그러나 우리는 목표로 하는 정답이 고정되어 있을 때조차도 reasoning processes에 다양성을 도입하는 것이 매우 유익할 수 있음을 발견했습니다. 따라서 우리는 이러한 목표를 달성하기 위해 개방형 텍스트 생성에 흔히 사용되는 sampling 방식을 활용합니다.
유의해야 할 점은 self-consistency가 final answer가 고정된 답변 세트에 속하는 문제들에만 적용될 수 있다는 것이지만, 원칙적으로 복수의 생성 결과물 간에 일관성에 대한 좋은 메트릭(예: 두 답변이 서로 동의하는지 혹은 모순되는지 여부)을 정의할 수 있다면 이 접근법은 개방형 텍스트 생성 문제로도 확장될 수 있습니다.
Research Note: Section 2 (SELF-CONSISTENCY OVER DIVERSE REASONING PATHS)
- Core Premise & Hypothesis
- 사람이 어려운 문제를 풀 때 다양한 사고 경로를 거치는 것처럼, LLM의 디코더 샘플링을 통해 다채로운 추론 경로를 유도할 수 있음.
- 핵심 가설: 모델이 중간 단계에서 실수를 하더라도, 정답에 도달하는 유효한 추론 경로들은 서로 달라도 최종 답에서 일치(agreement)를 이룰 확률이 높지만, 오류 경로는 각기 다른 엉뚱한 답으로 분산될 확률이 높음.
- Formal Formulation
- 입력 및 변수 정의:
- 프롬프트와 질문에 대해 디코더로부터 $m$개의 후보 시퀀스를 독립 샘플링.
- 잠재 변수(Latent Variable) $r_i$: $i$번째 생성물에서 중간 추론 과정을 나타내는 토큰 시퀀스(Reasoning path).
- 결과 변수 $a_i \in A$: 해당 추론 경로 끝에서 파싱된 최종 답변(Final answer).
- Marginalization (집계 방식):
- 추론 과정 $r_i$를 주변화(marginalize out)하고 오직 최종 답 $a_i$에 대해 Majority Vote(최빈값 선택)를 적용:
-
$$\arg\max_a \sum_{i=1}^m \mathbf{1}(a_i = a)$$
- 호환성: 표준적인 Temperature, Top-k, Nucleus(top-p) 샘플링 등 기존 생성 알고리즘과 전부 호환됨.
- 입력 및 변수 정의:
- Aggregation Strategy Analysis (Table 1 인사이트)
- Majority Vote (Unweighted Sum) $\approx$ Length-normalized Weighted Sum:
- 각 경로의 생성 확률 $P(r_i, a_i \mid \text{prompt}, \text{question})$로 가중합을 적용해도 단순 다수결과 정확도 차이가 거의 없음.
- 원인: 디코더에서 샘플링된 유효 경로들의 토큰 길이 정규화 조건부 확률 값이 서로 매우 유사하여 모델 내부적으로 "비슷한 수준의 가능성"으로 간주하기 때문.
- Unnormalized vs Normalized:
- 가중치를 부여할 경우, 문장 길이($K$)로 나눈 정규화 확률(수식 1)을 써야 함. 비정규화 확률은 긴 추론 경로에 패널티가 커 성능이 크게 저하됨.
- Weighted Average의 실패:
- 빈도수($\sum \mathbf{1}(a_i = a)$)로 나누어 평균 점수를 매기면 다수결의 이점(빈도 가중 효과)이 상쇄되어 성능이 급락함.
- 실무적 결론: 복잡한 확률 계산 없이 단순 다수결(Majority Vote)만 취해도 충분히 최적의 성능을 냄.
- Majority Vote (Unweighted Sum) $\approx$ Length-normalized Weighted Sum:
- Conceptual Significance & Scope
- 기존 통념: 고정된 답을 요구하는 추론 태스크는 탐욕적 생성(Greedy decoding)이 표준적이었음.
- 역발상: 개방형 텍스트 생성에 쓰이던 Stochastic Sampling을 추론 문제에 도입하여 '사고의 다양성'을 확보한 뒤 집계하는 패러다임 제시.
- 한계 및 확장성: 현재 수식은 고정된 정답 셋($A$)을 전제하지만, 텍스트 간 논리적 일치/모순 여부를 판별하는 메트릭이 정의된다면 Open-ended 텍스트 생성으로 확장 가능함.
쉬운 설명 :
수학 주관식 문제를 풀 때, AI에게 정답을 딱 한 번만 단답형처럼 찍어내게 하는 대신 "여러 가지 방식으로 $m$번 자유롭게 풀어봐"라고 시킵니다.
풀이 과정($r_i$)은 사람마다 접근법이 다르듯 길이나 방식이 제각각일 수 있습니다. 중간에 계산 실수를 한 풀이들은 제각기 다른 엉뚱한 오답을 내놓겠지만, 올바르게 접근한 풀이들은 접근 방식이 서로 달라도 결국 똑같은 정답($a_i$)에 모이게 됩니다.
이 섹션의 수식과 실험이 말하고자 하는 핵심은 아주 단순합니다:
- 복잡하게 각 풀이 과정의 모델 확률값이나 가중치를 일일이 계산해서 더해줄 필요가 없다.
- 그냥 가장 많이 나온 최종 답을 단순 다수결(Majority Vote)로 뽑기만 해도 가장 정교한 수학적 가중치 계산과 똑같은 최고 성능이 나온다.
결국 '생각의 과정은 다양하게 열어두되, 최종 답은 가장 표가 많이 나온 것을 고른다'는 아이디어를 수식과 실험으로 증명한 파트입니다.
3 EXPERIMENTS
우리는 제안된 self-consistency 방식을 다양한 reasoning benchmarks에서 기존 접근법들과 비교하기 위해 일련의 실험을 수행했습니다. 그 결과, self-consistency가 광범위한 model scales에 걸쳐 고려된 모든 language model의 reasoning 정확도를 견고하게 향상시킨다는 점을 발견했습니다.
3.1 EXPERIMENT SETUP
Tasks and datasets. 우리는 다음의 reasoning benchmarks에서 self-consistency를 평가합니다.
- Arithmetic reasoning: 이러한 태스크들을 위해 AddSub, MultiArith, ASDiv를 포함하는 Math Word Problem Repository를 사용했습니다. 또한 AQUA-RAT, 최근 발표된 초등학교 수준 수학 문제 벤치마크인 GSM8K, 그리고 수학 서술형 문제에 대한 챌린지 데이터셋인 SVAMP를 포함했습니다.
- Commonsense reasoning: 이러한 태스크들을 위해 CommonsenseQA, StrategyQA, 그리고 AI2 Reasoning Challenge(ARC)를 사용했습니다.
- Symbolic Reasoning: 우리는 두 가지 symbolic reasoning 태스크를 평가합니다: 마지막 글자 연결(예: 입력이 “Elon Musk”이면 출력은 “nk”가 됨), 그리고 Coinflip(예: 동전의 앞면이 위로 향해 있을 때 몇 번 뒤집은 후에도 여전히 앞면이 위를 향하고 있는가?)입니다.
Language models and prompts. 우리는 다양한 크기를 가진 네 가지 transformer 기반 language models를 대상으로 self-consistency를 평가합니다:
- UL2: 20억(20B) 개의 파라미터를 가지며 다양한 denoisers의 혼합물로 trained된 encoder-decoder model입니다. UL2는 완전히 open-sourced되어 있으며 zero-shot SuperGLUE에서 GPT-3와 유사하거나 더 우수한 성능을 보이지만, 파라미터가 20B에 불과하여 연산 효율성이 훨씬 더 높습니다.
- GPT-3: 1750억(175B) 개의 파라미터를 가집니다. 재현성을 돕기 위해 Codex 시리즈의 공개 엔진인 code-davinci-001과 code-davinci-002 두 가지를 사용합니다.
- LaMDA-137B: 1370억(137B) 개의 파라미터를 가진 밀집 좌-우 방향 decoder-only language model로, 웹 문서, 대화 데이터 및 Wikipedia의 혼합물로 pre-trained되었습니다.
- PaLM-540B: 5400억(540B) 개의 파라미터를 가진 밀집 좌-우 방향 decoder-only language model로, 필터링된 웹페이지, 서적, Wikipedia, 뉴스 기사, 소스 코드 및 소셜 미디어 대화로 구성된 7800억 개의 tokens에 달하는 고품질 말뭉치로 pre-trained되었습니다.
우리는 language models를 training하거나 fine-tuning하지 않고, 모든 실험을 few-shot 환경에서 수행합니다. 공정한 비교를 위해 기존과 동일한 prompts를 사용합니다: 모든 arithmetic reasoning 태스크에 대해 수작업으로 작성된 동일한 8개의 exemplars 세트를 사용합니다. 각 commonsense reasoning 태스크에 대해서는 수작업으로 구성된 chain-of-thought prompts와 함께 training set에서 무작위로 추출된 4-7개의 exemplars를 사용합니다. 사용된 prompts에 대한 전체 세부 정보는 Appendix A.3에 나와 있습니다.
Sampling scheme. 다양한 reasoning paths를 sampling하기 위해, 우리는 개방형 텍스트 생성에 제안된 설정들과 유사한 방식을 따랐습니다. 구체적으로 UL2-20B 및 LaMDA-137B의 경우 $T = 0.5$로 temperature sampling을 적용하고 확률이 가장 높은 top-k ($k = 40$) tokens에서 잘라냈으며, PaLM-540B의 경우 $T = 0.7$, $k = 40$을 적용했고, GPT-3의 경우 top-k 절단 없이 $T = 0.7$을 사용했습니다. 우리는 self-consistency가 일반적으로 sampling strategies와 파라미터에 대해 강건함을 보여주기 위해 Section 3.5에서 ablation study를 제공합니다.
3.2 MAIN RESULTS
우리는 10회 실행에 걸쳐 평균을 낸 self-consistency의 결과를 보고하며, 각 실행마다 decoder로부터 40개의 출력들을 독립적으로 sampling했습니다. 우리가 비교하는 기준선(baseline)은 대규모 language models의 decoding에 기존에 사용되어 온 greedy decoding 기반의 chain-of-thought prompting(CoT-prompting으로 지칭)입니다.
Arithmetic Reasoning 결과는 Table 2에 나와 있습니다. self-consistency는 네 가지 모든 language models에 걸쳐 chain-of-thought prompting 대비 arithmetic reasoning 성능을 유의미하게 향상시킵니다.
더욱 놀라운 점은 language model의 크기가 커질수록 성능 향상 폭이 더 커진다는 것입니다. 예를 들어, UL2-20B에서는 +3%-6%의 절대 정확도 향상을 보이지만, LaMDA-137B 및 GPT-3에서는 +9%-23%의 향상을 보입니다. 대부분의 태스크에서 이미 높은 정확도를 달성하고 있는 대규모 모델(예: GPT-3 및 PaLM-540B)의 경우에도, self-consistency는 AQuA 및 GSM8K와 같은 태스크에서 +12%-18%, SVAMP 및 ASDiv에서 +7%-11%의 절대 정확도 향상이라는 상당한 추가 이득을 기여합니다.
self-consistency를 통해 우리는 거의 모든 태스크에서 새로운 state-of-the-art 결과를 달성합니다: self-consistency가 unsupervised 방식이며 태스크에 구애받지 않음(task-agnostic)에도 불구하고, 이러한 결과는 태스크별 training이나 수천 개의 예제를 통한 fine-tuning을 필요로 하는 기존 접근법들(예: GSM8K)과 비교해도 유리한 성능을 보여줍니다.
Commonsense and Symbolic Reasoning Table 3은 commonsense 및 symbolic reasoning 태스크에 대한 결과를 보여줍니다. 마찬가지로 self-consistency는 네 가지 모든 language models 전반에 걸쳐 큰 이득을 가져왔으며, 6개 태스크 중 5개에서 SoTA 결과를 획득했습니다.
symbolic reasoning의 경우, 입력 prompt에는 2글자 또는 2번 뒤집기 예제가 포함되어 있지만 4글자 및 4번 뒤집기 예제를 테스트하는 out-of-distribution(OOD) 설정을 테스트합니다(PaLM-540B나 GPT-3가 이미 완벽한 in-distribution 정확도를 달성할 수 있기 때문에 이 설정이 더 까다롭습니다). 이처럼 도전적인 OOD 설정에서도 충분한 모델 크기를 갖추었을 때 CoT-prompting과 비교하여 self-consistency의 향상 폭은 여전히 매우 컸습니다.
sampled reasoning paths의 수에 따른 영향을 보여주기 위해, Figure 2에서 다양한 수의 sampled paths(1, 5, 10, 20, 40)에 대한 정확도(10회 실행에 대한 평균 및 표준편차)를 플롯했습니다. 결과는 더 많은 수(예: 40개)의 reasoning paths를 sampling하는 것이 일관되게 더 나은 성능으로 이어짐을 보여주며, 이는 reasoning paths에 다양성을 도입하는 것의 중요성을 다시 한번 강조합니다. Table 4에서는 두 가지 태스크의 몇 가지 예시 questions를 통해 self-consistency가 greedy decoding에 비해 더 풍부한 reasoning paths 세트를 산출함을 보여줍니다.
3.3 SELF-CONSISTENCY HELPS WHEN CHAIN-OF-THOUGHT HURTS PERFORMANCE
기존 연구는 few-shot in-context learning에서 chain-of-thought prompting이 표준 prompting에 비해 때때로 성능을 저하시킬 수 있음을 보여줍니다. 여기서 우리는 다음을 포함하는 일련의 일반적인 NLP 태스크에서 self-consistency가 이러한 격차를 메우는 데 도움이 될 수 있는지 확인하기 위해 연구를 수행합니다: (1) Closed-Book Question Answering: BoolQ, HotpotQA, 그리고 (2) Natural Language Inference: e-SNLI, ANLI, RTE입니다.
PaLM-540B에 대한 결과는 Table 5에 나와 있습니다. 일부 태스크(예: ANLI-R1, e-SNLI, RTE)의 경우, chain-of-thought를 추가하는 것이 표준 prompting에 비해 실제로 성능을 저하시키지만, self-consistency는 성능을 견고하게 끌어올리고 표준 prompting을 능가할 수 있어, 일반적인 NLP 태스크를 위한 few-shot in-context learning에서 추론 근거(rationales)를 추가하는 신뢰할 수 있는 방법이 됩니다.
3.4 COMPARE TO OTHER EXISTING APPROACHES
우리는 일련의 추가 연구를 수행하여 self-consistency가 sample-and-rank, beam search, 그리고 ensemble 기반 접근 방식을 포함한 기존 방법들을 크게 능가함을 보여줍니다.
Comparison to Sample-and-Rank generation quality를 향상시키기 위해 널리 사용되는 접근 방식 중 하나는 sample-and-rank로, decoder로부터 다수의 시퀀스를 sampling한 다음 각 시퀀스의 로그 확률에 따라 순위를 매기는 방식입니다. 우리는 GPT-3 code-davinci-001에서 self-consistency와 동일한 수의 시퀀스를 decoder로부터 sampling하고 가장 높은 순위의 시퀀스로부터 final answer를 취함으로써 self-consistency를 sample-and-rank와 비교합니다.
결과는 Figure 3에 나와 있습니다. 추가로 sampling된 시퀀스와 순위 매기기를 통해 sample-and-rank의 정확도가 향상되기는 하지만, 그 이득은 self-consistency에 비해 훨씬 작습니다.
Comparison to Beam Search Table 6에서 우리는 UL2-20B 모델을 대상으로 self-consistency와 beam search decoding을 비교합니다. 공정한 비교를 위해 동일한 수의 beams 및 reasoning paths 하에서의 정확도를 보고합니다.
두 태스크 모두에서 self-consistency는 beam search를 크게 능가합니다. self-consistency 역시 각 reasoning path를 decode하기 위해 beam search를 채택할 수 있지만(“Self-consistency using beam search”로 결과 표기), 그 성능은 sampling을 사용한 self-consistency에 비해 떨어집니다. 그 이유는 beam search가 출력의 다양성을 낮추는 반면, self-consistency에서는 reasoning paths의 다양성이 더 나은 성능을 위한 핵심이기 때문입니다.
Comparison to Ensemble-based Approaches 우리는 few-shot learning을 위한 ensemble 기반 방법들과 self-consistency를 추가로 비교합니다. 특히 우리는 다음을 통한 ensembling을 고려합니다: (1) prompt order permutation: prompt 순서에 대한 모델의 민감도를 완화하기 위해 prompt 내의 exemplars를 40회 무작위로 치환합니다. 그리고 (2) multiple sets of prompts: 수작업으로 3개의 서로 다른 prompts 세트를 작성합니다. 우리는 두 접근 방식 모두에서 ensemble로서 greedy decoding의 답변들에 대해 다수결 투표를 취했습니다.
Table 7은 기존의 ensemble 기반 접근 방식들이 self-consistency에 비해 훨씬 더 작은 향상 폭을 달성함을 보여줍니다.
또한 self-consistency는 여러 모델을 training하고 그 출력을 집계하는 일반적인 model-ensemble 접근 방식과 다릅니다. self-consistency는 단일 language model 상에서 구동되는 “self-ensemble”에 가깝게 작동합니다. 우리는 부록 A.1.3에 여러 모델을 ensembling한 결과를 추가로 제시하였으며, 해당 model-ensembles는 self-consistency에 비해 훨씬 저조한 성능을 보였습니다.
3.5 ADDITIONAL STUDIES
우리는 sampling strategies 및 파라미터에 대한 강건성, 그리고 불완전한 prompts 및 비자연어 reasoning paths에서 이것이 어떻게 작동하는지를 포함하여 self-consistency 방식의 다양한 측면을 분석하기 위해 많은 수의 추가 실험을 수행했습니다.
Self-Consistency is Robust to Sampling Strategies and Scaling 우리는 Figure 4 (왼쪽)에서 PaLM-540B를 대상으로 temperature sampling의 $T$, top-k sampling의 $k$, 그리고 nucleus sampling의 $p$를 다양하게 변경함으로써 self-consistency가 sampling strategies 및 파라미터에 강건함을 보여줍니다.
Figure 4 (오른쪽)은 self-consistency가 LaMDA-137B 모델 시리즈의 모든 규모에 걸쳐 성능을 견고하게 향상시킴을 보여줍니다. 특정 능력(예: 산술)은 모델이 충분한 규모에 도달했을 때만 발현되기 때문에 더 작은 모델에서는 이득이 상대적으로 낮습니다.
Self-Consistency Improves Robustness to Imperfect Prompts 수작업으로 구성된 prompts를 사용하는 few-shot learning의 경우, 인간 작업자는 prompts를 생성할 때 때때로 사소한 실수를 저지릅니다. 우리는 self-consistency가 불완전한 prompts에 대한 language model의 강건성을 향상시키는 데 도움이 될 수 있는지 추가로 연구합니다.
결과는 Table 8에 나와 있습니다: 불완전한 prompts는 greedy decoding을 사용할 때 정확도를 떨어뜨리지만($17.1 \to 14.9$), self-consistency는 그 간극을 메우고 결과를 견고하게 개선할 수 있습니다.
또한 우리는 최종 집계된 답변에 동의하는 decodes의 비율 측면에서 consistency가 정확도와 높은 상관관계가 있음을 발견했습니다(GSM8K 대상 Figure 5). 이는 self-consistency를 사용하여 생성된 솔루션에 대한 모델의 불확실성 추정치(uncertainty estimate)를 제공할 수 있음을 시사합니다. 즉, 낮은 consistency를 모델의 신뢰도가 낮다는 지표로 사용할 수 있으며, 이는 self-consistency가 모델로 하여금 “자신이 언제 알지 못하는지를 알 수 있는” 능력을 일정 부분 부여함을 의미합니다.
Self-Consistency Works for Non-Natural-Language Reasoning Paths and Zero-shot CoT 우리는 수식과 같은 대안적인 형태의 중간 추론(예: “주차장에 이미 차가 3대 있습니다. 2대가 더 옵니다. 이제 $3 + 2 = 5$대의 차가 있습니다.”에서 “$3 + 2 = 5$”로 변경)에 대해서도 self-consistency 개념의 일반성을 테스트했습니다.
결과는 Table 8(“Prompt with equations”)에 나타나 있습니다: self-consistency는 중간 수식을 생성함으로써 여전히 정확도를 향상시킵니다. 그러나 자연어 reasoning paths를 생성하는 것과 비교할 때, 수식이 훨씬 더 짧고 decoding process에서 다양성을 생성할 수 있는 여지가 적기 때문에 그 이득은 더 작습니다.
또한 우리는 zero-shot chain-of-thought에 self-consistency를 테스트했으며, Table 8에서 self-consistency가 zero-shot CoT에서도 잘 작동하고 결과를 크게 향상(+26.2%)시킴을 보여줍니다.
Research Note: Section 3 (EXPERIMENTS)
- Experimental Setup & Baselines
- Evaluation Suite:
- Arithmetic: AddSub, MultiArith, ASDiv, AQUA-RAT, GSM8K, SVAMP.
- Commonsense: CommonsenseQA, StrategyQA, ARC.
- Symbolic Reasoning: Last letter concatenation, Coinflip (4-letter / 4-flip의 Out-Of-Distribution 환경으로 난이도 강화).
- General NLP: BoolQ, HotpotQA, e-SNLI, ANLI, RTE.
- Evaluated Models: UL2-20B, GPT-3-175B (code-davinci-001/002), LaMDA-137B, PaLM-540B.
- Sampling Details: 기본 40개 경로 독립 샘플링 $\times$ 10회 반복 평균 측정. (UL2/LaMDA: $T = 0.5, k = 40$ / PaLM: $T = 0.7, k = 40$ / GPT-3: $T = 0.7$, non-truncated).
- Baseline: Greedy decoding 기반 Chain-of-Thought (CoT-prompting).
- Evaluation Suite:
- Key Findings & Performance Dynamics
- Model Scale에 따른 Gain 가속화:
- 소형 모델(UL2-20B: +3%~6%p)보다 대형 모델(LaMDA, GPT-3: +9%~23%p)에서 성능 폭증. 추론 능력이 발현되는 스케일 임계점 이상에서 Self-Consistency(SC)의 시너지가 극대화됨.
- PaLM-540B/GPT-3 기준 SOTA 갱신: GSM8K (+17.9%p), SVAMP (+11.0%p), AQuA (+12.2%p). 태스크별 파인튜닝 모델을 No-tuning 및 Unsupervised 세팅으로 압도.
- Sampling Path 수 비례 효과: 샘플링 경로를 1개에서 40개로 늘릴수록 단조 증가(monotonic increase) 형태로 성능 향상. 다양성 확보가 핵심 변수임이 입증됨.
- CoT 병목 현상 치유 (Defending Performance Drops):
- 기존 연구(Ye & Durrett, 2022)에서 NLI(e-SNLI, ANLI 등)에 CoT를 적용하면 오히려 Standard Prompting보다 정확도가 떨어지던 현상 발생.
- SC는 이 하락분을 완벽히 방어하고 Standard Prompting 이상의 성능으로 역전시킴.
- Model Scale에 따른 Gain 가속화:
- Comparative Ablations (대안 기법들과의 비교 우위)
- vs. Sample-and-Rank (Log-prob 기반): 단순 최상위 확률 시퀀스를 뽑는 방식보다 SC의 다수결 marginalization이 압도적으로 우수.
- vs. Beam Search: 동일 Beam/Path 조건에서 SC(Sampling) > Beam Search. SC에 Beam Search를 결합하면 다양성이 급감하여 오히려 성능 저하. 다양성(Diversity)이 핵심 동력임.
- vs. Traditional Ensembling: 프롬프트 순서 무작위 셔플링(40회)이나 다중 프롬프트 작성 후 앙상블보다, 단일 프롬프트 기반의 "디코더 경로 다양화(Self-Ensemble)"가 월등히 높은 게인을 기록.
- Robustness & Secondary Utilities
- Uncertainty Estimation (신뢰도 추정): 정답 일치도(Consistency %)가 실제 정답률과 강한 양의 상관관계를 가짐. 모델이 모르는 문제를 판별하는 내장 신뢰도(Confidence/Uncertainty) 지표로 전용 가능.
- Prompt Imperfection 방어: 프롬프트에 인간의 사소한 오타나 오류가 있어도 Greedy($17.1 \to 14.9$)와 달리 SC는 성능 하락을 견고하게 보정.
- Zero-shot CoT & Non-NL Expansion:
- Zero-shot CoT("Let's think step by step") 환경에서도 +26.2%p 급등.
- 자연어 추론 대신 단축 수식("3+2=5")만 생성하게 할 경우, 시퀀스가 짧아져 디코딩 다양성이 줄어들므로 게인이 상대적으로 감소함.
쉬운 설명 :
이 섹션은 저자들이 온갖 모델, 온갖 데이터셋, 온갖 비교군을 총동원해 "이 방법이 진짜 압도적인가?"를 검증한 거대한 증명서입니다.
- 모델이 클수록 포텐이 터집니다: 머리가 작은 모델보다, 원래 똑똑한 대형 모델(GPT-3, PaLM)에 이 기법을 붙였을 때 효과가 훨씬 컸습니다. 수천 개 데이터로 특별 훈련을 시킨 전용 모델들보다, 훈련 한 번 안 시킨 순정 대형 모델에 다수결 전략만 얹은 게 점수가 더 잘 나왔습니다.
- 다른 잔기술을 다 이겼습니다:
- "가장 확률 높은 문장 하나만 고르기(Beam Search, Sample-and-Rank)"는 오히려 다양한 생각을 방해해서 성능이 떨어졌습니다.
- "프롬프트를 여러 버전으로 써서 앙상블하기"보다 그냥 "프롬프트 하나 두고 모델 스스로 여러 갈래로 풀게 하기"가 훨씬 강력했습니다.
- '내가 모른다는 것을 아는' 능력이 생깁니다: 모델이 40번 풀었을 때 38번이 같은 답을 냈다면 진짜 정답일 확률이 매우 높고, 표가 중구난방으로 갈렸다면 모델 스스로 헷갈려한다는 뜻입니다. 즉, 투표 일치율 자체가 모델의 확신도(신뢰도) 역할을 해줍니다.
- 대충 쓴 프롬프트도 살려냅니다: 사람이 예시 문제에 약간 실수를 적어두었거나, 단순히 "차근차근 생각해봐(Zero-shot)"라고만 시켜도 흔들리지 않고 높은 정답률을 뽑아냈습니다.