
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- #삼립수박샌드 #수박샌드 #삼립신상 #삼립빵 #신상빵 #편의점신상 #편의점빵 #편의점디저트 #세븐일레븐신상 #세븐일레븐빵 #편의점간식 #신상과자리뷰 #신상리뷰 #수박맛 #수박맛빵 #수박바맛 #수박디저트 #여름간식 #여름디저트 #크림샌드 #크림카스테라 #카스테라 #빵리뷰 #간식추천 #편의점추천
- ing
- put
- 영어학습법
- IS
- 딥시크
- deekseek
- 김원스쿨
- 자리의힘
- GPT
- 5형식
- be to 부정사
- #뱅크시 #뱅크시전시 #뱅크시전시회 #뱅크시서울전시 #뱅크시스틸히어 #BANKSY #BANKSYSTILLHERE #더현대뱅크시 #더현대서울뱅크시 #더현대서울전시 #더현대전시 #더현대전시회 #더현대서울ALT1 #ALT1 #현대백화점전시 #서울전시 #서울전시회 #서울전시추천 #서울전시회추천 #서울미술전시 #서울미술관 #서울가볼만한곳 #서울실내데이트 #서울데이트 #서울데이트코스 #서울데이트추천 #여의도전시 #여의도데이트 #여의도가볼만한곳 #여의도데이트코스 #
- 0528
- TO
- TO 부정사
- \
- 중국AI
- AS
- Into
- From
- 자리
- Today
- Total
AI바라기의 인공지능
LLM : 빠른 논문 리뷰 : Chain-of-Thought Prompting Elicits Reasoning in Large Language Models 본문
LLM : 빠른 논문 리뷰 : Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
AI바라기 2026. 9. 14. 14:48용어 설명 (Terminology)
- Chain-of-Thought (CoT): 복잡한 추론 문제를 해결하기 위해 최종 정답에 도달하기 전 모델이 생성하는 일련의 중간 자연어 추론 단계(intermediate natural language reasoning steps).
- Standard Prompting: 모델에 몇 가지 예시를 제시할 때 질문과 최종 정답의 쌍(⟨input, output⟩)만으로 프롬프트를 구성하는 전통적인 few-shot 방식.
- Chain-of-Thought Prompting: Few-shot 프롬프트의 각 exemplar에 문제 해결을 위한 중간 추론 과정을 추가하여 ⟨input, chain of thought, output⟩ 형태의 트리플 구조로 모델을 유도하는 기법.
- Emergent Ability: 소형 모델에서는 전혀 나타나지 않거나 오히려 성능을 저하시키다가, 특정 임계 규모(약 100B 파라미터 이상)에 도달했을 때 급격히 발현되는 대형 언어 모델의 고유 능력.
- Out-of-Domain (OOD) Length Generalization: 프롬프트 예시(exemplar)에서 보여준 단계 수보다 실제 추론 시점에 더 긴 단계의 입력을 마주했을 때 모델이 일반화하여 문제를 해결해 내는 능력.
- External Calculator: 모델이 추론 중간에 생성한 수식을 Python의 eval 함수 등으로 전달하여 순수 산술 연산 오류를 보정하는 외부 연산 도구.
Purpose of the Paper
- 기존 연구의 한계 극복:
- 모델 파라미터 규모를 단순히 확장(scaling up)하는 것만으로는 산술, 상식, 기호 추론과 같은 복잡한 multi-step reasoning 과제의 성능 개선에 한계가 있었음.
- 기존의 중간 rationale 생성 기법은 모델을 처음부터 학습(train from scratch)하거나 대규모 rationale 데이터셋을 구축해 fine-tuning해야 하는 막대한 비용 문제가 존재했음.
- 기존 표준 few-shot prompting(Brown et al., 2020)은 단순 QA에는 효과적이었으나 추론 과제에서는 모델 크기를 키워도 평평한 스케일링 곡선(flat scaling curve)을 보임.
- 새로운 접근 방식 제시:
- 별도의 파라미터 업데이트(gradient update)나 대규모 데이터셋 구축 없이, 단 몇 개의 CoT 예시만 프롬프트에 포함하는 Chain-of-Thought Prompting을 제안함.
- 고정된 사전 학습 모델(off-the-shelf LLM)이 자연어로 중간 계산 과정을 전개한 뒤 최종 정답을 도출하도록 유도하여 LLM의 잠재된 추론 능력을 unlock하고자 함.
Key Contributions & Novelty
- Chain-of-Thought Prompting 방법론 제안:
- 프롬프트를 ⟨input, chain of thought, output⟩ 구조로 구성하여 모델이 문제를 하위 단계로 분해하고 추가적인 연산 자원(computation token)을 할당할 수 있도록 설계함.
- Reasoning이 Model Scale의 Emergent Ability임을 입증:
- 소형 모델(10B 미만)에서는 CoT가 유창하지만 비논리적인 추론을 생성해 오히려 standard prompting보다 낮은 성능을 기록함.
- 오직 약 100B 이상의 대규모 모델(PaLM 540B, GPT-3 175B 등)에서만 CoT를 통한 비약적인 성능 향상이 일어남을 실험적으로 규명함.
- 다양한 Reasoning 도메인에 걸친 범용성 검증:
- Arithmetic reasoning(GSM8K, SVAMP, ASDiv, AQuA, MAWPS)뿐 아니라 Commonsense reasoning(CSQA, StrategyQA, Date/Sports Understanding, SayCan), Symbolic reasoning(Last letter concatenation, Coin flip) 전반에서 CoT의 효과를 입증함.
- Zero-Parameter Fine-tuning으로 Supervised SOTA 갱신:
- 단 한 번의 gradient update 없이, 오직 8개의 CoT 예시만을 프롬프트로 제공한 PaLM 540B 모델을 통해 GSM8K에서 verifier를 적용한 fine-tuned GPT-3 175B를 능가하는 결과를 달성함.
- Symbolic OOD Length Generalization 입증:
- 프롬프트에서 더 적은 단계의 조작(예: 2개 단어/동전 던지기)만 관찰했음에도 불구하고, 평가 시 더 긴 단계(3~4단계)의 OOD 과제에서도 스케일 업에 따른 성공적인 성능 향상을 입증함.
Novelty Comparison
| 구분 | Rationale-augmented Fine-tuning (기존) | Standard Few-shot Prompting (기존) | Chain-of-Thought Prompting (본 논문) |
| 추론 방식 | 모델 가중치 업데이트를 통한 학습 | 직접 정답 생성 (⟨input, output⟩) | 중간 자연어 사고 전개 후 정답 생성 |
| 추가 비용 | 대규모 Rationale 라벨링 및 학습 비용 필요 | 없음 (In-context) | 없음 (수동 작성된 소수의 Exemplar만 사용) |
| 적용 범위 | 특정 task 한정 체크포인트 생성 | 광범위하나 Reasoning 과제에서 실패 | 모델 가중치 변경 없이 다양한 Reasoning 과제 해결 |
| 해석 가능성 | 생성된 Rationale에 따라 상이 | 블랙박스 형태로 추론 과정 확인 불가 | 정답 도출 경로 및 에러 발생 위치 디버깅 가능 |
Experimental Highlights
- Arithmetic Reasoning:
- GSM8K: PaLM 540B 기준 standard prompting 17.9%에서 CoT 적용 시 **56.9%**로 급상승. 이는 기존 fine-tuned GPT-3 175B + verifier 기록(55%)을 순수 프롬프팅만으로 초과 달성한 성과임 (Codex 역시 19.7%에서 63.1%로 상승).
- SVAMP: PaLM 540B 기준 69.4%에서 79.0% 달성 (prior best 57.4%).
- External Calculator 결합: 계산 실수만 교정해 주는 Python eval 함수 연동 시 PaLM 540B의 GSM8K 정확도는 58.6%, SVAMP는 79.8%, MAWPS는 **93.5%**까지 추가 상승.
- Commonsense & Symbolic Reasoning:
- StrategyQA: PaLM 540B 기준 68.6%에서 **77.8%**로 상승하여 기존 지도학습 SOTA(69.4%) 갱신.
- Sports Understanding: PaLM 540B에서 **95.4%**를 기록하며 스포츠 전문가(human baseline: 84.0%)의 성능을 상회함.
- Symbolic Length Generalization: Last letter concatenation OOD(4단어)에서 standard prompting은 0.0%였으나, PaLM 540B CoT는 **63.0%**를 기록함.
- Ablation Studies (효과의 독립성 증명):
- Equation only: GSM8K와 같이 의미 구조가 복잡한 문제에서는 수식만 직접 유도하도록 유도했을 때 성능 향상이 미미함 (자연어 reasoning step이 필수적임).
- Variable compute only: 토큰 수(연산량)만 늘리기 위해 마침표(...)를 출력하게 한 설정은 baseline과 성능 차이가 없음 (단순 연산량 증가가 아닌 논리적 언어 표현이 핵심임).
- Reasoning after answer: 최종 정답을 먼저 출력하고 추론 과정을 뒤에 출력하게 한 경우 baseline 수준으로 복귀함 (정답 도출 전 순차적 추론 생성이 실제 결정에 기여함을 증명).
- Robustness:
- 작성자(Annotator A, B, C)의 작성 스타일 차이, GSM8K 무작위 추출 exemplar, exemplar 개수 변화(1, 2, 4, 6, 8개), exemplar 순서 셔플링 등 다양한 조건에서도 baseline 대비 확고한 우위를 유지함.
Limitations and Future Work
- 신경망의 실제 '추론' 여부 미확인:
- CoT가 인간의 사고 과정을 모방하지만, 모델이 실제로 인간처럼 논리적 사고를 수행하는지, 혹은 복잡한 패턴을 모방하는 것인지 근본적인 메커니즘은 미해결 과제로 남음.
- Factuality 및 Hallucination의 비보장:
- CoT 경로가 항상 논리적 정합성이나 사실성을 담보하지 않음. 그럴듯한 오류(fluent but incorrect reasoning)를 생성하거나 우연히 정답만 맞히는 현상(correct by chance)이 발생함.
- Future Work: Reasoning path 생성을 다각화하고 이를 검증하는 verifier 도입 또는 factual generation 제어 기법 연구 필요.
- 소형 모델에 대한 비효율성 및 대규모 서빙 비용:
- CoT 능력은 100B급 이상의 초대형 모델에서만 발현되므로 실제 프로덕션 환경에서 실시간 서빙 시 계산 비용과 지연 시간(latency)이 매우 큼.
- Future Work: 소형 언어 모델(smaller LMs)에서도 CoT와 같은 multi-step reasoning을 유도하거나 증류(distillation)할 수 있는 방법론 탐색.
- 수동 프롬프트 엔지니어링 의존도:
- 전반적으로 강건(robust)하지만, 일부 복잡한 과제(예: 리스트 역순 정렬)에서는 프롬프트 작성 방식에 따라 성능 편차가 크게 나타남.
- Future Work: LLM 자체를 활용해 최적의 CoT 프롬프트를 자동으로 생성 및 튜닝하는 연구 필요.
Overall Summary
이 논문은 복잡한 다단계 추론 문제를 해결하기 위해 모델이 중간 사고 과정을 자연어로 먼저 생성하도록 유도하는 Chain-of-Thought Prompting을 제안했습니다. 이 기법은 별도의 모델 가중치 학습 없이 오직 몇 개의 exemplar만으로 산술, 상식, 기호 추론 전반에서 SOTA 성능을 갱신했으며, 모델 규모가 약 100B 이상일 때 비로소 발현되는 emergent ability임을 입증했습니다. 결과적으로 대규모 언어 모델의 역량 측정에서 standard prompting이 하한선(lower bound)만을 보여주고 있었음을 지적하며, 향후 자연어 기반 추론 연구의 패러다임을 프롬프트 설계 중심으로 확장한 핵심 논문입니다.
쉬운 설명
이 논문은 시험 문제를 풀 때 학생에게 **"단답형으로 정답만 바로 적어라"**고 강요하는 대신, **"연습장에 풀이 과정을 한 줄씩 차근차근 적어가면서 풀어라"**고 유도하는 것과 같습니다.
초등학생 수준의 작은 모델은 풀이 과정을 쓰라고 하면 오히려 횡설수설하다가 오답을 내지만, 지식이 충분히 쌓인 대형 모델은 스스로 적어 내려가는 풀이 과정(중간 생각) 덕분에 이전 계산 결과를 바탕으로 다음 계산을 차례차례 해결하여, 혼자서는 풀지 못했을 아주 복잡한 문제도 완벽하게 정답을 찾아내게 됩니다.
Abstract
우리는 일련의 중간 reasoning 단계인 chain of thought를 generation하는 것이 large language models가 복잡한 reasoning을 수행하는 능력을 어떻게 유의미하게 향상시키는지 탐구합니다. 특히, prompting 과정에서 소수의 chain of thought demonstration을 exemplar로 제공하는 chain-of-thought prompting이라는 간단한 method를 통해, 충분히 큰 large language models에서 이러한 reasoning 능력이 자연스럽게 발현(emerge)됨을 보여줍니다.
세 가지 large language models에 대한 experiment 결과, chain-of-thought prompting은 다양한 arithmetic, commonsense, symbolic reasoning task 전반에서 performance를 향상시키는 것으로 나타났습니다. 이러한 실증적 이득은 매우 두드러집니다. 예를 들어, 단 8개의 chain-of-thought exemplar만으로 PaLM 540B를 prompting했을 때 수학 word problem benchmark인 GSM8K에서 state-of-the-art accuracy를 달성하며, verifier를 적용하여 finetuned된 GPT-3마저 능가했습니다.
1 Introduction
최근 NLP 분야는 language models에 의해 혁신을 맞이했습니다. language models의 size를 scaling up하는 것은 향상된 performance 및 sample efficiency와 같은 다양한 이점을 제공하는 것으로 입증되었습니다. 그러나 model size를 scaling up하는 것만으로는 arithmetic, commonsense, symbolic reasoning과 같은 까다로운 task에서 높은 performance를 달성하기에 충분하지 않은 것으로 나타났습니다.
본 연구에서는 두 가지 idea에서 착안한 간단한 method를 통해 large language models의 reasoning 능력을 어떻게 이끌어낼 수 있는지를 탐구합니다. 첫째, arithmetic reasoning 기술은 최종 answer로 이어지는 natural language rationale을 generation함으로써 도움을 얻을 수 있습니다. 이전 연구에서는 natural language 대신 형식 언어를 사용하는 neuro-symbolic methods뿐만 아니라, scratch부터 training하거나 pretrained model을 finetuning하여 model에 중간 단계의 natural language를 generation하는 능력을 부여해 왔습니다. 둘째, large language models는 prompting을 통한 in-context few-shot learning이라는 흥미로운 가능성을 제공합니다. 즉, 각 새로운 task마다 별도의 language model checkpoint를 finetuning하는 대신, task를 보여주는 소수의 input-output exemplar로 model을 간단히 prompting할 수 있습니다. 주목할 점은, 이것이 다양한 단순 question-answering task에서 성공적이었다는 것입니다.
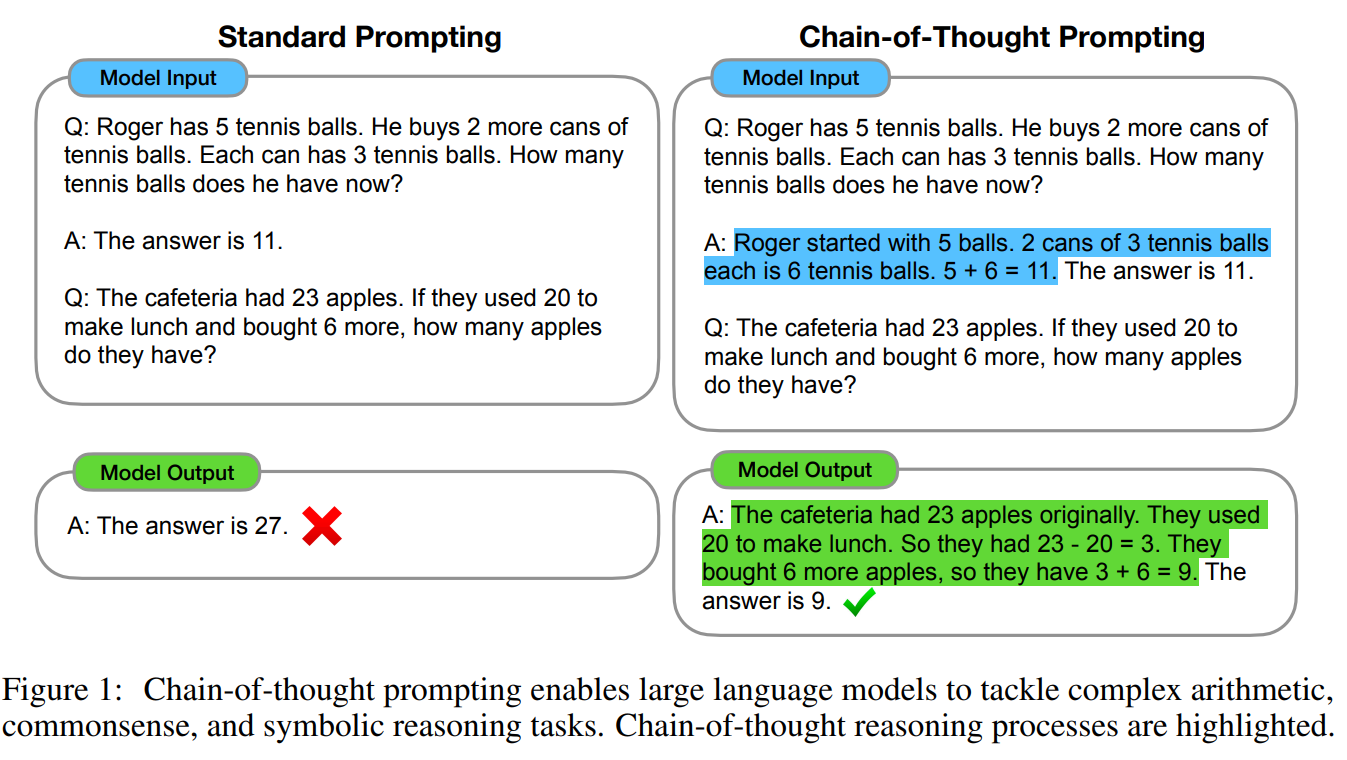
하지만 위의 두 가지 idea 모두 주요한 limitation을 가지고 있습니다. rationale-augmented training 및 finetuning methods의 경우, 고품질 rationale을 대규모로 구축하는 데 많은 비용이 들며, 이는 일반적인 machine learning에서 사용되는 단순한 input-output pair보다 훨씬 복잡합니다. 기존의 few-shot prompting method의 경우, reasoning 능력을 요구하는 task에서는 효과가 미흡하며, language model scale을 늘리더라도 크게 향상되지 않는 경우가 많습니다. 본 논문에서는 이러한 limitation을 피하면서 두 idea의 장점을 결합합니다. 구체적으로, 우리는 $\langle\text{input}, \text{chain of thought}, \text{output}\rangle$의 3요소로 구성된 prompt가 주어졌을 때 language models가 reasoning task에 대해 few-shot prompting을 수행하는 능력을 탐구합니다. chain of thought는 최종 output으로 이어지는 일련의 중간 natural language reasoning 단계들이며, 우리는 이 접근 방식을 chain-of-thought prompting이라고 부릅니다. 예시 prompt는 Figure 1에 나와 있습니다.
우리는 arithmetic, commonsense, symbolic reasoning benchmarks에 대한 실증적 evaluation을 제시하며, chain-of-thought prompting이 standard prompting보다 우수한 performance를 보이고 때로는 그 차이가 매우 두드러짐을 확인합니다. Figure 2는 이러한 결과 중 하나를 보여줍니다. 수학 word problem benchmark인 GSM8K에서, PaLM 540B를 사용한 chain-of-thought prompting은 큰 격차로 standard prompting을 능가하며 새로운 state-of-the-art performance를 달성합니다. prompting 전용 접근 방식은 대규모 training dataset을 필요로 하지 않으며, 단일 model checkpoint로 일반성을 잃지 않은 채 많은 task를 수행할 수 있다는 점에서 중요합니다. 본 연구는 large language models가 task에 대한 natural language data를 담은 소수의 example을 통해 어떻게 학습할 수 있는지를 강조합니다(대규모 training dataset을 통해 input과 output 밑바탕에 깔린 pattern을 자동으로 학습하는 것과 대비됨).
Core Research Problem
- Scaling-law의 한계: 모델 파라미터 확장(scaling up)은 일반적인 task 성능과 sample efficiency를 향상시키지만, arithmetic, commonsense, symbolic reasoning 같은 다단계 추론 task 해결에는 모델 크기 증대만으로 명확한 한계가 존재함.
Motivation & Limitations of Prior Approaches
- Rationale Generation (중간 추론 과정 생성)
- 선행 방식: Scratch 학습 또는 사전학습 모델 fine-tuning, 혹은 formal language 기반 neuro-symbolic 방식.
- 한계: 대규모 고품질 rationale 데이터셋 구축 비용이 매우 높음.
- In-Context Few-Shot Prompting
- 선행 방식: 별도 파라미터 업데이트 없이 소수의 input-output 예시를 제공하는 표준 prompting.
- 한계: 복잡한 reasoning task에서 성능이 저조하며, 모델 스케일을 키워도 성능 향상 폭이 미미함.
Proposed Method: Chain-of-Thought (CoT) Prompting
- 핵심 메커니즘: 두 접근법의 한계를 상쇄하고 장점만 결합.
- Triplet 구조: 기존 쌍 대신 형태의 퓨샷 예시를 context로 제공.
- 정의: 최종 output 도출을 위해 자연어(natural language)로 작성된 일련의 중간 추론 단계.
Key Contributions & Implications
- 성능 실증: GSM8K(수학 문장제 문제) 벤치마크에서 PaLM 540B 모델에 8개의 CoT 예시만 적용하여 verifier를 사용한 fine-tuned GPT-3를 제치고 SOTA 달성.
- 효율성 및 범용성: 파라미터 가중치를 수정하는 fine-tuning 없이 단일 체크포인트로 추론 task를 즉각 일반화(generalization) 가능. 대규모 학습 데이터 구축 비용 배제.
- 학습 패러다임 전환: 대규모 입출력 데이터의 패턴을 파라미터로 암기하는 방식 대신, 소수의 자연어 추론 과정을 통해 모델이 추론 경로를 따라가도록 유도.
쉬운 설명 :
기존 AI 모델들은 덩치를 아무각도로 키워도 복잡한 수학 문제나 상식 추론 문제 앞에서는 쩔쩔맸습니다.
이전에는 이를 해결하려고 모델에게 "풀이 과정"을 일일이 가르치며 재학습(fine-tuning)시키거나, 문제와 정답만 몇 개 던져주는 방식(few-shot)을 썼습니다. 하지만 전자는 풀이 과정을 대량으로 만드느라 품이 너무 많이 들었고, 후자는 생각할 시간을 주지 않고 정답만 요구하니 어려운 문제에서 제대로 맞히지 못했습니다.
본 논문이 제시한 아이디어는 아주 단순합니다. 모델을 새로 학습시킬 필요 없이, 질문을 던질 때 "문제 - 중간 풀이 과정(Chain of Thought) - 정답" 형태로 딱 몇 개의 예시만 보여주는 것입니다. 사람이 복잡한 문제를 풀 때 머릿속으로 단계별로 생각하며 풀듯이, AI에게도 "생각의 흐름"을 거쳐 답을 내도록 유도한 것입니다.
그 결과, 모델 파라미터를 단 하나도 수정하지 않고도 거대 모델(PaLM 540B)이 수학 문장제 문제에서 기존의 고난도 맞춤형 학습 모델들을 제치고 최고 성능을 기록했습니다.
2 Chain-of-Thought Prompting
다단계 수학 word problem과 같은 복잡한 reasoning task를 해결할 때 자신의 사고 과정을 떠올려 보십시오. 문제를 중간 단계들로 decompose하고, 최종 answer를 내놓기 전에 각 단계를 먼저 해결하는 것이 일반적입니다. "Jane이 엄마에게 꽃 2송이를 준 뒤에는 10송이가 남고... 그 후 아빠에게 3송이를 주면 7송이가 남을 것이므로... 정답은 7이다." 본 논문의 goal은 language models에 유사한 chain of thought—문제의 최종 answer로 이어지는 일관된 일련의 중간 reasoning 단계들—를 generation하는 능력을 부여하는 것입니다. 우리는 few-shot prompting의 exemplar에 chain-of-thought reasoning demonstration이 제공될 경우, 충분히 큰 large language models가 chain of thought를 generation할 수 있음을 보여줄 것입니다.
Figure 1은 model이 chain of thought를 생성하여, 그렇지 않았으면 틀렸을 수학 word problem을 해결하는 예시를 보여줍니다. 이 경우 chain of thought는 풀이(solution)와 유사하며 그렇게 해석될 수도 있지만, answer에 도달하기 위한 단계별 사고 과정을 모방한다는 idea를 더 잘 담아내기 위해 우리는 여전히 이를 chain of thought라고 부르기로 선택했습니다(또한, solution이나 explanation은 일반적으로 최종 answer 뒤에 오기도 합니다).
Chain-of-thought prompting은 language models의 reasoning을 촉진하기 위한 접근법으로서 몇 가지 매력적인 특성을 가지고 있습니다.
- 첫째, chain of thought는 원칙적으로 model이 다단계 문제를 중간 단계들로 decompose할 수 있게 해주며, 이는 더 많은 reasoning 단계를 필요로 하는 문제에 추가적인 computation을 할당할 수 있음을 의미합니다.
- 둘째, chain of thought는 model의 behavior에 대한 해석 가능한 창(interpretable window)을 제공하여, model이 특정 answer에 어떻게 도달했을지 시사하고 reasoning 경로의 어느 부분에서 오류가 발생했는지 디버깅할 수 있는 기회를 제공합니다(비록 answer를 뒷받침하는 model의 computation을 완벽하게 규명하는 것은 여전히 미해결 과제로 남아 있지만).
- 셋째, chain-of-thought reasoning은 수학 word problem, commonsense reasoning, symbolic manipulation과 같은 task에 사용될 수 있으며, 잠재적으로(적어도 원칙적으로는) 인간이 language를 통해 해결할 수 있는 모든 task에 적용 가능합니다.
- 마지막으로, few-shot prompting의 exemplar에 chain of thought sequence의 예시를 포함하는 것만으로도, 충분히 큰 상용(off-the-shelf) language models에서 chain-of-thought reasoning을 쉽게 유도해낼 수 있습니다.
실증적 experiment에서 우리는 arithmetic reasoning(Section 3), commonsense reasoning(Section 4), symbolic reasoning(Section 5)에 대한 chain-of-thought prompting의 유용성을 관찰할 것입니다.
Conceptual Definition & Naming Rationale
- Chain of Thought (CoT): 최종 출력 이전에 모델이 자율적으로 생성하는 일관된 일련의 중간 자연어 추론 단계.
- 용어 선택의 이유: 사후적 설명(post-hoc explanation)이나 일반 풀이(solution)는 주로 최종 정답 이후에 제시되는 반면, CoT는 정답에 도달하기 위한 인간의 순차적 사고 흐름을 모방하여 정답 직전에 선행 생성된다는 점을 명확히 규정하기 위해 이 명칭을 채택.
Mechanism & Emergence
- Few-shot Demonstration을 통한 발현: 별도의 가중치 미세조정(fine-tuning) 없이, few-shot exemplar에 CoT 경로를 포함하는 것만으로 충분히 거대한 사전학습 LLM(off-the-shelf)에서 중간 추론 능력이 유도(emerge)됨.
Key Technical Properties & Advantages
- Dynamic Compute Allocation (동적 연산량 할당)
- 복잡한 다단계 문제를 중간 단계로 분해(decompose)함으로써, 생성되는 토큰 수에 비례하여 더 많은 추론 단계가 필요한 고난도 문제에 더 많은 계산 자원(computation/FLOPs)을 자연스럽게 투입하게 됨.
- Interpretability & Debuggability (해석 가능성 및 디버깅 용이성)
- 모델의 내부 연산 전체를 완벽히 규명하지는 못하더라도, 모델이 어떤 추론 경로를 거쳐 결론에 도달했는지 추적할 수 있는 직관적인 창(window) 역할을 수행하며, 오류 발생 지점을 특정할 수 있음.
- Task-Agnostic Generality (작업 불가지론적 범용성)
- 특정 도메인에 국한되지 않고 arithmetic, commonsense, symbolic reasoning 전반에 적용 가능하며, 이론적으로 인간이 언어로 해결 가능한 모든 다단계 task로 확장 가능.
- Zero-Training Overhead (추가 학습 비용 배제)
- 별도의 구조 변경이나 역전파 학습 없이 기존 상용 대형 LLM에 프롬프트 구성만 변경하여 즉시 적용 가능.
쉬운 설명 :
사람이 어려운 서술형 수학 문제를 풀 때 바로 답을 찍지 않고 "이걸 먼저 계산하고, 그 다음 저걸 더해서..."라며 연습장에 풀이 과정을 끄적이듯, AI에게도 똑같이 '생각의 과정'을 적고 나서 답을 내게 만드는 방법입니다.
이 방식의 핵심적인 장점은 크게 네 가지입니다.
첫째, AI는 글자를 한 글자씩 만들어낼 때마다 연산을 합니다. 풀이 과정을 길게 쓰게 만들면 그만큼 문제를 푸는 데 더 많은 생각 시간(계산량)을 쓰는 효과가 납니다.
둘째, 중간 과정을 다 보여주니 답이 틀렸을 때 AI가 어느 줄에서 헛소리를 했는지(디버깅) 사람이 바로 확인할 수 있습니다.
셋째, 수학뿐만 아니라 상식 문제, 논리 문제 등 사람이 말로 풀 수 있는 문제라면 어디에나 써먹을 수 있습니다.
마지막으로, 모델을 비싼 돈 들여 다시 학습시킬 필요가 전혀 없습니다. 그냥 질문을 던질 때 "문제를 풀 때는 이렇게 단계별로 푸는 거야"라는 예시를 몇 개 보여주기만 하면, 충분히 똑똑한 대형 AI는 알아서 그 방식을 흉내 내며 정답률을 극적으로 올립니다.
3 Arithmetic Reasoning
우리는 language models의 arithmetic reasoning 능력을 측정하는 Figure 1 형태의 수학 word problem을 살펴보는 것으로 시작합니다. 인간에게는 단순하지만, arithmetic reasoning은 language models가 종종 어려움을 겪는 task입니다. 놀랍게도, 540B parameter language model과 함께 chain-of-thought prompting을 사용할 경우 여러 task에서 task-specific finetuned models와 필적하는 performance를 보이며, 까다로운 GSM8K benchmark에서는 새로운 state of the art를 달성하기도 합니다.
3.1 Experimental Setup
우리는 다양한 benchmark에서 여러 language models를 대상으로 chain-of-thought prompting을 탐구합니다.
Benchmarks. 우리는 다음 다섯 가지 수학 word problem benchmarks를 고려합니다. (1) 수학 word problem benchmark인 GSM8K, (2) 다양한 구조를 가진 수학 word problem의 SVAMP dataset, (3) 다채로운 수학 word problem의 ASDiv dataset, (4) 대수학 word problem의 AQuA dataset, 그리고 (5) MAWPS benchmark입니다. 예시 문제는 Appendix Table 12에 제시되어 있습니다.
Standard prompting. baseline으로는 test-time example에 대한 prediction을 output하기 전에 language model에 input-output pair의 in-context exemplar를 제공하는 standard few-shot prompting을 고려합니다. exemplar는 question과 answer의 형태로 구성됩니다. Figure 1 (좌측)에 나타난 것처럼 model은 answer를 직접적으로 제시합니다.
Chain-of-thought prompting. 우리가 제안하는 접근법은 Figure 1 (우측)에 묘사된 것처럼 few-shot prompting의 각 exemplar에 연관된 answer를 위한 chain of thought를 augment하는 것입니다. 대부분의 dataset이 evaluation split만 가지고 있으므로, 우리는 prompting을 위해 chain of thought를 포함한 8개의 few-shot exemplar 세트를 수작업으로 구성했습니다. Figure 1 (우측)은 하나의 chain of thought exemplar를 보여주며, 전체 exemplar 세트는 Appendix Table 20에 수록되어 있습니다. (이 특정 exemplar들은 prompt engineering을 거치지 않았으며, robustness는 Section 3.4와 Appendix A.2에서 다룹니다.) 이러한 형태의 chain-of-thought prompting이 다양한 수학 word problem 전반에 걸쳐 성공적인 reasoning을 성공적으로 이끌어낼 수 있는지 알아보기 위해, 자유 서술형 대신 객관식(multiple choice)인 AQuA를 제외한 모든 benchmark에 이 단일 8개 chain of thought exemplar 세트를 사용했습니다. AQuA의 경우, Appendix Table 21에 제시된 바와 같이 training set에서 가져온 4개의 exemplar와 solution을 사용했습니다.
Language models. 우리는 5개의 large language models를 evaluate합니다. 첫 번째는 GPT-3로, text-ada-001, text-babbage-001, text-curie-001, text-davinci-002를 사용하며, 이들은 각각 350M, 1.3B, 6.7B, 175B parameter의 InstructGPT models에 해당하는 것으로 추정됩니다. 두 번째는 LaMDA로, 422M, 2B, 8B, 68B, 137B parameter의 models를 보유하고 있습니다. 세 번째는 PaLM으로, 8B, 62B, 540B parameter models가 있습니다. 네 번째는 UL2 20B이며, 다섯 번째는 Codex(OpenAI API의 code-davinci-002)입니다. 우리는 greedy decoding을 통해 models로부터 sampling을 진행합니다(후속 연구에서는 여러 번 sampling된 generation 결과 중 다수결 final answer를 취함으로써 chain-of-thought prompting을 향상시킬 수 있음을 보여주었습니다). LaMDA의 경우, 무작위로 exemplar의 순서를 섞은 5개의 random seed에 대한 평균 결과를 report합니다. LaMDA experiment에서 서로 다른 seed 간 분산이 크지 않았기 때문에, compute를 절약하고자 다른 모든 models에 대해서는 단일 exemplar 순서에 대한 결과를 report합니다.
3.2 Results
Chain-of-thought prompting의 가장 강력한 결과는 Figure 4에 요약되어 있으며, 각 model collection, model size, benchmark에 대한 모든 experiment output은 Appendix Table 2에 나와 있습니다.
세 가지 핵심 요점이 있습니다. 첫째, Figure 4는 chain-of-thought prompting이 model scale의 emergent ability임을 보여줍니다. 즉, chain-of-thought prompting은 소형 models에서는 performance에 긍정적인 영향을 미치지 않으며, $\sim\text{100B}$ parameter 규모의 models와 함께 사용될 때에만 performance gain을 가져옵니다. 우리는 정성적 분석을 통해 더 작은 scale의 models가 유창하지만 비논리적인 chain of thought를 생성하여, standard prompting보다 낮은 performance를 초래한다는 점을 발견했습니다.
둘째, chain-of-thought prompting은 더 복잡한 문제에서 더 큰 performance gain을 보입니다. 예를 들어, baseline performance가 가장 낮았던 dataset인 GSM8K의 경우, 가장 큰 GPT 및 PaLM models에서 performance가 두 배 이상 증가했습니다. 반면, 해결하는 데 단 한 단계만 필요한 MAWPS의 가장 쉬운 subset인 SingleOp의 경우, performance 향상은 음수이거나 매우 미미했습니다(Appendix Table 3 참조).
셋째, GPT-3 175B 및 PaLM 540B를 통한 chain-of-thought prompting은 labeled training dataset을 통해 task-specific model을 finetune하는 기존 state of the art와 비교해도 우수한 성과를 보입니다. Figure 4는 PaLM 540B가 chain-of-thought prompting을 사용하여 GSM8K, SVAMP, MAWPS에서 어떻게 새로운 state of the art를 달성하는지 보여줍니다(단, SVAMP의 경우 standard prompting으로도 이미 이전 최고 기록을 넘어섰다는 점에 유의하십시오). 다른 두 dataset인 AQuA와 ASDiv에서는 chain-of-thought prompting을 적용한 PaLM이 state of the art의 2% 이내 격차에 도달합니다(Appendix Table 2).
Chain-of-thought prompting이 왜 효과적인지 더 잘 이해하기 위해, 우리는 GSM8K에 대해 LaMDA 137B가 생성한 model-generated chain of thought를 수작업으로 검토했습니다. model이 올바른 final answer를 반환한 50개의 무작위 example 중, 우연히 정답에 도달한 2개를 제외하고는 생성된 모든 chain of thought가 논리적, 수학적으로도 올바른 것으로 나타났습니다(Appendix D.1 및 model-generated chain of thought 정답 예시가 수록된 Table 8 참조). 또한 우리는 model이 오답을 낸 50개의 무작위 sample도 검토했습니다. 이 분석의 요약에 따르면, chain of thought의 46%는 사소한 실수(계산기 오류, 기호 매핑 오류 또는 하나의 reasoning 단계 누락)를 제외하면 거의 정답에 가까웠으며, 나머지 54%의 chain of thought는 semantic understanding이나 일관성에서 심각한 오류를 보였습니다(Appendix D.2 참조). scaling이 왜 chain-of-thought reasoning 능력을 향상시키는지에 대한 통찰을 제공하고자, 우리는 PaLM 62B에서 발생한 오류 및 해당 오류가 PaLM 540B로 scaling하면서 해결되었는지에 대해 유사한 분석을 수행했습니다. 요약하자면, PaLM을 540B로 scaling하면 62B model에서 발생했던 한 단계 누락 및 semantic understanding 오류의 상당 부분이 해결됩니다(Appendix A.1 참조).
3.3 Ablation Study
Chain-of-thought prompting 사용에 따른 이점은, 동일한 performance 향상이 다른 유형의 prompting을 통해서도 부여될 수 있는지에 대한 자연스러운 의문을 제기합니다. Figure 5는 아래에 설명된 세 가지 chain of thought 변형을 사용한 ablation study를 보여줍니다.
Equation only. Chain-of-thought prompting이 도움이 되는 한 가지 이유는 계산되어야 할 수학적 equation을 산출하기 때문일 수 있으므로, 우리는 model이 answer를 내놓기 전에 오직 수학적 equation만을 output하도록 prompting하는 변형을 테스트합니다. Figure 5는 equation only prompting이 GSM8K에서는 큰 도움이 되지 않음을 보여주며, 이는 GSM8K 문제의 semantics가 chain of thought에 포함된 natural language reasoning 단계 없이 곧바로 equation으로 번역하기에는 너무 까다롭다는 것을 시사합니다. 그러나 한두 단계로 풀 수 있는 문제 dataset의 경우, 질문으로부터 equation을 쉽게 도출할 수 있기 때문에 equation only prompting이 performance를 향상시키는 것으로 나타났습니다(Appendix Table 6 참조).
Variable compute only. 또 다른 직관은 chain of thought가 model로 하여금 더 어려운 문제에 더 많은 computation(즉, 중간 token들)을 투입할 수 있게 해준다는 점입니다. variable computation의 효과를 chain-of-thought reasoning으로부터 분리해 보기 위해, 우리는 문제를 푸는 데 필요한 equation의 문자 수와 동일한 개수의 점(. . .) sequence만을 model이 output하도록 prompting하는 구성을 테스트합니다. 이 변형은 baseline과 거의 동일한 performance를 보이며, 이는 variable computation 그 자체만으로는 chain-of-thought prompting의 성공 원인이 되지 못하며 중간 단계들을 natural language로 표현하는 데 실질적인 효용이 있음을 시사합니다.
Chain of thought after answer. Chain-of-thought prompting의 또 다른 잠재적 이점은 단순히 이러한 prompt가 model로 하여금 pretraining 과정에서 습득한 관련 지식에 더 잘 접근할 수 있게 해준다는 점일 수 있습니다. 따라서 우리는 chain of thought prompt를 오직 answer 뒤에만 배치하는 대안적 구성을 테스트하여, model이 final answer를 도출하는 과정에서 생성된 chain of thought에 실제로 의존하는지 여부를 분리해 봅니다. 이 변형은 baseline과 거의 동일한 performance를 보이며, 이는 chain of thought에 구현된 순차적 reasoning이 단순한 지식 활성화를 넘어선 이유로 유용하다는 점을 시사합니다.
3.4 Robustness of Chain of Thought
Exemplar에 대한 민감도는 prompting 접근법에서 핵심적인 고려 사항입니다. 예를 들어 few-shot exemplar의 순열을 바꾸는 것만으로도 SST-2에서 GPT-3의 accuracy가 무작위 수준(54.3%)에서 거의 state-of-the-art 수준(93.4%)까지 달라질 수 있습니다. 이 마지막 subsection에서는 서로 다른 작성자(annotator)가 작성한 chain of thought에 대한 robustness를 evaluate합니다. Annotator A가 작성한 chain of thought를 사용한 위의 결과 외에도, 본 논문의 다른 두 공동 저자(Annotator B 및 C)가 동일한 few-shot exemplar에 대해 독자적으로 chain of thought를 작성했습니다(Appendix H에 제시). Annotator A는 또한 원본보다 더 간결하게 작성된 또 다른 chain of thought를 작성하기도 했습니다.
GSM8K 및 MAWPS에 대해 LaMDA 137B를 사용한 이러한 결과가 Figure 6에 나와 있습니다(다른 dataset에 대한 ablation 결과는 Appendix Table 6 / Table 7에 제시). exemplar 기반 prompting을 사용할 때 예상할 수 있듯이 서로 다른 chain of thought annotation 간에 분산은 존재하지만, 모든 chain of thought prompt 세트는 standard baseline을 큰 격차로 능가합니다. 이 결과는 chain of thought의 성공적인 활용이 특정한 언어적 스타일에 의존하지 않음을 의미합니다.
성공적인 chain-of-thought prompting이 다른 exemplar 세트에서도 작동하는지 확인하기 위해, 독립적인 출처인 GSM8K training set에서 무작위로 추출한 8개 exemplar 세트 3개를 사용해 experiment도 수행했습니다(이 dataset의 예시들은 이미 chain of thought와 같은 reasoning 단계를 포함하고 있었습니다). Figure 6은 이러한 prompt들이 수작업으로 작성한 exemplar와 필적하는 performance를 보였으며, standard prompting 역시 큰 폭으로 능가했음을 보여줍니다.
작성자, 독립적으로 작성된 chain of thought, 서로 다른 exemplar, 다양한 language models에 대한 robustness 외에도, 우리는 arithmetic reasoning을 위한 chain-of-thought prompting이 다양한 exemplar 순서 및 다양한 수의 exemplar에 대해서도 robust함을 확인했습니다(Appendix A.2 참조).
Experimental Design & Setup
- Benchmarks: 총 5종(GSM8K, SVAMP, ASDiv, AQuA, MAWPS). AQuA(객관식)를 제외한 전 벤치마크에 프롬프트 엔지니어링을 거치지 않은 동일한 8개의 수작업 CoT 예시 세트 단 하나만 범용 적용.
- Evaluated Models: GPT-3(최대 175B), LaMDA(최대 137B), PaLM(최대 540B), UL2 20B, Codex. Greedy decoding 기준 평가.
Key Experimental Findings
- Emergent Ability of Scale ($\sim\text{100B}$ Threshold)
- 파라미터 수가 작은 모델($<\text{100B}$)에서는 CoT가 유창하지만 비논리적인 추론을 유발하여 오히려 Standard Prompting보다 성능이 하락함.
- 약 100B 이상의 체급에서만 CoT를 통한 성능 이득이 본격적으로 발현됨.
- Problem Complexity Correlation
- 문제 난이도가 높고 다단계 연산이 필요할수록(예: GSM8K) 성능 상승 폭이 극대화됨(PaLM 540B 및 GPT-3 기준 성능 2배 이상 증가).
- 반면 단순 단일 연산(SingleOp)에서는 이득이 없거나 오히려 미미하게 역효과 발생.
- SoTA Comparison
- PaLM 540B + CoT 조합은 파인튜닝 전용 모델들을 제치고 GSM8K, SVAMP, MAWPS에서 최고 성능(SoTA) 갱신.
- Qualitative Error Analysis (LaMDA 137B & PaLM)
- 정답 케이스 중 96%($\text{50}$개 중 $\text{48}$개)는 중간 추론 경로까지 논리적/수학적으로 완벽했음(우연한 정답 배제).
- 오답의 46%는 단순 계산 착오, 기호 매핑 오류, 1단계 누락 등 사소한 실수.
- 체급을 62B에서 540B로 확장 시, 의미 이해 실패 및 단계 누락 문제가 대폭 교정됨.
Ablation Study: Why CoT Works
- Equation Only (수식만 유도): 단순 문제는 통하나 GSM8K 같은 복잡한 언어 문제에서는 실패. 자연어 기반의 의미 분해 단계가 필수적임을 입증.
- Variable Compute Only (점 $\text{...}$ 토큰으로 연산량만 확보): Baseline과 차이 없음. 토큰 생성으로 인한 추가 연산량(FLOPs) 확보 자체가 원인이 아니라, 자연어 추론 과정 자체의 효용임이 입증됨.
- CoT After Answer (정답 출력 후 사후 추론): Baseline과 차이 없음. 사전학습 지식 단순 인출(activation)이 아니라, 순차적 추론 경로가 정답 생성에 직접 관여함을 증명.
Robustness Evaluation
- 작성자 편향 독립성: 서로 다른 작성자 3명이 쓴 CoT, 간결한 CoT 스타일 모두 베이스라인을 압도.
- 예시 데이터 독립성: GSM8K 학습 세트에서 랜덤 샘플링한 8개 예시로도 수작업 예시와 대등한 성능 달성.
- 순서 및 개수 변동: 프롬프트 내 예시 순서 셔플 및 예시 수 증감에도 일관되게 강건(robust)함.
쉬운 설명 :
수학 서술형 문제에서 CoT가 진짜 효과가 있는지 체급별 모델들을 동원해 샅샅이 파헤친 실험 파트입니다.
실험 결과, 모델 크기가 약 1,000억 개(100B) 파라미터를 넘지 못하면 CoT를 시켜도 헛소리만 늘어놓아 오히려 그냥 찍는 것보다 점수가 떨어졌습니다. 하지만 모델이 충분히 커지면 마법처럼 성능이 폭발하여 복잡한 수학 문제 정답률이 2배 이상 뛰어올랐고, 수천억 개 파라미터 모델(PaLM 540B)은 기존 1등 모델들을 꺾어버렸습니다.
연구진은 "진짜 풀이 과정을 이해해서 맞힌 건가?"를 검증하기 위해 기발한 비교 실험(Ablation)도 진행했습니다:
- 식만 쓰게 해봄: 단순한 문제는 풀지만, 복잡한 문제는 말로 풀어서 설명하는 단계가 없으면 식 자체를 못 세웠습니다.
- 풀이 대신 점(...)만 찍으며 생각 시간(연산량)만 벌어줌: 점수 변화가 없었습니다. 즉, 단순히 시간을 더 줘서 맞힌 게 아니라 자연어로 생각을 정리하는 행위 자체가 핵심이었습니다.
- 답 먼저 쓰고 풀이를 쓰게 해봄: 점수가 그대로였습니다. 즉, 답을 먼저 찍고 말을 지어낸 게 아니라 풀이 과정을 밟아 나갔기 때문에 답을 맞힐 수 있었던 것입니다.
마지막으로 프롬프트 작성자가 바뀌거나, 글 스타일이 바뀌거나, 문제 예시 순서를 섞어도 성능이 꺾이지 않고 탄탄하게 유지된다는 사실까지 증명해 냈습니다.
4 Commonsense Reasoning
Chain of thought가 수학 word problem에 특히 적합하기는 하지만, chain of thought의 language 기반 특성은 일반적인 배경지식(background knowledge)의 전제 하에 물리적 및 인간적 상호작용에 대해 reasoning하는 광범위한 commonsense reasoning 문제 클래스에도 실제로 적용 가능하도록 만들어 줍니다. Commonsense reasoning은 세상과 상호작용하는 데 핵심적이며, 현재의 natural language understanding systems로는 여전히 도달하기 어려운 영역입니다.
Benchmarks. 우리는 다양한 유형의 commonsense reasoning을 포괄하는 5개의 dataset을 고려합니다. 대중적으로 쓰이는 CSQA는 사전 지식을 요구하는 경우가 많은 복잡한 semantics를 포함하여 세상에 대한 commonsense question을 묻습니다. StrategyQA는 question에 answer하기 위해 model이 multi-hop strategy를 추론할 것을 요구합니다. 우리는 BIG-bench 프로젝트에서 두 가지 특화된 evaluation set을 선택했습니다. 주어진 context로부터 날짜를 추론하는 Date Understanding과 스포츠와 관련된 문장이 타당한지(plausible) 타당하지 않은지(implausible)를 판단하는 Sports Understanding입니다. 마지막으로 SayCan dataset은 natural language instruction을 이산적인 집합으로부터 일련의 robot action sequence로 매핑하는 task를 포함합니다. Figure 3은 모든 dataset에 대한 chain of thought annotation 예시를 보여줍니다.
Prompts. 우리는 이전 section과 동일한 experimental setup을 따릅니다. CSQA 및 StrategyQA의 경우, training set에서 example을 무작위로 선택하고 few-shot exemplar로 사용하기 위해 수작업으로 chain of thought를 작성했습니다. 두 BIG-bench task에는 training set이 없으므로 evaluation set의 처음 10개 example을 few-shot exemplar로 선택하고 evaluation set의 나머지 부분에 대해 수치를 report합니다. SayCan의 경우, 이전 연구에서 사용된 training set의 6개 example을 사용했으며 역시 수작업으로 chain of thought를 작성했습니다.
Results. Figure 7은 PaLM에 대한 이러한 결과를 강조하여 보여줍니다(LaMDA, GPT-3 및 다양한 model scale에 대한 전체 결과는 Table 4에 수록되어 있습니다). 모든 task에서 model size를 scaling up하는 것은 standard prompting의 performance를 향상시켰으며, chain-of-thought prompting은 추가적인 gain을 가져왔고 그 향상 폭은 PaLM 540B에서 가장 크게 나타났습니다. Chain-of-thought prompting을 적용했을 때 PaLM 540B는 baseline 대비 강력한 performance를 달성하여, StrategyQA에서 기존 state of the art를 능가했고(75.6% vs 69.4%), Sports Understanding에서는 도움을 받지 않은 스포츠 애호가를 능가했습니다(95.4% vs 84%). 이러한 결과들은 chain-of-thought prompting이 다양한 commonsense reasoning 능력을 요구하는 task에서도 performance를 향상시킬 수 있음을 입증합니다(단, CSQA에서의 gain은 미미했다는 점에 유의하십시오).
Scope & Generalization Premise
- 수학을 넘어 상식 영역으로의 확장: CoT의 본질은 기호 연산이 아닌 자연어(natural language) 기반 추론이므로, 물리적 법칙 및 인간 간 상호작용 등 일반 상식(background knowledge)을 요하는 광범위한 Commonsense Reasoning 문제에도 직접 적용 가능함.
Benchmarks & Task Diversity 총 5종의 서로 다른 상식 추론 영역을 포괄하여 평가:
- CSQA: 복잡한 의미론적 배경지식이 요구되는 일반 상식 QA.
- StrategyQA: 숨겨진 추론 경로를 다단계로 도출해야 하는 Multi-hop 전략 추론.
- BIG-bench (Date Understanding): 문맥(context) 속 시간적 관계를 파악하여 특정 일자를 역추산.
- BIG-bench (Sports Understanding): 스포츠 관련 문장의 물리적/상식적 타당성(plausibility) 판별.
- SayCan: 추상적인 자연어 명령을 로봇의 이산적인 물리 행동 시퀀스(robot action sequence)로 변환.
Prompting Setup
- 별도의 미세조정(fine-tuning) 없이 소수(6~10개)의 예시에 중간 추론 과정을 손수 작성한 Few-shot CoT 프롬프트만을 일관되게 적용.
Key Experimental Findings
- Scale-Dependent Gains: Standard prompting 역시 모델 크기 증대(scale-up)에 따라 성능이 개선되나, CoT를 결합할 때 추가적인 성능 향상 폭이 극대화되며 이 경향은 초대형 모델인 PaLM 540B에서 가장 두드러짐.
- 벤치마크별 유의미한 도약:
- StrategyQA: PaLM 540B + CoT 적용 시 정답률 75.6%를 기록하며 기존 SoTA(69.4%)를 큰 격차로 갱신. 다단계 전략 수립이 필요한 문제에서 CoT의 효과가 확실히 검증됨.
- Sports Understanding: 정답률 95.4%를 달성하여 실제 스포츠 팬(human enthusiast, 84%) 기준치를 크게 상회.
- 예외적 관찰 (CSQA의 한계): CSQA의 경우 CoT 적용에 따른 성능 향상 폭이 매우 미미했음. 단순 사실 인출(retrieval) 중심의 상식 태스크보다는, 여러 단계를 거쳐 생각해야 하는 구조(multi-hop)에서 CoT의 실질적 효용이 발휘됨을 시사.
쉬운 설명 :
"CoT가 계산 문제뿐만 아니라 일상적인 상식과 눈치(상식 추론) 문제에서도 통할까?"를 실험한 파트입니다.
연구진은 단순히 지식을 묻는 퀴즈부터 시작해서 날짜 셈하기, 스포츠 상식(예: "골키퍼가 덩크슛을 했다"는 말이 말이 되는지 판별하기), 그리고 말로 내린 명령을 로봇의 행동 순서로 바꾸는 문제까지 다양하게 테스트했습니다.
그 결과, 모델이 커질수록 상식 문제에서도 CoT의 위력이 확실하게 드러났습니다:
- 생각을 여러 번 굴려야 하는 문제(StrategyQA): 한 번에 바로 답이 안 나오는 고난도 문제에서 기존 세계 최고 기록을 갈아치웠습니다.
- 스포츠 상식: 웬만한 스포츠 팬(사람)보다 AI가 헛소리와 진짜를 더 잘 가려냈습니다.
- 단, 단순 지식 묻기(CSQA)는 예외: 머리를 써서 단계를 밟는 게 아니라 "원래 알던 지식"을 그냥 꺼내기만 하면 되는 문제에서는 CoT를 써도 점수가 별로 오르지 않았습니다.
즉, 상식 영역에서도 "여러 단계를 거쳐서 추론해야 하는 문제"일수록 생각의 과정(CoT)이 빛을 발한다는 점을 증명했습니다.
5 Symbolic Reasoning
우리의 최종 experimental evaluation은 인간에게는 단순하지만 language models에게는 잠재적으로 까다로운 symbolic reasoning을 다룹니다. 우리는 chain-of-thought prompting이 standard prompting 설정에서는 도전적인 symbolic reasoning task를 language models가 수행할 수 있도록 해줄 뿐만 아니라, few-shot exemplar에서 본 것보다 더 긴 inference-time input에 대한 length generalization을 촉진함을 보여줍니다.
Tasks. 우리는 다음과 같은 두 가지 toy task를 사용합니다.
- Last letter concatenation. 이 task는 이름에 포함된 단어들의 마지막 글자들을 concatenate하도록 model에 요구합니다(예: "Amy Brown" $\rightarrow$ "yn"). 이는 language models가 이미 chain of thought 없이도 수행할 수 있는 first letter concatenation보다 더 까다로운 버전입니다. 우리는 이름 인구조사 데이터의 상위 1,000개 성과 이름에서 무작위로 concatenate하여 전체 이름을 generation합니다.
- Coin flip. 이 task는 사람들이 동전을 뒤집거나 뒤집지 않은 후에 동전의 앞면이 여전히 위를 향하고 있는지 model이 answer하도록 요구합니다(예: "동전 앞면이 위를 향하고 있습니다. Phoebe가 동전을 뒤집습니다. Osvaldo는 동전을 뒤집지 않습니다. 동전 앞면이 여전히 위를 향하고 있습니까?" $\rightarrow$ "no").
이러한 symbolic reasoning task의 구성은 명확하게 정의되어 있으므로, 우리는 각 task에 대해 training/few-shot exemplar와 동일한 단계 수를 가진 example로 구성된 in-domain test set뿐만 아니라, evaluation example이 exemplar보다 더 많은 단계를 가진 out-of-domain(OOD) test set도 함께 고려합니다. Last letter concatenation의 경우, model은 두 단어로 된 이름의 exemplar만 보고 나서 3단어 및 4단어로 된 이름에 대해 last letter concatenation을 수행합니다. Coin flip task의 가능한 뒤집기 횟수에 대해서도 동일하게 적용합니다. 우리의 experimental setup은 이전 두 section과 동일한 methods 및 models를 사용합니다. 우리는 Figure 3에 제시된 바와 같이 각 task의 few-shot exemplar에 대해 수작업으로 chain of thought를 다시 구성했습니다.
Results. 이러한 in-domain 및 OOD evaluation 결과는 PaLM의 경우 Figure 8에 나와 있으며, LaMDA에 대한 결과는 Appendix Table 5에 나와 있습니다. PaLM 540B에서 chain-of-thought prompting은 거의 100%의 solve rate를 이끌어냅니다(단, standard prompting 역시 LaMDA 137B에서는 아니었지만 PaLM 540B로 coin flip을 이미 해결했다는 점에 유의하십시오). 이러한 in-domain evaluation은 few-shot exemplar의 chain of thought를 통해 완벽한 solution structure가 이미 제공된다는 점에서 "toy task"라는 점에 주목해야 합니다. model이 해야 할 일은 test-time example의 새로운 symbol에 대해 동일한 단계를 반복하는 것뿐입니다. 그럼에도 불구하고, 소형 models는 여전히 실패합니다. 이러한 세 가지 task에 대해 보지 못한(unseen) symbol에 대한 추상적 조작을 수행하는 능력은 오직 100B model parameter scale에서만 나타납니다.
OOD evaluation의 경우, standard prompting은 두 task 모두에서 실패합니다. Chain-of-thought prompting을 적용하면 language models는 상승하는 scaling curve를 달성합니다(in-domain 설정보다는 performance가 낮지만). 따라서 chain-of-thought prompting은 충분한 scale을 갖춘 language models에서 학습 시 본 chain of thought 범위를 넘어선 length generalization을 촉진합니다.
Task Definition & Design
- Last Letter Concatenation (끝 글자 결합): 이름에 포함된 단어들의 마지막 글자만 추출해 연결(예: "Amy Brown" $\rightarrow$ "yn"). 첫 글자 추출과 달리 토크나이저 경계와 맞지 않아 언어 모델에 훨씬 까다로운 조작.
- Coin Flip (동전 뒤집기 시뮬레이션): 순차적인 행동 조건("뒤집는다/안 뒤집는다")을 추적하여 최종 동전 상태(앞면/뒷면) 판별.
Evaluation Setting: In-Domain vs. Out-of-Domain (OOD)
- In-Domain (IID): Few-shot 프롬프트에 제공된 예시와 동일한 추론 단계 수(예: 2단어 이름 결합, 소수 횟수의 동전 뒤집기).
- Out-of-Domain (Length Generalization): 프롬프트 예시보다 더 긴 입력과 많은 단계를 요구(예: 프롬프트는 2단어 예시만 보여주고, 평가는 3~4단어 이름 또는 더 많은 뒤집기 시퀀스 적용).
Key Findings & Emergent Properties
- In-Domain 정답률과 Scale Threshold
- PaLM 540B + CoT 적용 시 두 작업 모두에서 거의 100% 해결율 달성.
- 프롬프트에 완벽한 해결 템플릿 구조를 주었음에도 소형 모델($<\text{100B}$)은 미지의 기호(unseen symbol)에 대한 규칙 적용에 실패함. 즉, 기호 추상 조작 능력 역시 100B 이상 스케일에서 발현(emergent).
- Length Generalization (길이 일반화)
- Standard Prompting은 OOD 환경(더 긴 시퀀스)에서 완전히 붕괴(실패).
- CoT를 적용한 대형 모델은 예시에서 본 단계 수보다 더 긴 추론 경로에 대해서도 완벽하진 않으나 준수한 성능 향상 곡선(scaling curve)을 보임.
- 함의: 모델이 예시의 특정 패턴을 단순 암기한 것이 아니라, 단계별 추론 규칙(algorithm) 자체를 일반화하여 더 긴 시퀀스에도 순차 적용할 수 있음을 증명.
쉬운 설명 :
"AI가 기호와 규칙을 바탕으로 논리적인 조작을 수행할 수 있는가?"를 검증한 파트입니다.
사람에게는 유치할 정도로 쉬운 두 가지 장난감 문제(Toy Task)를 줬습니다:
- 이름의 맨 끝 글자만 따서 합치기 (예: Amy Brown $\rightarrow$ y와 n $\rightarrow$ yn)
- 동전을 뒤집고 안 뒤집는 과정을 따라가며 마지막에 앞면인지 맞히기
결과는 놀라웠습니다. 소형 AI들은 풀이 템플릿을 그대로 떠먹여 줘도 새로운 글자가 나오면 헤매며 틀렸지만, 1,000억 개(100B) 이상의 거대 모델(PaLM 540B)은 풀이 과정(CoT)을 거치자 정답률 100%를 찍었습니다.
더 중요한 것은 "길이 일반화(Length Generalization)"였습니다.
프롬프트에는 2단어짜리 이름(예: Amy Brown)을 푸는 법만 예시로 보여주고, 시험 문제로는 3~4단어짜리 긴 이름을 줬습니다. 그냥 답을 내라고 하면 AI는 완전히 망가졌지만, 생각의 과정(CoT)을 거치게 만들자 한 번도 본 적 없는 더 긴 문제도 스스로 단계를 늘려가며 척척 풀어냈습니다. 즉, 예시를 앵무새처럼 외운 게 아니라 "규칙을 적용하며 한 단계씩 나아가는 법" 자체를 터득했음을 보여줍니다.