| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- From
- 영어학습법
- 5형식
- 0528
- 자리
- ing
- Into
- TO
- #삼립수박샌드 #수박샌드 #삼립신상 #삼립빵 #신상빵 #편의점신상 #편의점빵 #편의점디저트 #세븐일레븐신상 #세븐일레븐빵 #편의점간식 #신상과자리뷰 #신상리뷰 #수박맛 #수박맛빵 #수박바맛 #수박디저트 #여름간식 #여름디저트 #크림샌드 #크림카스테라 #카스테라 #빵리뷰 #간식추천 #편의점추천
- 김원스쿨
- IS
- \
- AS
- TO 부정사
- GPT
- put
- 중국AI
- #뱅크시 #뱅크시전시 #뱅크시전시회 #뱅크시서울전시 #뱅크시스틸히어 #BANKSY #BANKSYSTILLHERE #더현대뱅크시 #더현대서울뱅크시 #더현대서울전시 #더현대전시 #더현대전시회 #더현대서울ALT1 #ALT1 #현대백화점전시 #서울전시 #서울전시회 #서울전시추천 #서울전시회추천 #서울미술전시 #서울미술관 #서울가볼만한곳 #서울실내데이트 #서울데이트 #서울데이트코스 #서울데이트추천 #여의도전시 #여의도데이트 #여의도가볼만한곳 #여의도데이트코스 #
- 딥시크
- deekseek
- 자리의힘
- be to 부정사
- Today
- Total
AI바라기의 인공지능
[4점] MI : 칼럼 리뷰 : 본버전 : Neural Networks Are Already Clean 본문
short 버전 보고와야해요!.
저자는 기존에 Polysemanticity를 설명하던 Superposition 해석이 과장됐고, 실제로는 대부분 Neuron이 related concept으로 확장되는 Recursive Generalization으로 설명된다고 주장합니다.
그래서 Neural Network는 생각보다 훨씬 정돈돼 있으며, SAE 같은 Decomposition 없이도 Neuron과 Circuit을 직접 분석하는 방식으로 상당 부분 해석할 수 있다고 봅니다.
또 이런 이해는 누적될수록 더 쉬워져, Mechanistic Interpretability 자체가 예상보다 훨씬 tractable할 수 있다는 결론입니다.
자동차와 동물
가장 유명한 polysemantic neuron은 InceptionV1의 4e:55 뉴런으로, 고양이와 자동차가 무작위로 뒤섞인 것처럼 보였습니다. 이 뉴런은 2017년의 Feature Visualization부터 Zoom In에 이르기까지, 이 분야에서 가장 널리 읽힌 여러 논문에서 뉴런이 연구의 적절한 단위가 아닐 수도 있다는 근거로 제시되었습니다. 제가 공동 저자로 참여한 Zoom In에서는 이 뉴런이 “자동차와 고양이 얼굴 사이의 어떤 공통적인 특징에 반응하는 것은 아니다”라고 명시적으로 주장하기도 했습니다.
몇 달 동안 clean neuron들을 관찰하면서, 저는 초기의 대표적인 polysemanticity와 superposition 사례들을 우리가 잘못 해석했던 것은 아닐까 하는 의문이 들었습니다. 가장 대표적인 polysemantic neuron이 이를 확인하기에 가장 적절한 대상처럼 보였습니다. 그래서 수백 번이나 보았던 고양이와 자동차 이미지 모음을 다시 열어, 이전에는 한 번도 해보지 않았던 일을 했습니다. 이 이미지들이 사실 하나의 어떤 특징을 나타내는 것은 아닐까 하고 몇 초 동안 생각해 본 것입니다.
거의 즉시 답이 분명해졌습니다. 이것은 고양이와 자동차에 반응하는 뉴런이 아니라, V자 형태에 반응하는 뉴런이었습니다.
저는 이 뉴런의 circuit connections를 살펴보았습니다. V자 형태의 불꽃, 소방정에서 뿜어져 나오는 V자 형태의 물줄기, V자 형태의 여우 얼굴이 있었습니다. 또한 이 뉴런의 negative pole도 살펴보았습니다. 그곳에는 V자의 뾰족한 부분과 달리 둥근 형태인 O가 있었습니다.
고양이와 자동차가 무작위로 섞인 뉴런이라면, 도대체 왜 불꽃과 그렇게 강하게 연결되어 있어야 할까요?
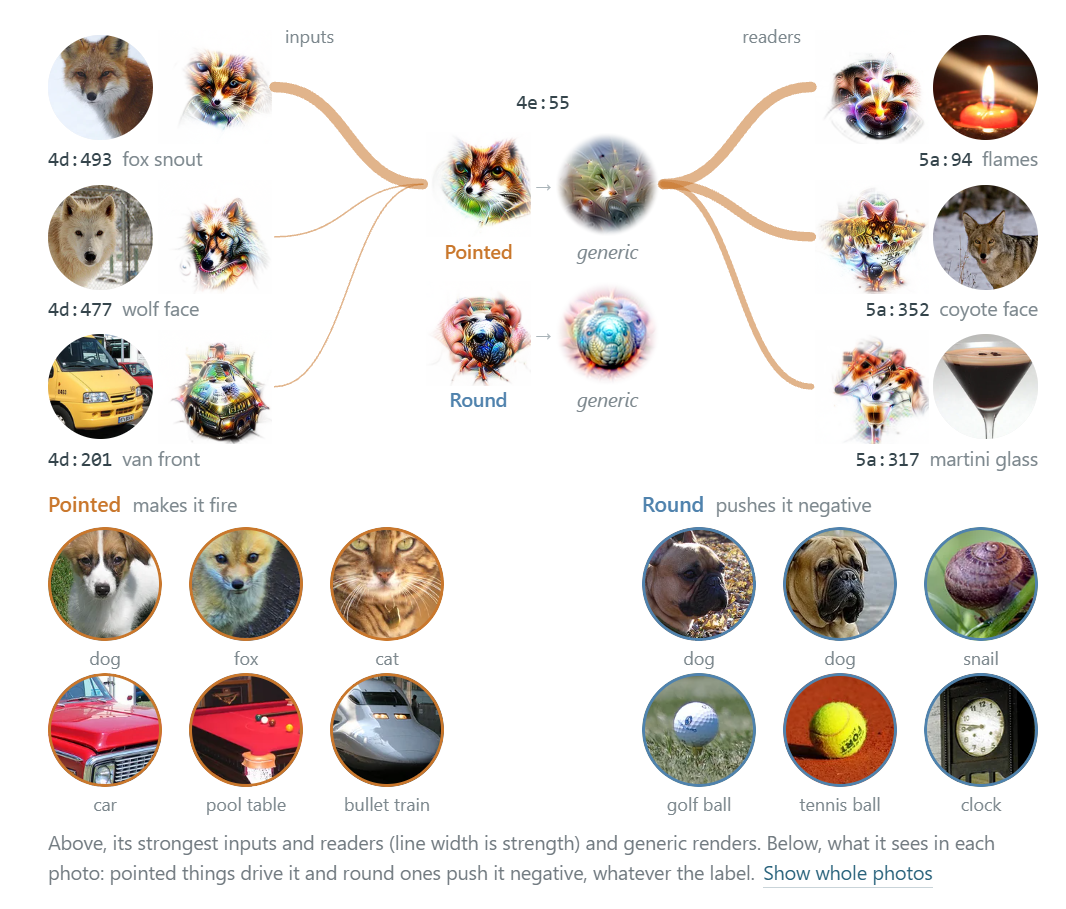
(예전에 cat + car라는 unrelated concept을 같이 보는 polysemantic neuron이라고 해석했던 유명 사례도, 사실은 더 추상적인 shape feature 하나로 일관되게 설명할 수 있었다.)
그다음 저는 2019년에 처음 발견했던 대표적인 superposition circuit으로 돌아갔습니다.³ V neuron과 이 circuit은 Zoom In[4]에서, 거의 모든 neuron은 진지하게 들여다보면 이해할 수 있다는 neuron 중심의 관점이 어쩌면 “지나치게 낙관적”일 수 있다고 제시한 두 가지 핵심 사례였습니다.
그 circuit은 자동차 하나가 서로 관련 없어 보이는 여러 dog neuron으로 들어가는 것처럼 보였습니다. 마치 이 dog neuron들이 일종의 high-dimensional storage처럼 작동해서, 자동차 정보를 그 안에 저장해 두었다가 나중에 필요할 때 다시 복원할 수 있는 것처럼 보였습니다.
하지만 실제로 자동차가 하고 있던 일은 그런 것이 아니었습니다. 자동차와 개가 함께 묶인 이유는 shared pose 때문이었습니다. InceptionV1에는 이런 generalized pose neuron이 100개 이상 존재합니다. 각각은 자동차, 개, 그리고 다른 object들에서 공통적으로 나타나는 특정 pose를 깔끔하게 detect합니다. 제가 아는 한 이전에는 아무도 이 neuron들을 발견하지 못했습니다.
이후 layer들도 이 generalized pose neuron을 계속 이용하며, model의 마지막까지 그 위에서 feature를 쌓아갑니다. 자동차 정보가 어떤 불분명한 장소에 저장되어 있었던 것도 아니고, 그 neuron들의 조합을 직접 읽어내는 것도 없었습니다. 오히려 반대였습니다. 자동차와 관련된 representation은 계속 분화하면서 더 구체적인 car specialist와 더 세밀한 pose로 발전하고 있었습니다.
우리가 이를 잘못 해석한 이유 중 하나는 generalized pose neuron의 존재를 몰랐기 때문이고, 또 다른 이유는 이미지를 icon 형태로 보여주기 위해 사용했던 Feature Visualization이 깊은 layer에서 reward hacked되기 때문입니다.
(최적화가 목표 함수 점수는 잘 올렸지만, 우리가 원했던 해석 목적은 제대로 만족하지 못했다)
Feature Visualization의 목적은 특정 neuron을 최대한 강하게 activate하는 이미지를 찾는 것입니다. 그런데 이를 gradient descent로 최적화하다 보니 가장 쉬운 경로를 따라가게 되고, InceptionV1에서는 그 경로가 자주 dog 쪽으로 향합니다.
( 왜 예전에 저 Circuit을 Superposition처럼 잘못 봤는가”를 설명하는 부분 )
InceptionV1의 training data에는 dog 이미지가 많고 dog neuron도 많이 존재합니다. 그래서 optimization 초반에 dog 쪽 representation으로 빠져들면 이후에도 거기서 벗어나지 못합니다.
( Feature Visualization으로 실제로 합성해보면 개처럼 보이는 이미지가 자주 나와서, 많은 Neuron을 dog-related Neuron으로 오해하기 쉬웠다는 뜻 )
하지만 실제 자연 이미지에서 높은 activation을 만드는 경로 쪽으로 조금만 bias를 주면, 대부분은 자동차 이미지가 나옵니다. 그리고 일부는 dog와 car가 동시에 나타납니다. 둘이 shared pose를 가지고 있기 때문입니다.
( “이 Neuron을 최대화하되, 실제로 이 Neuron을 강하게 켜는 자연 이미지들이 지나가는 내부 경로 쪽으로 가봐” )
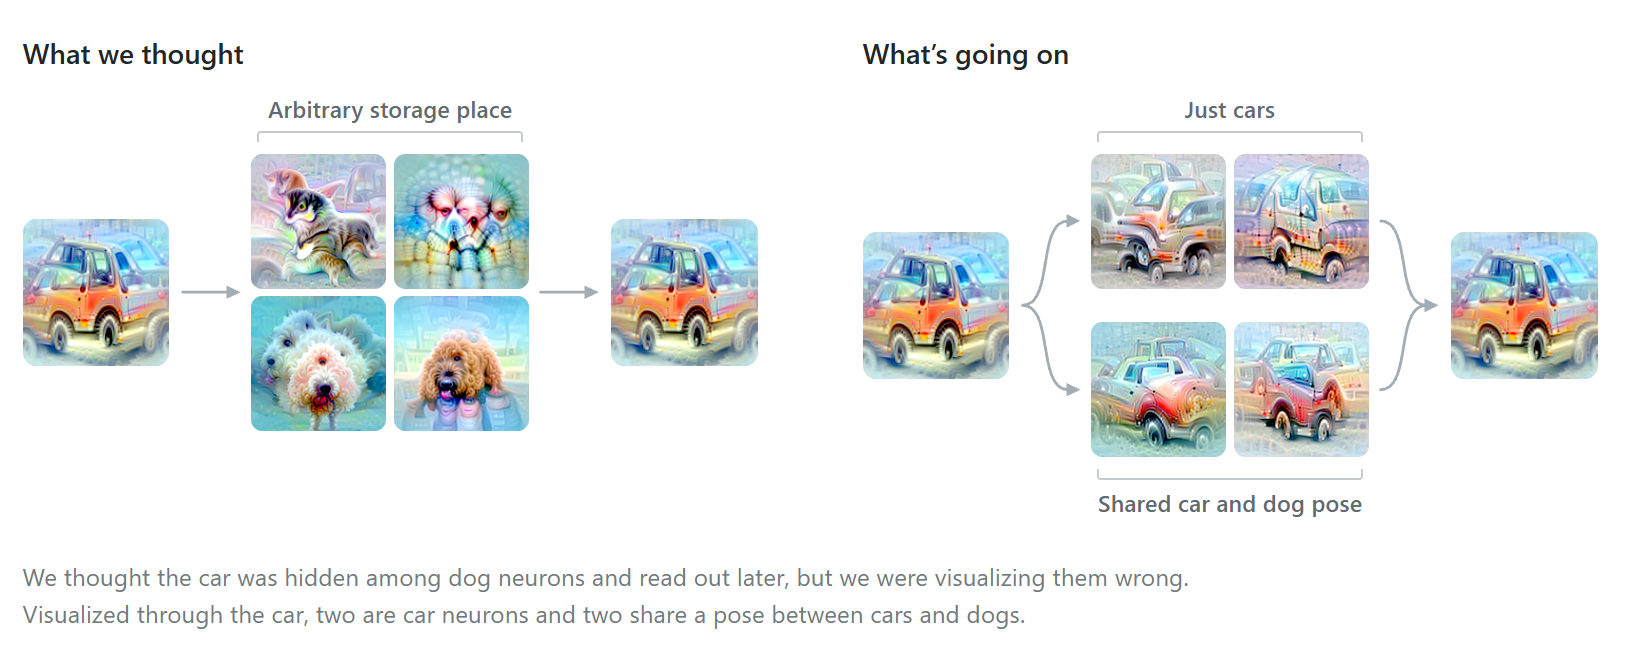
- 실제 car 이미지를 Model에 넣음
- Circuit/attribution을 추적해보니, 중간의 특정 Neuron 4개가 car 처리에 관여하고 있었음
- 그런데 그 4개 Neuron을 각각 Feature Visualization 해봄
- Feature Visualization은 랜덤 이미지에서 시작해서 각 Neuron activation을 최대화함
- 그렇게 만든 synthetic image들이 고양이/개처럼 보였음
이러한 Generalization을 별것 아닌 것으로 치부하고 싶은 유혹이 있을 수 있습니다. dog와 car가 함께 묶여 있는 이유는 단지 공간이 부족하기 때문이라고 생각할 수 있기 때문입니다. 어쩌면 Network는 사실 dog-pose neuron과 car-pose neuron을 따로 만들고 싶었지만, 공간이 부족해서 둘을 합쳐놓았고, 더 큰 Model이라면 이들을 분리했을지도 모릅니다.
더 큰 Model일수록 더 좁고 구체적인 Neuron을 가지는 경향이 있는 것은 사실입니다. 하지만 Network가 Scale up될 때는 직관과 다른 방식으로 변화하기도 합니다.
DINOv2[12]를 살펴보면, 이 Model은 크기가 10배 이상 크고 Architecture도 약 10년 뒤의 것이지만, pose neuron의 수는 더 많아졌음에도 그중 상당수는 여전히 generalized되어 있습니다.
제가 살펴본 모든 Vision Model에서, Model 크기와 상관없이 이런 현상을 관찰했습니다.
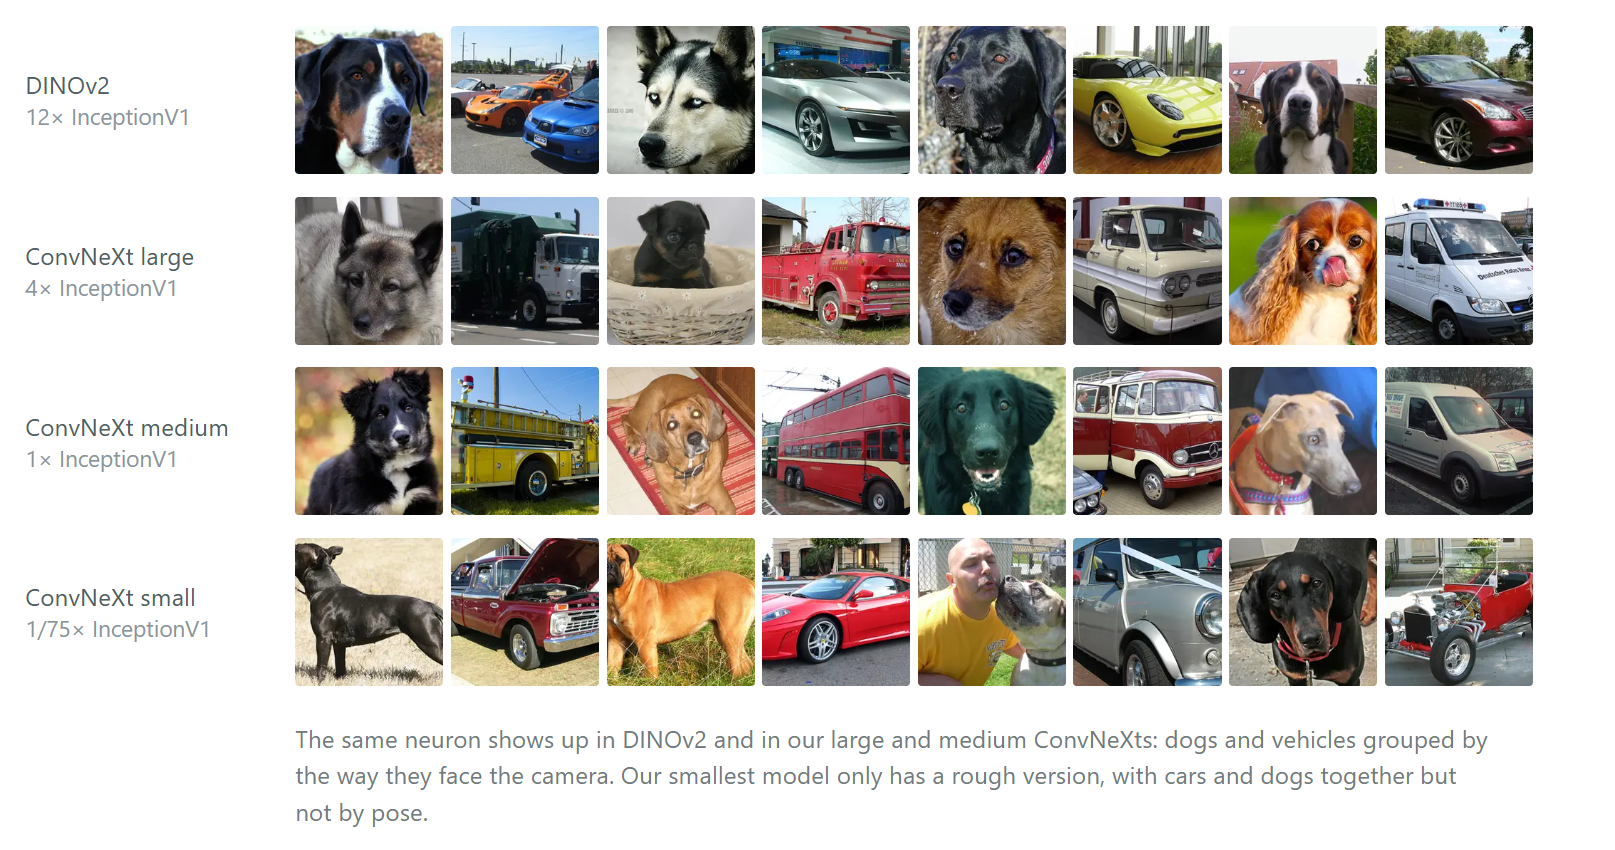
(Model 크기가 달라도 car와 dog를 함께 묶는 generalized pose neuron이 계속 나타난다)
인간 해석자와 자동화된 해석자 모두 Neuron을 V 같은 shared pattern의 detector로 설명하기보다는, cat이나 car처럼 여러 noun group을 탐지하는 detector로 설명하려는 강한 편향을 보이는 것 같습니다.
물론 어떤 Neuron은 실제로 여러 noun group에 반응하기도 합니다. 하지만 제 경험상 더 흔한 경우는 하나의 shared pattern에 반응하는 것이고, 이런 Neuron은 noun보다는 verb처럼 이해하는 편이 더 적절합니다.
Neuron의 역할은 input에 무엇이 있는지 이름 붙이는 것이 아니라, downstream neuron들이 활용할 수 있는 구분을 만들어내는 것입니다. 예를 들어 positive pole과 negative pole에서 V와 O처럼 미묘하게 다른 두 pattern을 구분하고, 그에 따라 activation의 흐름을 서로 다른 Neuron 쪽으로 밀어주는 식입니다.
저는 어떤 Neuron을 이해하지 못할 때 종종 이렇게 자문합니다.
“noun group을 전혀 사용할 수 없다면, 이 Neuron을 다른 사람에게 어떻게 설명할 것인가?”
그러면 대개 shared pattern이 바로 드러납니다. 그리고 그 pattern을 다른 noun group에서도 쉽게 검증할 수 있습니다. V neuron의 경우 shinkansen이나 pool table 같은 대상에서도 확인할 수 있습니다.
저는 이것이 mid-layer neuron에서 Polysemanticity가 잘못 귀속되는 가장 큰 원인일 가능성이 있다고 생각합니다. 제가 본 많은 설명에서는 하나의 pattern을 여러 noun의 목록으로 표현해놓고, 그 Neuron을 polysemantic하다고 부르는 경우가 많았습니다.
두세 가지 의미를 가진 Neuron이 있다면, 그것을 몇 개의 의미가 묶여 있는 하나의 Neuron으로 봐야 합니다. 이런 grouping은 아마 Network에게는 문제가 아니었을 것입니다. 그 의미들이 함께 있는 이유는 Network의 관점에서는 서로 비슷하기 때문입니다.
( “Network 입장에서는 이 셋 사이에 어떤 공통점이 있었던 것 아닐까?” )
따라서 이런 grouping은 Network가 어떻게 생각하는지를 보여주는 단서가 될 수 있습니다. 그리고 이를 따라가다 보면, 여기서 cat과 car의 사례처럼 우리가 몰랐던 Generalization을 발견할 수도 있습니다.
또한 추가적인 의미들 중 상당수는 자세히 들여다보면 사라지기도 합니다. 실제로는 중요하지 않거나 거의 Activation되지 않는 작은 현상인 경우가 많습니다.
마지막으로, 일부 apparent meaning은 단순히 Tool이 좋지 않아서 생긴 착시일 수 있습니다. 이 에세이에는 그런 사례가 여러 개 나옵니다. SwiGLU의 Double-negative Regime, Residual Stream을 시각화하기 어렵게 만드는 unread saliency knob, 그리고 방금 본 Feature Visualization의 Reward Hacking이 그 예입니다.
(
예를 들어:
- Feature Visualization을 돌렸더니 dog가 나옴 → 실제로 dog Feature인 게 아니라 Visualization optimization이 dog 쪽으로 잘못 빠진 것일 수 있음
- SwiGLU의 Double-negative Regime을 Tool이 구분하지 못함 → 서로 다른 activation pattern을 하나의 의미처럼 섞어서 보여줄 수 있음
- Residual Stream도 특정한 saliency knob 때문에 Visualization이 왜곡될 수 있음
)
원래 Neuron을 그대로 유지해서 분석하면 이런 오류가 눈에 보이는 상태로 남아 있기 때문에, 계속해서 error correction을 할 수 있습니다. 만약 더 깔끔한 Feature 목록을 얻기 위해 Optimization으로 Neuron을 분해하거나 정리했다면, 이런 단서들 상당수를 잃어버렸을 수도 있습니다.
A History of Microscope Errors
제가 보기에 Interpretability의 역사는 대체로, 우리가 microscope 아래에서 보고 있던 대상이 생각보다 더 잘 되어 있었다는 사실을 계속 발견해온 역사였습니다. 문제는 microscope의 tuning이 제대로 되어 있지 않았다는 것이고, 그 tuning에서 필요한 수정은 종종 꽤 미묘했습니다.
현대 Neural Network Interpretability는 Feature Visualization에서 시작됐다고 볼 수 있습니다. Feature Visualization은 어떤 Neuron이 가장 강하게 반응하는지를 synthetic image로 렌더링하는 방법입니다. 그 유명한 psychedelic image들이 바로 그것입니다.
한동안 그 결과는 그다지 좋아 보이지 않았습니다. 그래서 Neuron이 무언가를 학습하긴 했지만, 그다지 깔끔한 것은 학습하지 못했다고 결론 내리는 것도 충분히 자연스러웠습니다. 그런데 실제로는 방법에 transformation robustness가 빠져 있었습니다. 연구자들이 이를 추가하자, 같은 Neuron들이 훨씬 선명하고 깔끔하게 나타났습니다.
하지만 그것만으로는 Model의 깊은 부분까지 충분히 볼 수 없었습니다. 뒤쪽 Layer에 가까워지면 Feature Visualization이 다시 제대로 작동하지 않기 시작했는데, 이유는 두 가지였습니다. 하나는 앞서 car circuit에서 본 Reward Hacking이고, 다른 하나는 제대로 설정되지 않은 Regularization이었습니다.
이를 고치는 데 특별히 복잡한 방법이 필요했던 것은 아닙니다. 합리적으로 보이던 설정 몇 가지를 미묘하게 조정했을 뿐인데, 이제 Network의 훨씬 더 깊은 부분까지 볼 수 있게 되었습니다.
같은 Neuron이었습니다. 달라진 것은 microscope였습니다.
( Interpretability에서 발견한 ‘복잡함’ 중 일부는 Network 자체의 복잡함이 아니라 관찰 도구의 오류였다는 역사를 말하는 부분 )
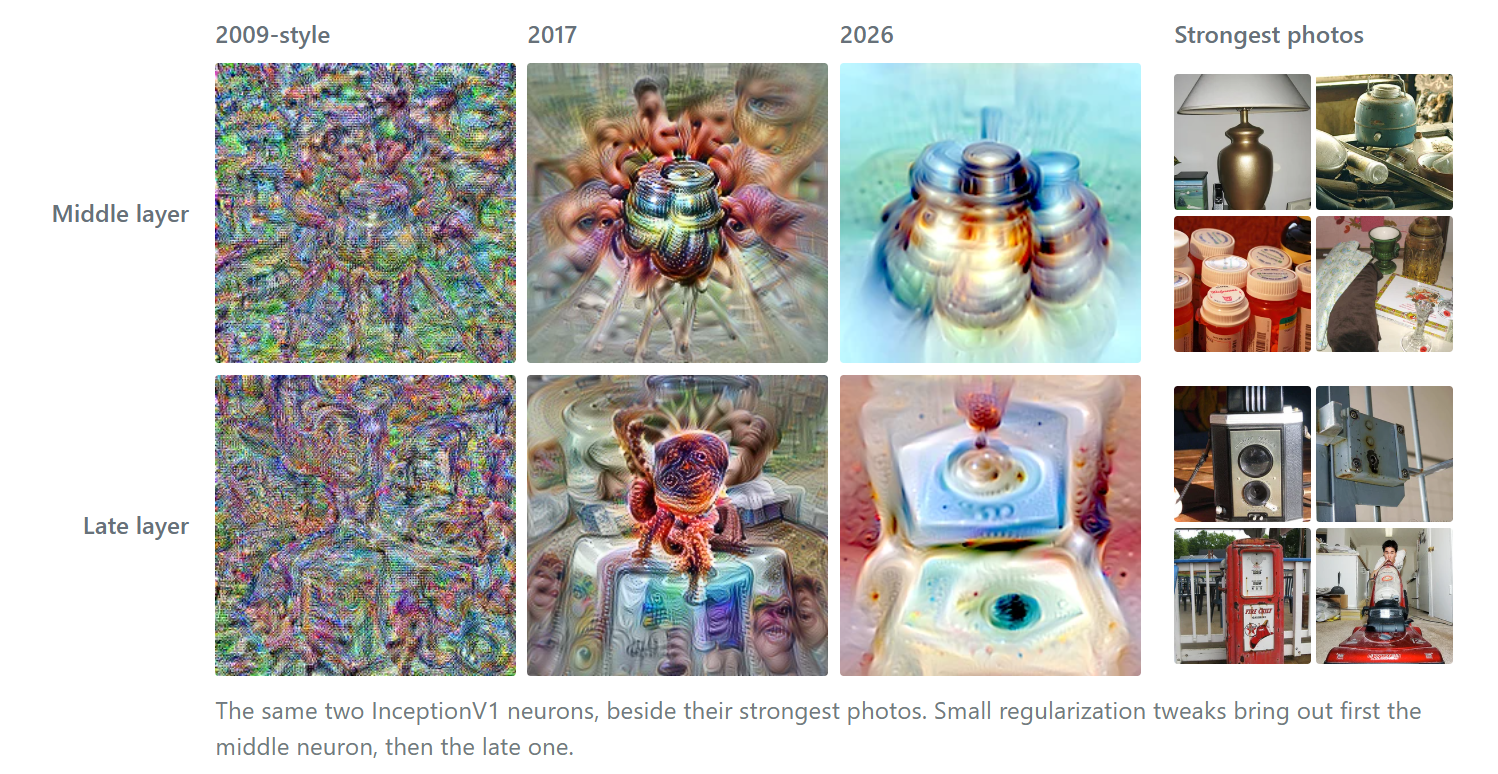
- 2009-style: 거의 psychedelic noise처럼 보여서 Neuron이 무엇을 보는지 알기 어려움.
- 2017: transformation robustness 같은 개선이 들어가면서 훨씬 구조적인 이미지가 나타남. 특히 Middle layer Neuron은 뭔가 둥글고 원통형인 물체 구조가 꽤 보이기 시작함.
- 2026: Regularization을 더 조정하자 구조가 훨씬 선명해짐. Middle layer에서는 병·용기·램프처럼 보이는 둥근 몸체 + 윗부분 구조, Late layer에서는 카메라·기계·가전처럼 보이는 기계적인 물체 구조가 나타남.
- Strongest photos: 실제 dataset에서 그 Neuron을 가장 강하게 활성화한 사진들. Feature Visualization이 제대로 된 방향을 보여주고 있는지 비교하기 위한 기준임.
하지만 문제가 전부 microscope에만 있었던 것은 아닙니다. Model 자체도 tuning이 필요했습니다.
이 분야에서 초기 model organism 역할을 했던 InceptionV1은 late layer에서 거의 완전히 해석 불가능한 수준이었습니다.
한 추정에서는 이렇게 말했습니다.
“제가 아는 한, InceptionV1의 final layer에는 사실상 interpretable neuron이 거의 없습니다.”
이건 제 기억과도 꽤 비슷합니다. 저는 아마 5% 정도는 interpretable하다고 말했을 것 같습니다.
당시 late-layer neuron들은 대략 이런 모습이었습니다.
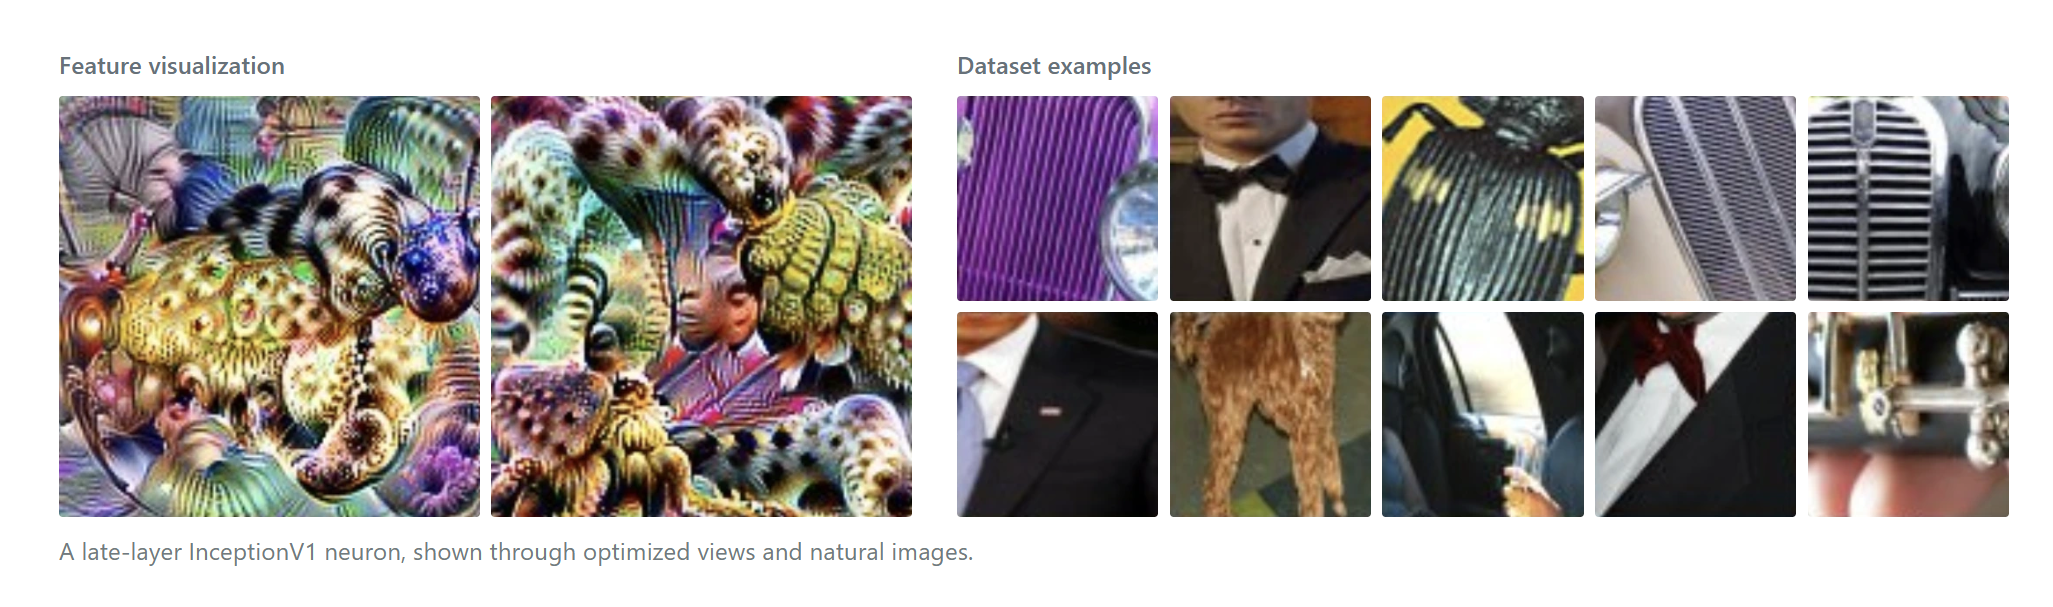
( 그림은 InceptionV1의 late-layer Neuron 하나가 왜 당시 거의 uninterpretable하게 보였는지 보여주는 예시 )
제가 알기로 당시 가장 유력한 설명은 이랬습니다. 높은 Layer로 갈수록 표현해야 할 Feature는 너무 많은데, 사용할 수 있는 Neuron과 Parameter 수는 한정되어 있기 때문에, 서로 충돌하지 않는 Feature들을 서로 관련이 없어도 임의로 같은 표현 공간에 packing하기 시작한다는 것이었습니다.
반대로 early layer가 monosemantic했던 이유는 초기 Layer에서 표현해야 할 Feature의 수가 상대적으로 적었기 때문이라고 봤습니다.
하지만 이 설명은 맞지 않았습니다.
여기 같은 Dataset을 사용하고 Parameter 수도 동일하지만, Residual Connection, LayerNorm, 그리고 몇 가지 다른 개선점이 들어간 더 현대적인 Convolutional Network가 있습니다.
이 Network의 last layer는 놀랄 만큼 깔끔합니다.
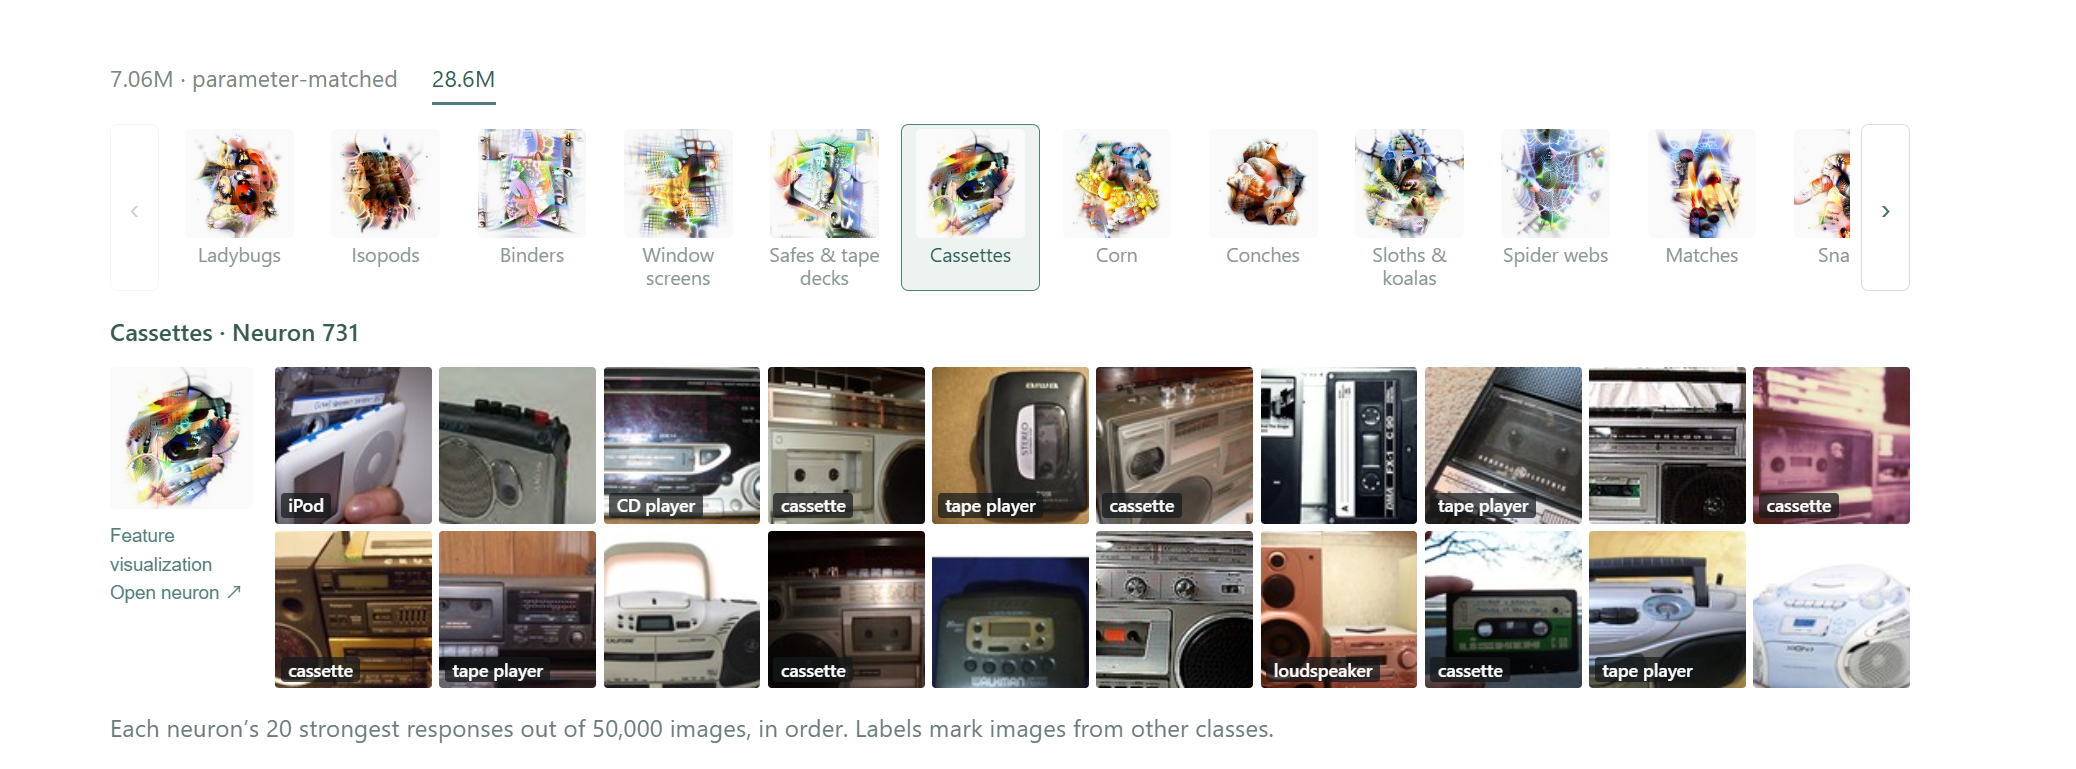
( 현대 architecture에서는 last-layer Neuron 하나가 거의 “cassette / tape-player 계열”이라는 깔끔한 역할을 가진다 )
그래서 두 가지가 필요했습니다.
첫째, Neural Network 자체가 잘 학습되어야 했습니다. 그리고 그 Architecture는 Interpretability에는 관심이 없고, 오로지 학습 성능을 높이는 데 집중한 사람들이 설계한 것이어도 충분했습니다. Residual Stream이 한 예입니다. 원래는 더 깊은 Neural Network를 잘 학습시키기 위해 도입됐지만, 결과적으로 깊은 Layer의 개념적 구조를 더 깔끔하게 만드는 데도 도움이 되는 것처럼 보입니다. 두 현상은 서로 관련이 있을 수도 있습니다.
둘째, 그 Neuron들을 명확하게 볼 수 있을 만큼 강한 Tool이 필요했습니다.
InceptionV1의 last layer는 한때 Neural Network가 거의 근본적으로 uninterpretable하다는 주장을 뒷받침하는 주요 증거 중 하나였습니다. Network가 학습할 때 서로 unrelated한 것들을 겹쳐 섞어 표현하기 때문에, Neuron 자체를 다른 표현으로 대체하는 방법밖에는 없어 보였습니다.
당시 Tool을 기준으로 저는 interpretable neuron의 비율을 약 5% 정도로 봤고, 다른 사람들은 거의 0%라고 보기도 했습니다.
하지만 더 나은 Interpretability Tool, 예를 들어 개선된 Feature Visualization이나 Attribution을 시각화하는 방법 등을 사용하면 같은 Network에서도 약 50% 정도가 interpretable하게 보입니다.
이건 모두 2014년에 만들어진 원래 Model을 기준으로 한 결과입니다. 당시 checkpoint와 training detail은 지금은 거의 남아 있지 않습니다.
같은 Architecture를 더 합리적인 현대식 Regularization으로 다시 학습하면 약 70% 정도까지 올라갑니다.
그리고 같은 크기의 ConvNeXt에서는 약 99% 정도가 interpretable합니다.
이 Neuron들은 링크에서 직접 탐색해볼 수 있습니다.
https://already-clean.goodfire.com/microscope/medium.html
( 같은 InceptionV1도 Tool을 개선하면 해석 가능 비율이 올라가고, 같은 Architecture를 현대식 Regularization으로 다시 학습하면 더 올라가고, ConvNeXt처럼 Architecture까지 현대화하면 거의 99%까지 간다는 주장 )
Recursive Generalization
그래서 우리는 last layer가 고칠 수 있는 문제였다는 것을 보여줬습니다. 그렇다면 고치기 전에는 대체 무엇을 하고 있었을까요?
Architecture가 개선되기 전에도, Network가 서로 unrelated한 것들을 임의로 한데 묶고 있었던 것은 아니었습니다.
Model을 다시 학습하면서 어떤 Neuron이 형성되는 과정을 관찰해보니, 처음에는 yellow flower에 반응하기 시작했습니다. 그리고 그런 사진들에는 가끔 dog도 함께 등장했습니다.
이후 그 Neuron은 그 사진들이 가진 각각의 특성을 따라 확장되었습니다.
- 다른 종류의 nature 쪽으로
- ball 같은 green object 쪽으로
- flower가 전혀 없는 dog 쪽으로
제가 살펴본 모든 Neuron에서 이런 현상이 나타났습니다.
개선된 Architecture에서도 같은 pattern은 보였지만, 그 정도는 훨씬 약했습니다.
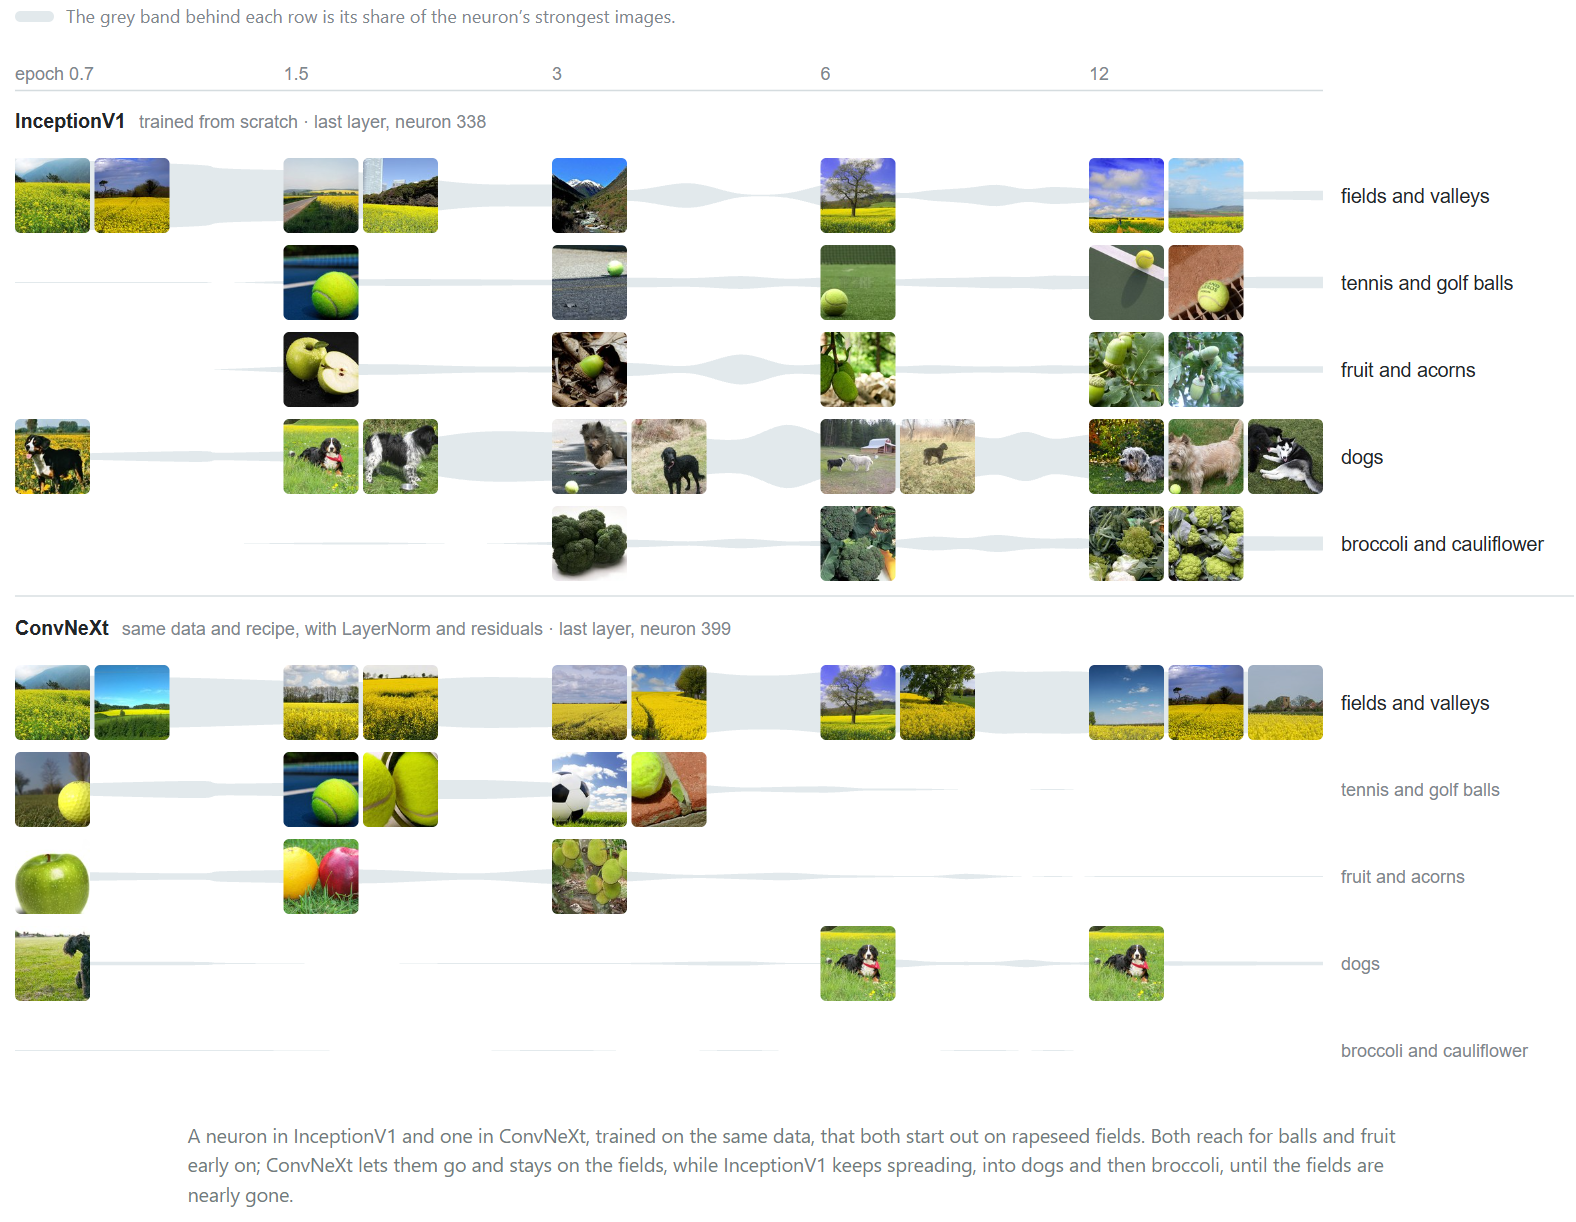
우리는 이것을 Recursive Generalization이라고 부릅니다. 하나의 Neuron이 둘 이상의 axis를 따라 Generalization하는 현상입니다.
대개 처음에는 한 axis를 따라 Generalization하다가, 이후에는 local하게 보면 쉽게 따라갈 수 있는 방식으로 바깥쪽으로 가지를 뻗기 시작합니다. 하지만 그렇게 확장된 결과, 최종적으로는 더 이상 “monosemantic”하다고 보기 어려워집니다.
예를 들어 어떤 Language Model Neuron이 처음에는 "iy"에 반응하고, "Miyazaki" 안의 "iy"에도 반응한다고 해봅시다.
그다음에는 "diy"에도 반응하고, 이후에는 "iy"라는 문자열이 전혀 들어 있지 않은 "do it yourself"에도 반응하게 됩니다.
즉 하나의 출발점에서 의미적으로 연결되는 방향을 따라 계속 가지를 뻗으면서 Neuron의 반응 범위가 넓어지는 것입니다.
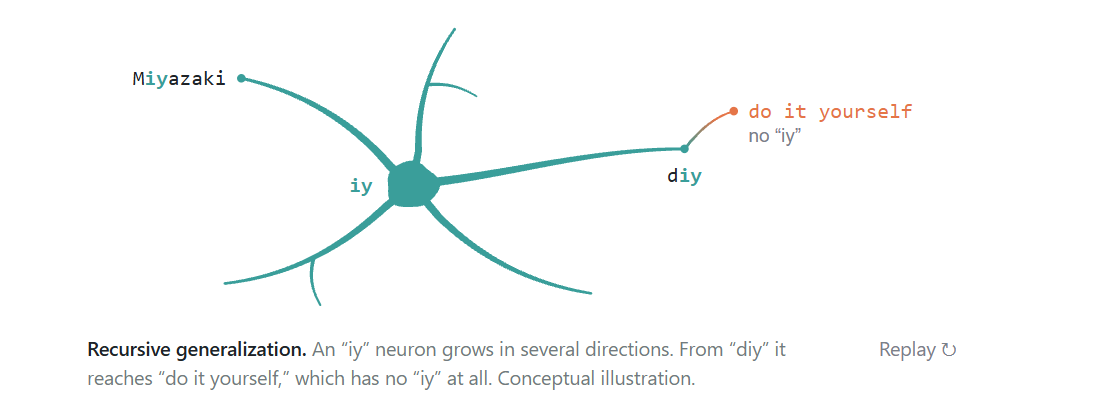
Image Model과 Language Model 모두에서 이런 사례를 아주 많이 볼 수 있습니다. 예를 들어 geology neuron이 Cesium이라는 geology 관련 JavaScript library 쪽으로까지 Generalization되는 경우가 있습니다.
보통은 무슨 일이 일어난 건지 너무 분명해서, 이걸 굳이 Recursive Generalization이라고 따로 불러야 할지 아니면 그냥 normal Generalization이라고 해야 할 애매할 정도입니다. 예를 들어 enemy neuron이 ‘enemy’에 관한 러시아 시에도 반응하는 경우가 그렇습니다.
어떤 경우에는 연결이 덜 분명하지만 그래도 충분히 그럴듯합니다. 예를 들어 Srinivasen neuron이 UniProt protein database에도 약하게 반응하는 경우가 있습니다. 그 project와 연관된 Srinivasen이라는 이름의 사람들이 여러 명 있기는 하지만, 정말 그 연결 때문에 반응하는 것인지는 확실히 알기 어렵습니다.
( 즉 처음 의미에서 연관된 다른 의미로 반응 범위가 넓어지는 사례가 많다는 말 )
이런 Recursive Generalization으로 생긴 offshoot들이 실제로 얼마나 중요한지는 뒤의 Language Model 섹션에서 다룰 것입니다. 여기서는 일단 이 motif가 무엇인지 자체만 설명하려고 합니다.
우리는 사실 2021년 Multimodal Neurons에서 이미 이 현상을 조금 언급한 적이 있습니다. 당시에는 이런 것들을 **“conjoined features”**라고 불렀습니다.
저는 Recursive Generalization을 몇 달 동안 연구한 뒤, 이 분야의 유명한 Model들을 다시 돌아보다가 그 사실을 떠올렸습니다. 제가 기억하기로는, 당시에는 저를 포함해 아무도 이것이 일반적인 설명일 수 있다고 제안하지 않았습니다.
예를 들어 InceptionV1의 last layer가 왜 그렇게 난잡했는지를 설명하는 일반 원리라고는 생각하지 않았다는 뜻입니다.
당시에는 training checkpoint가 없어서 이런 현상이 실제로 어떻게 형성되는지 직접 볼 수는 없었습니다. 하지만 당시의 “conjoined features”라는 설명 자체는 본질적으로 맞았습니다.
Appendix에서는 왜 저자가 이제 conjoined features보다 Recursive Generalization이라는 이름이 더 정확하다고 생각하는지 설명합니다.
( 예전에 부분적으로 봤던 conjoined features가 사실은 훨씬 일반적인 현상이었고, 그걸 Recursive Generalization이라고 부르는 게 더 적절하다. )
Superposition
Recursive Generalization은 특별히 대담한 설명은 아닙니다. 어떻게 보면 ordinary Generalization에서 자연스럽게 기대할 수 있는 현상이라고 할 수 있습니다.
하지만 Polysemanticity를 설명하기 위해 제안된 훨씬 더 대담한 설명, 즉 새로운 learning principle도 있습니다.
우리가 어디에서나 가장 흔하게 보는 learning principle은 Generalization입니다. Generalization에서는 서로 공유하는 pattern이 있기 때문에 여러 대상이 함께 묶입니다. 그렇게 한곳에 모아두면 이후 computation이 그 공통 pattern 위에 더 쉽게 쌓일 수 있기 때문입니다.
반면 Superposition에서는 서로 unrelated한 것들이 서로 간섭하지 않는다는 이유로 함께 배치됩니다.
이 둘은 서로 반대되는 prediction을 만듭니다. Generalization은 local해야 하고, Superposition은 non-local해야 합니다. Superposition은 서로 아주 다른 것들을 가까이 배치하려 할 것이기 때문입니다.
Generalization이라면 floppy ear dog neuron 같은 것을 원할 것입니다. 다양한 각도와 종류의 조금씩 다른 floppy ear들이 함께 묶여 있는 형태라고 볼 수 있습니다.
반면 Superposition이라면 floppy ear dog + Latin poetry neuron 같은 것을 원할 것입니다.
(Generalization이든 Superposition이든 feature를 정하기 나름인데, 그 결론은 서로 상반된다.)
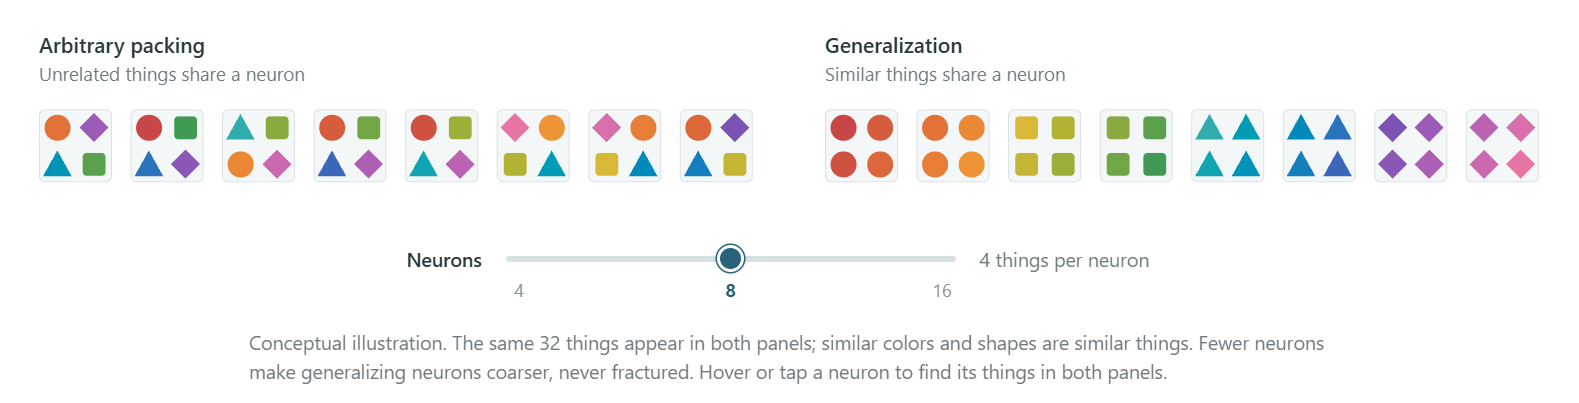
Superposition → unrelated Feature를 arbitrary하게 같이 넣음
Generalization → similar Feature를 하나의 공통 pattern으로 묶음
여기서는 정의가 조금 꼬입니다. Superposition과 함께, Zoom In에서는 Feature를 Neural Network의 fundamental unit으로 보는 관점을 제시했습니다.
그런데 어디를 보느냐에 따라 Superposition은 서로 다른 뜻으로 쓰입니다.
어떤 곳에서는 “dimension보다 Feature가 더 많은 상태”를 의미합니다. 그런데 이 정의라면 완전히 monosemantic한 Network조차도 Superposition을 만족할 수 있습니다. 왜냐하면 Neuron들이 서로 조합되어 더 많은 Feature를 만들어낼 수 있기 때문입니다.
다른 곳에서는 Superposition이 앞에서 설명한 것처럼 하나의 learning principle을 의미합니다. 그리고 이 원리는 어떤 경우에는 Neuron이 무엇을 학습하는지에 적용되고, 어떤 경우에는 Feature들이 어디에 배치되는지에 적용됩니다.
즉 “Superposition”이라는 용어 자체가 여러 가지 흔한 의미 사이에 겹쳐서 사용되고 있는 셈입니다.
이 글에서는 Neuron 같은 mechanism에 적용되는 learning principle로서의 Superposition에 집중합니다. 왜냐하면 이런 형태의 Superposition이 실제로 형성되는지는 Interpretability에 좋은 소식인지 나쁜 소식인지를 결정하는 데 매우 큰 비중을 차지하기 때문입니다.
또 이것은 비교적 테스트하기도 쉽습니다. Recursive Generalization과 Superposition은 거의 반대되는 prediction을 내놓기 때문입니다. Neuron이 학습 과정에서 어떻게 성장하는지를 직접 관찰하면 어느 쪽이 실제로 일어나는지 볼 수 있습니다.
그래서 이 글에서 제가 Superposition이라고 말할 때는 이 learning principle 버전을 의미합니다.
그리고 “Feature 수가 dimension 수보다 많다”는 의미의 Superposition에 대해서는 뒤에서 따로 다룰 것입니다. 저자는 기본적으로 그 자체는 Interpretability에 나쁜 소식이라고 생각하지 않습니다.
저자는 이 글에서 Superposition을
서로 unrelated한 Feature들이 충돌하지 않는다는 이유로 같은 Neuron / mechanism에 묶이는 learning principle
Superposition of the Gaps
Polysemanticity는 종종 Neuron 자체에 대한 주장이라기보다 관찰자에 대한 주장에 가깝습니다. 즉, 아직 좋은 설명을 찾지 못했다는 뜻입니다. 그럴 수 있는 이유는 몇 가지가 있습니다.
- Bad tools: 우리가 사용하는 lens나 microscope가 충분히 좋지 않음
- Bad explanations: 그런 Tool을 바탕으로 잘못된 설명을 만듦
- Bad learning: 좋지 않은 Architecture, training data, 혹은 다른 이유 때문에 Network가 제대로 학습하지 못함
- Recursive generalization: Generalization하는 과정에서 Neuron이 몇몇 related direction으로 분기함
- Superposition: learning principle 자체가 바뀌어, 서로 거의 충돌하지 않는 unrelated한 것들을 같은 Neuron에 packing함
저는 수년 동안 Superposition을 강하게 믿는 쪽이었습니다.
제가 Language Model Neuron을 연구하기 시작한 것도 Neuron이나 Superposition 자체에 관심이 있어서가 아니라, Agent들이 research taste를 가지고 있는지에 관심이 있었기 때문입니다.
저는 Agent들이 설명을 테스트하면서 좋은 질문을 던질 수 있는지 보고 싶었고, Neuron은 그저 baseline으로 시작했습니다.
저는 Agent들이 결국 Superposition 속에서 풀기 어려운 Feature fragment들과 마주칠 거라고 예상했습니다. 그러면 실제 Neuron이 얼마나 깔끔한지에 대한 새로운 baseline을 만들 수 있고, 이후 Agent들은 더 깔끔한 learned basis를 가지고 계속 연구할 수 있을 거라고 생각했습니다.
하지만 그런 순간은 오지 않았습니다.
왜냐하면 Neuron들을 계속 조사할수록, 놀라운 prediction을 내놓으면서도 실제로 맞아떨어지는 단순한 설명으로 계속 정리됐기 때문입니다.
어떤 frontier Language Model에서, 저는 주로 "pr"에 반응하지만 Base64 URL string 여러 개와 일부 Bengali에도 반응하는 Neuron을 발견했습니다.
저는 이것이야말로 드디어 arbitrary mixture라고 생각했습니다.
하지만 URL을 decode해보니 "pr" 관련 단어들이 나왔습니다.
Bengali를 번역해보니 역시 "pr"였습니다.
( Superposition이 기본 설명일 거라 생각했는데, 실제로 계속 검증해보니 오히려 Generalization 쪽 설명이 자꾸 살아남더라 )
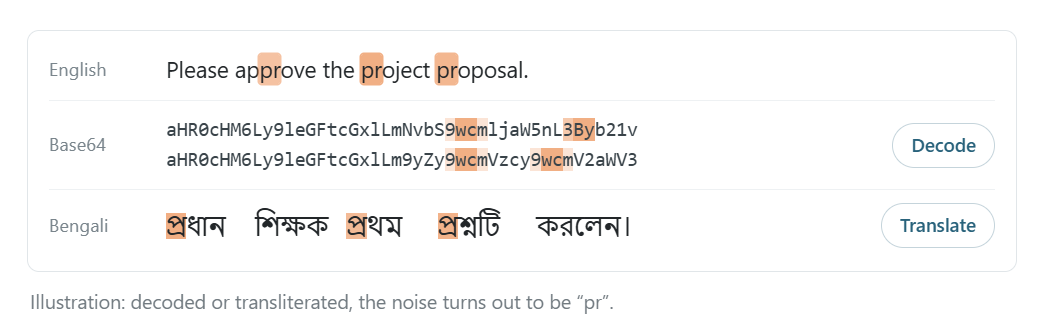
unrelated한 세 Feature가 한 Neuron에 섞인 것처럼 보여서 Superposition 같아 보이는 것도 까보면 같은 패턴
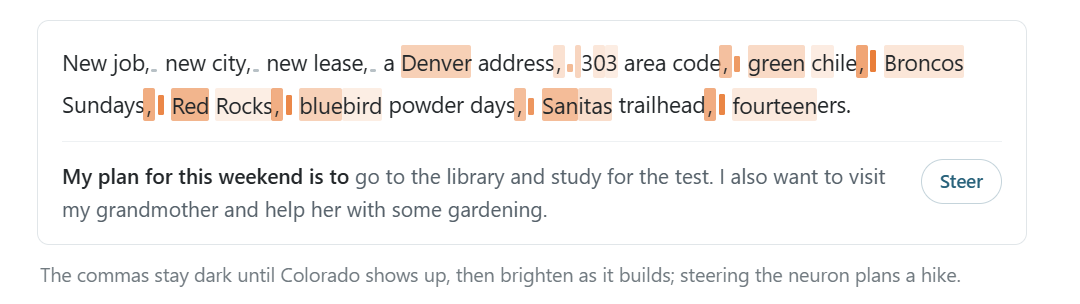
Dense Qwen Model에서 제 동료가 어떤 Neuron 하나를 발견했는데, standard top-k automated interpretability에서는 이 Neuron을 “polysemantic comma neuron”이라고 분류하고 있었습니다.
그런데 더 자세히 살펴보니, 실제로는 Colorado를 추적하는 Neuron이었습니다. Colorado의 phone number, slang, 그리고 다른 Colorado neuron들과의 connection에 반응했습니다.
이 Neuron을 steering하자 Model이 hiking을 가고 싶어 하는 방향으로 바뀌었습니다.
그렇다면 comma에는 왜 반응했을까요? comma 위치에 그 시점까지의 Colorado context에 대한 running summary를 저장하고 있었기 때문입니다.
일반적으로 Attention은 punctuation 위치에 모이는 경향이 있는 것처럼 보이는데, 우리는 이것을 summary motif라고 부릅니다.
이 pattern을 알고 나면, 비슷하게 보이는 많은 Neuron들을 훨씬 쉽게 이해할 수 있습니다.
다른 경우에는, 단순히 우리가 충분한 data를 가지고 있지 않았던 것뿐이었습니다.
처음에는 long context를 포함하지 않았습니다. 두 paragraph 정도면 충분하다고 생각했기 때문입니다.
그런데 이 때문에 우연히 long-context neuron들이 전부 polysemantic하게 보이는 현상이 생겼습니다.
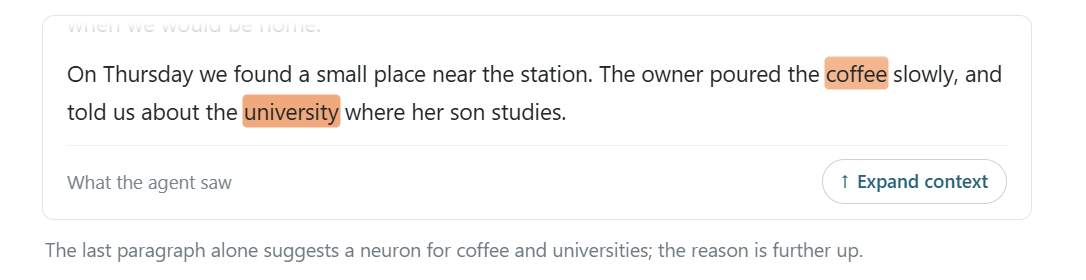
( Model 안에는 훨씬 앞쪽 context까지 반영해서 반응하는 Neuron이 있을 수 있는데, Interpretability 분석할 때 짧은 문단만 잘라서 보면 그 원인을 못 볼 수 있다. )
또 다른 사례에서는 어떤 Neuron이 완전히 arbitrary한 혼합처럼 보였고, 강하게 firing하는 것도 거의 없었습니다. 그런데 알고 보니 이 Neuron은 health SEO spam 페이지 안에서 특정한 sign들을 찾고 있었습니다. 충분히 넓은 Dataset을 확보하고 나서야 그 역할을 이해할 수 있었습니다.
이런 사례를 수백 개 봤지만, 그동안에도 Superposition에 대한 제 믿음은 흔들리지 않았습니다.
Superposition이 있다는 위치만 계속 뒤로 밀려났습니다.
강한 activation들이 깔끔하게 설명되면, 저는 Superposition이 약한 activation들에 있을 거라고 생각했습니다. 그것도 아니면 여러 Neuron의 combination에 있을 거라고 생각했고, 아니면 아직 제가 보지 않은 Neuron들에 있을 거라고 생각했습니다. 혹은 Layer 사이에 있을지도 모른다고 생각했습니다.
하지만 어느 순간, 대체 무슨 일이 벌어지고 있는 건지 의문이 들었습니다. 이것이 극단적으로 긴 selection bias 사례가 아니라면, 초기의 model organism에서 봤던 것과 실제 상황이 맞지 않고 있었습니다.
그래서 저는 다시 돌아가 원래의 evidence를 검토했고, 그 evidence가 무너졌습니다. 그리고 그것이 이 essay로 이어졌습니다.
이제 저는 Superposition을 null hypothesis로 두고 있었던 것이 잘못이었다고 생각합니다. 오히려 Superposition은 가장 radical하고, 가장 test하기 어려운 설명이기 때문에 마지막 hypothesis가 되어야 했습니다.
Superposition은 그냥 말이 안 되는 것처럼 보이는 현상과 비슷하게 보입니다.
하지만 말이 안 되는 것처럼 보이는 현상은 다른 이유로도 생깁니다.
- Bad tool 때문일 수 있습니다. 예를 들어 Feature Visualization의 Reward Hacking
- 아직 끝까지 따라가지 못한 Recursive Generalization 때문일 수 있습니다. 예를 들어 "iy" neuron
- Bad architecture 때문일 수 있습니다. 예를 들어 InceptionV1의 5b
- 아직 이해하지 못한 Generalization 때문일 수 있습니다. 예를 들어 cat과 car
제가 보기에는, 당시에는 Superposition이라는 설명이 그냥 직관적으로 그럴듯하게 느껴졌던 것도 한몫했습니다.
Anthropic의 2022년 Softmax Linear Units 논문에서도 비슷한 말을 했습니다.
“Mechanistic Interpretability community에서는 다른 설명보다 직관적으로 더 매력적으로 느껴진다는 이유만으로 Superposition을 default hypothesis로 취급하는 경우가 많지만, 실제 evidence는 거의 없다.”
제가 아는 한, 실제 Network에서 Superposition circuit이 발견된 사례는 제가 예전에 보고했던 원래 사례 이후로 없습니다. 그런데 그 사례조차 제가 잘못 해석한 것이었습니다.
저 역시 실제 Model에서 그런 구조를 볼 거라고 예상했지만, 실제로는 그런 것을 거의 보지 못했습니다.
그리고 Superposition은 매우 radical한 설명이며, Neural Network를 어떻게 연구해야 하는지에 대해 아주 크고, 아주 나쁜 소식이 될 수 있기 때문에, 저는 이제 Superposition을 주장하기 위한 evidence의 기준은 높아야 한다고 생각합니다.
물론 여기에는 반대 방향의 오류도 생길 수 있습니다. 즉 설명되지 않는 부분을 억지로 설명하려 하면서, 모든 Neuron에는 반드시 말이 되는 story가 있어야 한다고 가정하는 오류입니다.
하지만 두 가지 이유 때문에 저는 이 위험이 상대적으로 덜 걱정됩니다.
첫째, 다른 원인들은 각각 test할 수 있습니다.
더 좋은 Tool을 쓰면 Neuron이 설명되는지 아닌지 확인할 수 있습니다. 더 좋은 Architecture로 retraining하면 learning 자체가 문제였는지 확인할 수 있습니다. Recursive Generalization은 training 과정에서 작은 step으로 어떻게 자라나는지 직접 관찰할 수 있습니다.
반면 Superposition의 유일한 symptom은 “이게 이해가 안 된다”는 것뿐입니다.
둘째, 실제로 좋은 explanation은 대개 좁고 쉽게 test할 수 있습니다.
어떤 Neuron이 Colorado neuron이라고 의심된다면, 그 Neuron을 steering해보고 Model이 무엇을 말하는지 보면 됩니다.
어떤 Neuron이 특정한 TV trope에 반응한다고 생각한다면, 그 설명에 들어맞을 수 있는 경우의 수는 매우 제한적입니다.
반면 “뭔가 이해가 안 된다”는 설명은 그 바깥의 모든 경우를 다 포함합니다.
그리고 우리가 아직 설명을 가지고 있지 않다고 해서 억지로 설명을 만들어낼 필요도 없습니다.
어떤 Neuron이 서로 unrelated한 몇 가지 역할을 할 수도 있는데 확신이 없다면, 그냥 그렇다고 말해도 됩니다.
저는 이제 Recursive Generalization은 먼저 의심해볼 후보 중 상당히 위에 있어야 한다고 생각합니다. Training checkpoint가 있다면 확인하기도 쉽습니다.
반대로 Superposition은 의심 목록에서 훨씬 아래쪽에 있어야 한다고 생각합니다.
( 이해 안 되는 Neuron이 나왔다 → 바로 Superposition이라고 하지 말고, 먼저 검증 가능한 다른 설명들을 다 확인하자. 그래도 안 되면 그냥 ‘아직 모른다’고 두고, Superposition은 맨 마지막에 의심하자. )
Exploring Image Models
작은 Image Model들은 이제 구식처럼 보일 수도 있지만, 저는 이 질문을 연구하는 데 오히려 매우 중요하다고 생각합니다. 우리가 훨씬 명확하게 볼 수 있기 때문입니다.
그리고 원래의 우려가 많이 시작된 곳도 바로 이런 작은 Image Model들이었습니다. 당시 우리가 본 것은 낮은 resolution 때문에 애매해진 모습이 아니라, 높은 resolution에서도 혼란스러워 보이는 모습이었습니다.
Language Model은 거대하고, Feature Visualization처럼 분석을 쉽게 해주는 Tool도 없습니다. Attention은 서로 다른 종류의 mechanism들을 섞어버리고, 많은 motif들도 직관적이지 않습니다.
앞에서 보여드렸듯이 Vision의 motif조차 counter-intuitive할 수 있는데, Language에서는 상황이 더 어렵습니다.
이런 결함 하나하나는 실제로는 monosemantic한 Neuron을 polysemantic하게 보이게 만들 수 있습니다.
흐릿한 이미지를 보고 dog인지 cat인지 판단한다고 생각해봅시다. Blur는 판단을 어렵게 만들지만, dog나 cat 어느 한쪽을 특별히 더 지지하지는 않습니다.
하지만 흐릿한 이미지를 보면서
“이 이미지 자체가 흐린 건가, 아니면 내가 잘못 보고 있는 건가?”
를 판단하려고 한다면, 내 시력의 모든 결함이 이미지 자체의 blur로 잘못 계산될 수 있습니다.
그래서 Neuron이 scale, compression pressure, activation strength, depth에 따라 어떻게 변하는지 연구하려면, 우리가 가장 명확하게 볼 수 있는 곳에서 시작하는 편이 낫습니다.
저는 크기가 약 300배 차이 나는 세 개의 ConvNeXt Model을 학습했습니다.
- Small: 92k parameters
- Medium: 7.06M parameters, InceptionV1과 같은 크기
- Large: 28.6M parameters
이 세 Model과 InceptionV1을 함께 살펴보면서, 서로 다른 상황에서 Neuron이 어떻게 동작하는지, 그리고 어디에서 packing이 형성될 수 있는지 이해해보려고 합니다.
How I Think About Neurons
예전에는 Neuron을 사람에게 익숙한 noun처럼 생각했습니다.
하나는 car, 다른 하나는 curve 같은 식입니다.
이제는 Neuron을 control flow에 더 가까운 것으로 생각합니다.
Neuron은 무엇을 “보는가”보다, 들어오는 flow에 무엇을 하는가에 더 가깝습니다. 그리고 많은 경우 Neuron의 역할은 Network의 특정 region으로 들어가는 흐름을 gate하는 것입니다.
이렇게 보면 monosemanticity 자체가 거의 잘못된 질문일 수도 있습니다.
더 좋은 질문은
“이 Neuron은 무엇을 통과시키고, 무엇을 막는가?”
입니다.
Pixel이 들어오면, Network는 여러 것들을 묶고 구분하기 시작합니다.
Car와 dog는 같은 pose를 공유하기 때문에 처음에는 함께 묶일 수 있습니다.
더 뒤로 가면 taxi, ambulance 같은 구체적인 car detector들이 생깁니다. 그리고 이런 detector들은 dog가 들어오는 것을 원하지 않습니다.
그래서 그 앞에 있는 어떤 Neuron이 gate 역할을 합니다.
이 Neuron은 car에는 positive하게 반응하고, dog에는 negative하게 반응합니다. 그리고 negative side가 dog를 car 쪽 경로에서 막아냅니다.
Dog는 자기들만의 다른 region으로 이동하게 되고, 그쪽에서는 car를 신경 쓸 필요가 없습니다.
그 뒤의 Neuron들은 이 구분 위에서 더 specialization합니다.
예를 들어 ambulance neuron의 negative pole에는 taxi가 있을 수 있고, taxi neuron의 negative pole에는 ambulance가 있을 수 있습니다.
더 큰 Model에서는 이런 distinction이 더 세밀해질 수 있습니다. 예를 들어 taxi의 한 viewpoint와 다른 viewpoint까지 서로 구분할 수 있습니다.
반대로 더 작은 Model은 더 coarse한 distinction에서 멈출 수 있고, general한 "car" neuron에 가까운 형태가 될 수 있습니다.
Car와 dog는 pose를 공유하기 때문에 처음에는 같은 line으로 들어옵니다.
그 앞에 gate neuron이 있고, plus half에는 작은 car가, minus half에는 작은 dog가 있다고 생각하면 됩니다.
Car는 plus half를 통과하고, dog는 minus half에서 막혀 자기 line으로 떨어집니다.
그 dog line은 별도의 gate 없이 dog area로 이어집니다.
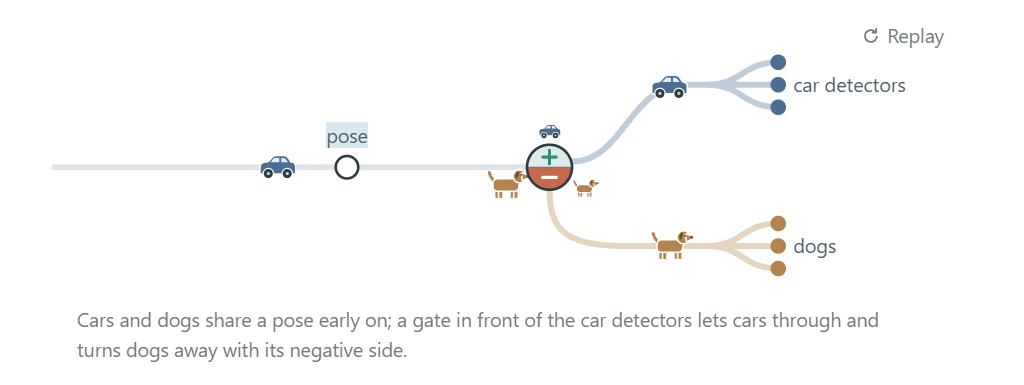
Neuron이 정말 polysemantic한지 보려면 먼저 작은 Image Model처럼 우리가 잘 볼 수 있는 환경에서 확인하자
저자는 Neuron을 “무엇을 보는 detector”보다 “정보 흐름을 나누는 gate”로 이해하는 게 더 낫다
여기 실제 sports car 이미지 하나를 large model의 마지막 5개 block을 따라가며 추적한 사례가 있습니다.
중간쯤에서는 이 sports car가 table이나 cabinet 같은 다른 rectangular shape들과 함께 묶이고, 반대쪽에는 snake나 dog가 놓입니다.
그리고 마지막 block에 도달하면 구분이 훨씬 더 세밀해져서, convertible과 station wagon을 나누는 수준까지 갑니다.
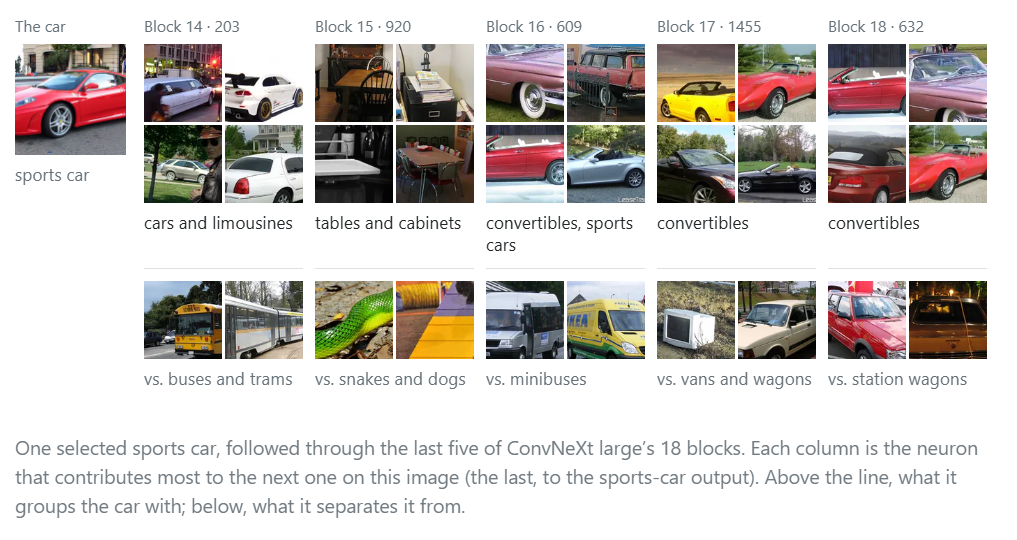
스포츠카 이미지 하나를 넣어서, 각 block에서 다음 단계에 contribution이 큰 Neuron을 하나씩 추적
그다음 그 Neuron들을 각각 따로 꺼내서,
- 실제 Dataset의 어떤 이미지에서 강하게 positive activation되는지
- 어떤 이미지에서 negative activation되는지
를 조사
Neuron의 negative side는 positive side만큼이나 Neuron을 이해하는 데 중요합니다. 심지어 negative side가 잘려 나가는 ReLU Network에서도 그렇습니다.
Neuron은 여러 개의 vote로 만들어집니다. 각각의 input weight가 positive side 또는 negative side 쪽으로 vote하고, 이 vote들은 nonlinearity를 통과하기 전에 모두 합쳐집니다.
Negative side 자체가 직접 gradient를 받는 것은 아니지만, Neuron이 활성화되어 있을 때 각각의 개별 vote들은 gradient를 받기 때문에 negative side 역시 learning에 의해 형성됩니다.
Negative side의 의미는 context에 따라 달라집니다. 예를 들어 sports car의 경로에 있는 어떤 Neuron이 sports car와 snake, dog를 구분한다고 해서 car와 dog가 서로 반대되는 개념이라는 뜻은 아닙니다. 단지 이전 단계에서 유용하게 함께 묶였던 것들 중에서, 이제 dog와 snake를 걸러내는 gate 역할을 하는 것입니다.
Negative side는 circuit의 현재 지점에서 어떤 distinction이 중요한지를 보여줍니다. 그래서 어떤 grouping이 실제로 존재하는지를 빠르게 확인하는 방법으로도 사용할 수 있습니다. 예를 들어 V neuron의 negative side에는 O가 있습니다.
Last layer를 보면 이런 high-level pattern과 그것이 무엇과 구분되고 있는지를 볼 수 있습니다.
예를 들면,
taxi와 ambulance,
broccoli와 cauliflower,
spoonbill과 flamingo
를 서로 구분하는 식입니다.
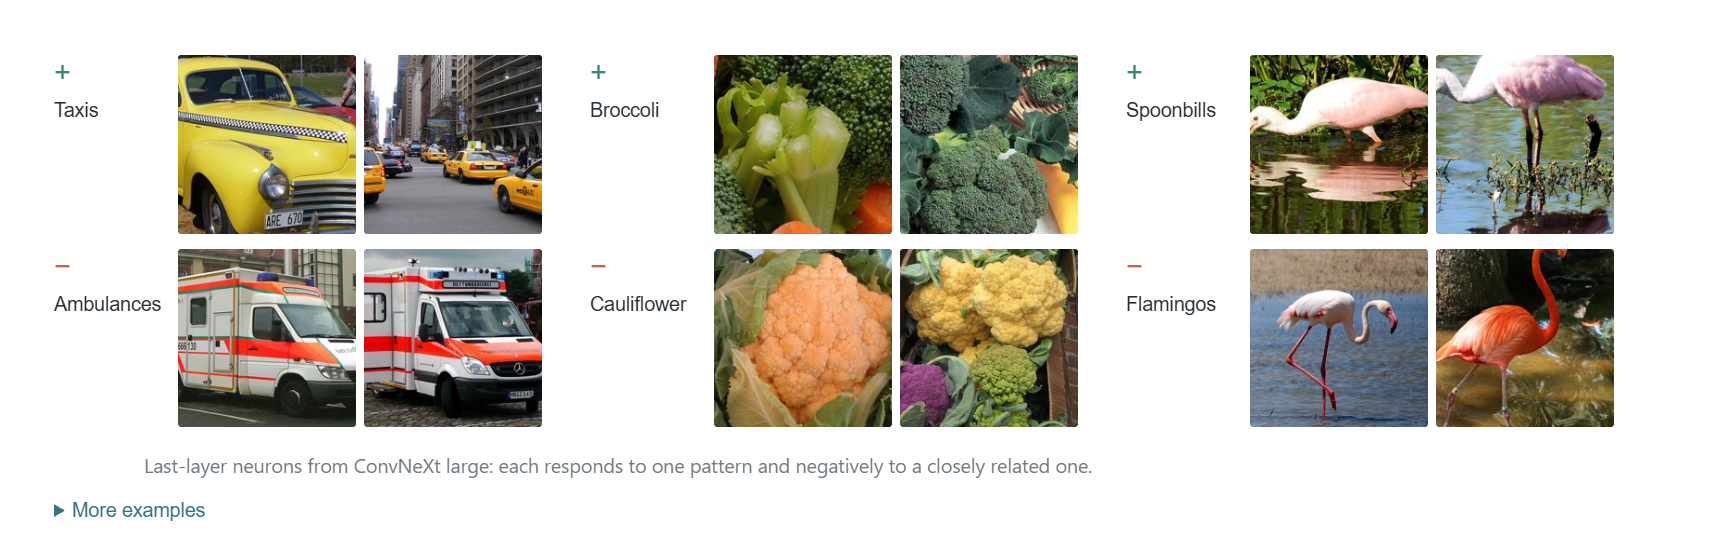
“이미 자동차/비슷한 vehicle context 안에 들어와 있는 것들 중에서, taxi 쪽 증거냐 ambulance 쪽 증거냐” 를 가르는 축 애 가까워보임 저자는 gate로 이해하길 원함
가장 작은 Model을 보면, Neuron들이 더 coarse한 구분을 하게 됩니다.
이 Model의 last layer에서는 하나의 Neuron이 cars, trains, carts를 한쪽에 묶고, negative side에는 boats, planes, 그리고 물 위에서 쓰는 ox-cart가 나타납니다. 저도 그런 게 실제로 있는지 몰랐습니다.
즉 여전히 무언가를 구분하고 있기는 하지만, 더 거친 수준에서 구분하고 있고, specialization이 더 일찍 끝납니다.
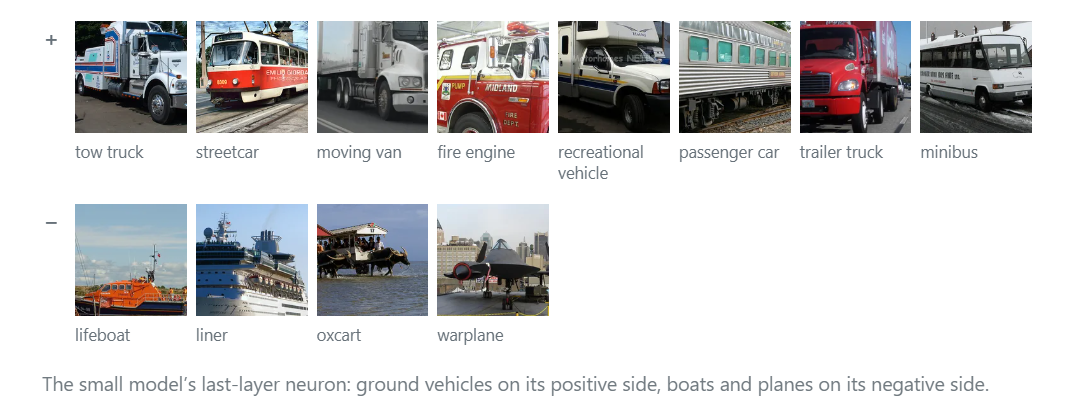
작은 Model은
ground vehicle ↔ boat/plane
정도의 훨씬 거친 distinction에서 끝나버린다 ㄷㄷ 저도 근데 oxcart 라는걸 처음 봤네요
What Neurons Do Under Pressure
대부분의 Vision Model에서 early layer는 monosemantic합니다. 제가 이해한 standard explanation은, early vision에서 표현해야 할 Feature의 수가 그렇게 많지 않기 때문이라는 것이었습니다.
그런데 겉으로 보면 조금 이상합니다. AlexNet, ResNet, InceptionV1, CLIP처럼 Dataset 크기와 Parameter 수의 비율이 매우 다른 Model들이 모두 early feature 수와 early neuron 수의 비율을 적절하게 맞추고 있는 것처럼 보이기 때문입니다.
집중해서 볼 수 있는 한 Layer는 InceptionV1의 3b입니다. 이 Layer에는 Curve Neuron과 High-Low Frequency Neuron이 있는데, 제 생각에는 이런 Neuron들이 가장 fundamental한 종류에 속합니다.
이 Model에는 residual stream이 없기 때문에 Neuron을 우회해서 information이 흘러갈 방법이 없습니다.
그래서 Neuron이 들어갈 공간이 부족해지면 무슨 일이 생기는지 직접 테스트할 수 있습니다. 원래 480개이던 Neuron을 10개로 줄인 뒤 다시 training하는 것입니다.
만약 이 상황에서 Network가 Superposition으로 전환한다면, 서로 겹쳐진 mixture들이 나타나야 합니다. 예를 들면 하나의 Neuron 안에
curve + orange spiral + spider web + 여러 texture detector
같은 것들이 동시에 섞여 있어야 합니다.
Neuron 수를 48배나 줄였으니, 그런 현상이 나타난다면 아주 극적으로 보여야 합니다.
하지만 실제로는 그렇지 않았습니다.
Neuron들은 여전히 interpretable하고 generalized한 상태로 남았고, 단지 더 coarse해졌습니다.
예를 들어 원래 여러 개의 curve detector가 따로 있었다면, 이제는 하나의 “curves & loops” neuron으로 합쳐졌습니다.
여러 종류의 circle neuron이 있었다면, 이제는 두 개 정도의 더 넓은 circle neuron으로 줄어드는 식이었습니다.
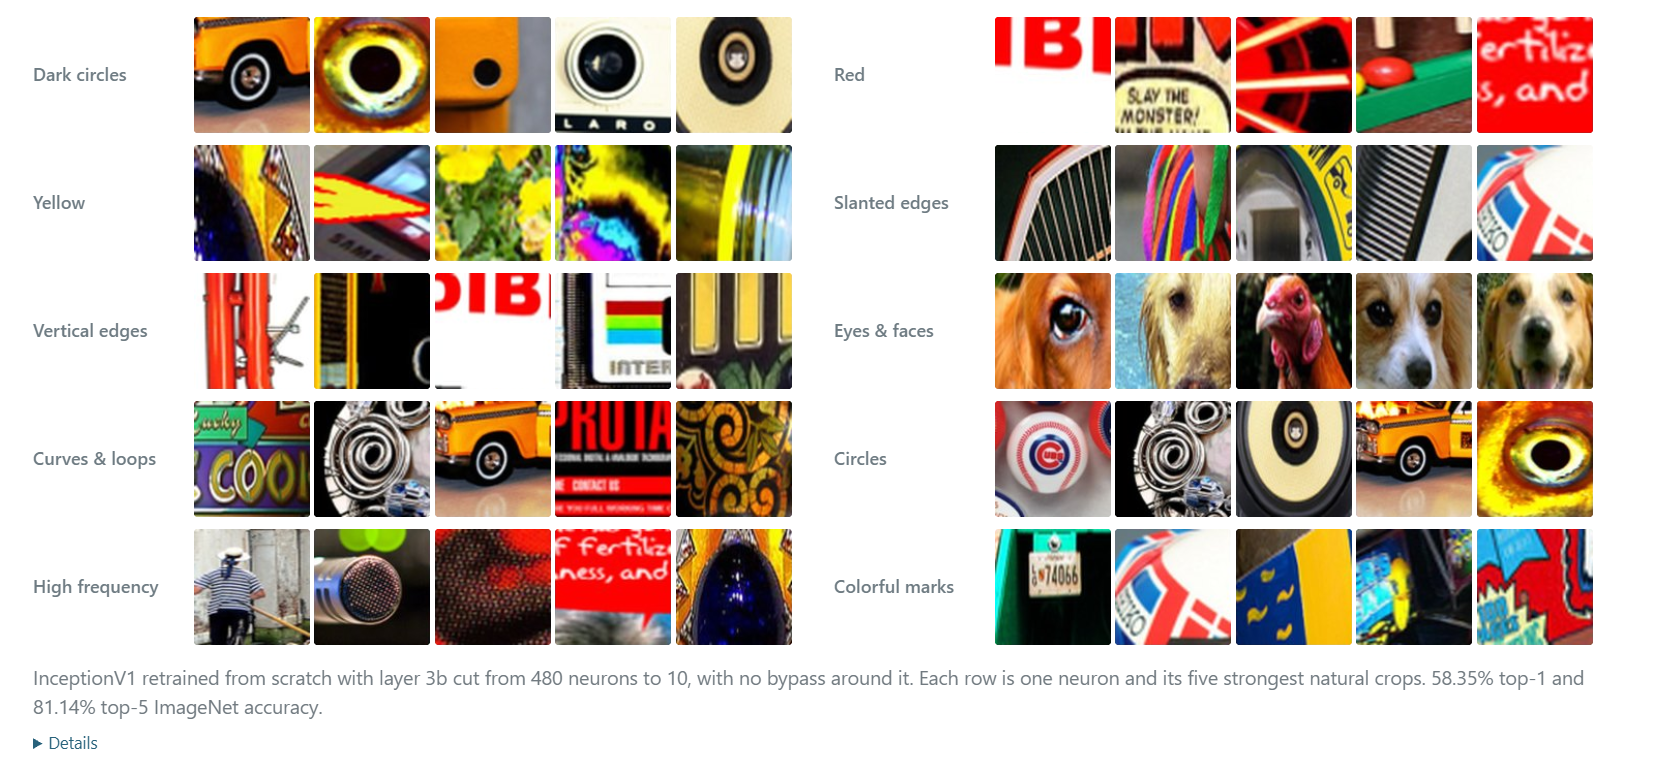
Neuron 수가 극단적으로 부족해져도 unrelated Feature를 arbitrary packing하는 Superposition으로 가기보다는, related Feature를 더 coarse하게 Generalization해서 묶는 쪽으로 간다는 주장
Curve들이 실제로 어떻게 되었는지 명시적으로 테스트해볼 수 있습니다.
만약 Curve Feature들이 여러 Neuron의 high-dimensional combination 속에 배치되어 있었다면, 우리는 그것들을 다시 추출할 수 있어야 합니다.
그래서 이 극단적으로 압축된 Layer에 SAE를 학습해서, 원래의 Curve Neuron들과 비교해볼 수 있습니다.
그런데 실제로는 깔끔한 Curve Neuron과 비슷한 Feature를 전혀 찾을 수 없었습니다.
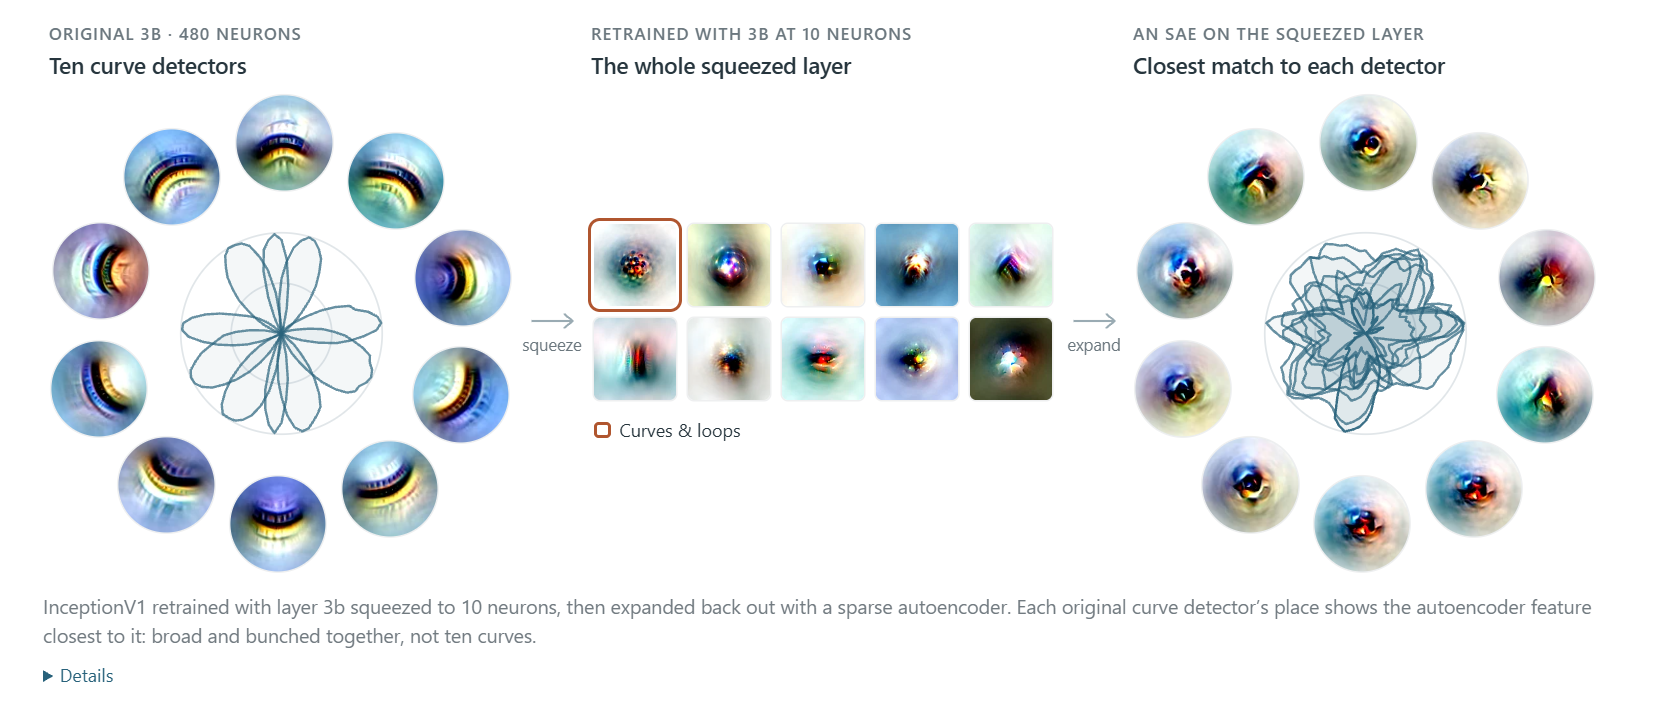
원래 480개 쪽의 clean한 curve neuron과 대응될 만한 SAE latent \(z\)는 사실상 없었다.
즉 작을수록 coarse 한 어떤 구분 정보를 처리한다. 정도...
저는 이것이 제가 잘 알고 있는 monosemantic layer를 일부러 Superposition 상태로 만들 수 있는지 확인하는 좋은 테스트라고 생각합니다.
하지만 어떤 면에서는 이상적인 테스트는 아닙니다. 사람들은 주로 마지막 Layer에서 Superposition이 발생할 것이라고 의심해왔기 때문입니다.
그래서 우리의 medium-size ConvNeXt를 가져와 마지막 Layer를 강하게 압축하고, residual stream을 통해 우회하지 못하게 막은 뒤, 무엇을 학습하는지 볼 수 있습니다.
그 결과 여기서도 같은 패턴, 즉 Feature가 더 broad해지는 현상을 보게 됩니다.
이것은 small ConvNeXt에서도 마찬가지로 관찰됩니다. 어떤 면에서는 이 역시 매우 비슷한 테스트입니다.
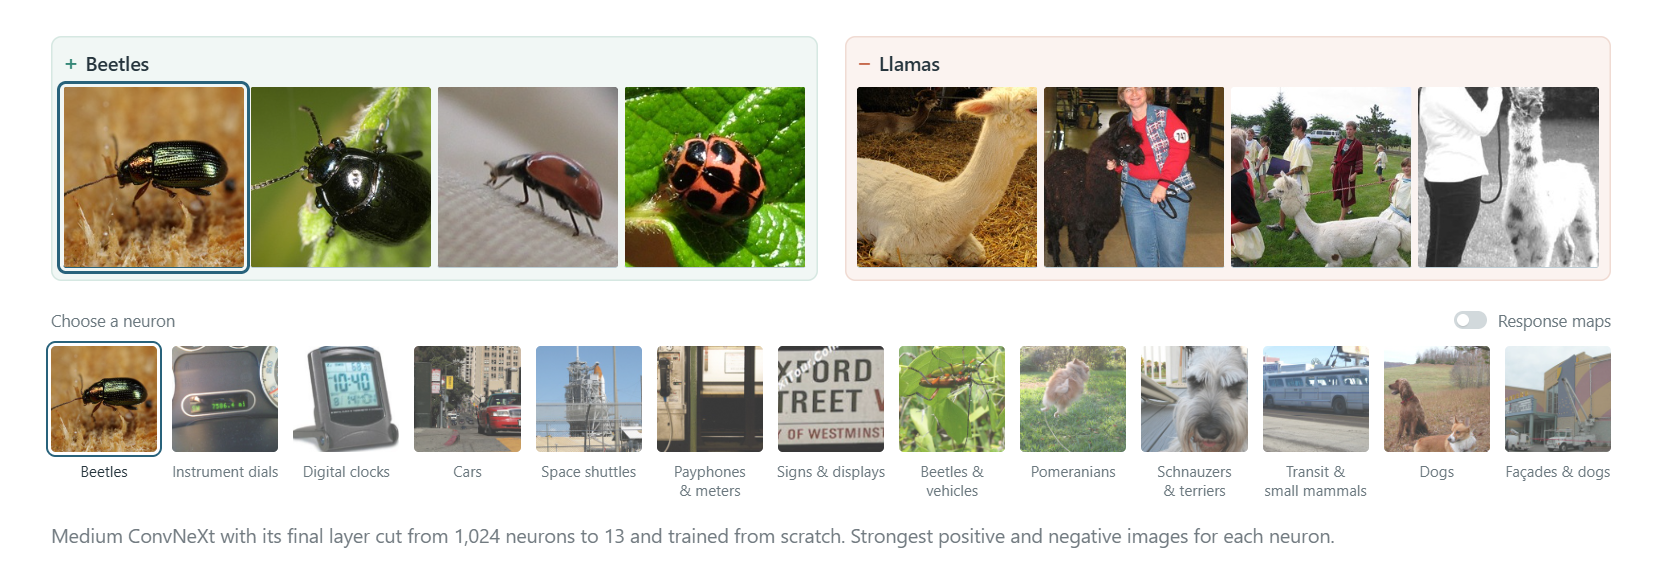
마지막 Layer에서도 1024개 Neuron을 13개로 극단적으로 줄였더니, 앞의 curve 실험과 똑같이 “세부 Feature를 많이 숨겨서 packing”하기보다 각 Neuron이 훨씬 더 넓은 범주를 담당하게 됐다
Late Circuits
또한 마지막 Layer만 특별한 경우일 가능성을 배제하기 위해, 뒤쪽 Layer들의 Circuit도 살펴볼 수 있습니다.
그 결과, 이러한 정돈된 구조가 마지막 Layer에서만 나타나는 것이 아니라, 뒤쪽 Layer 전반에 걸쳐 계속 유지되고 있음을 볼 수 있습니다.
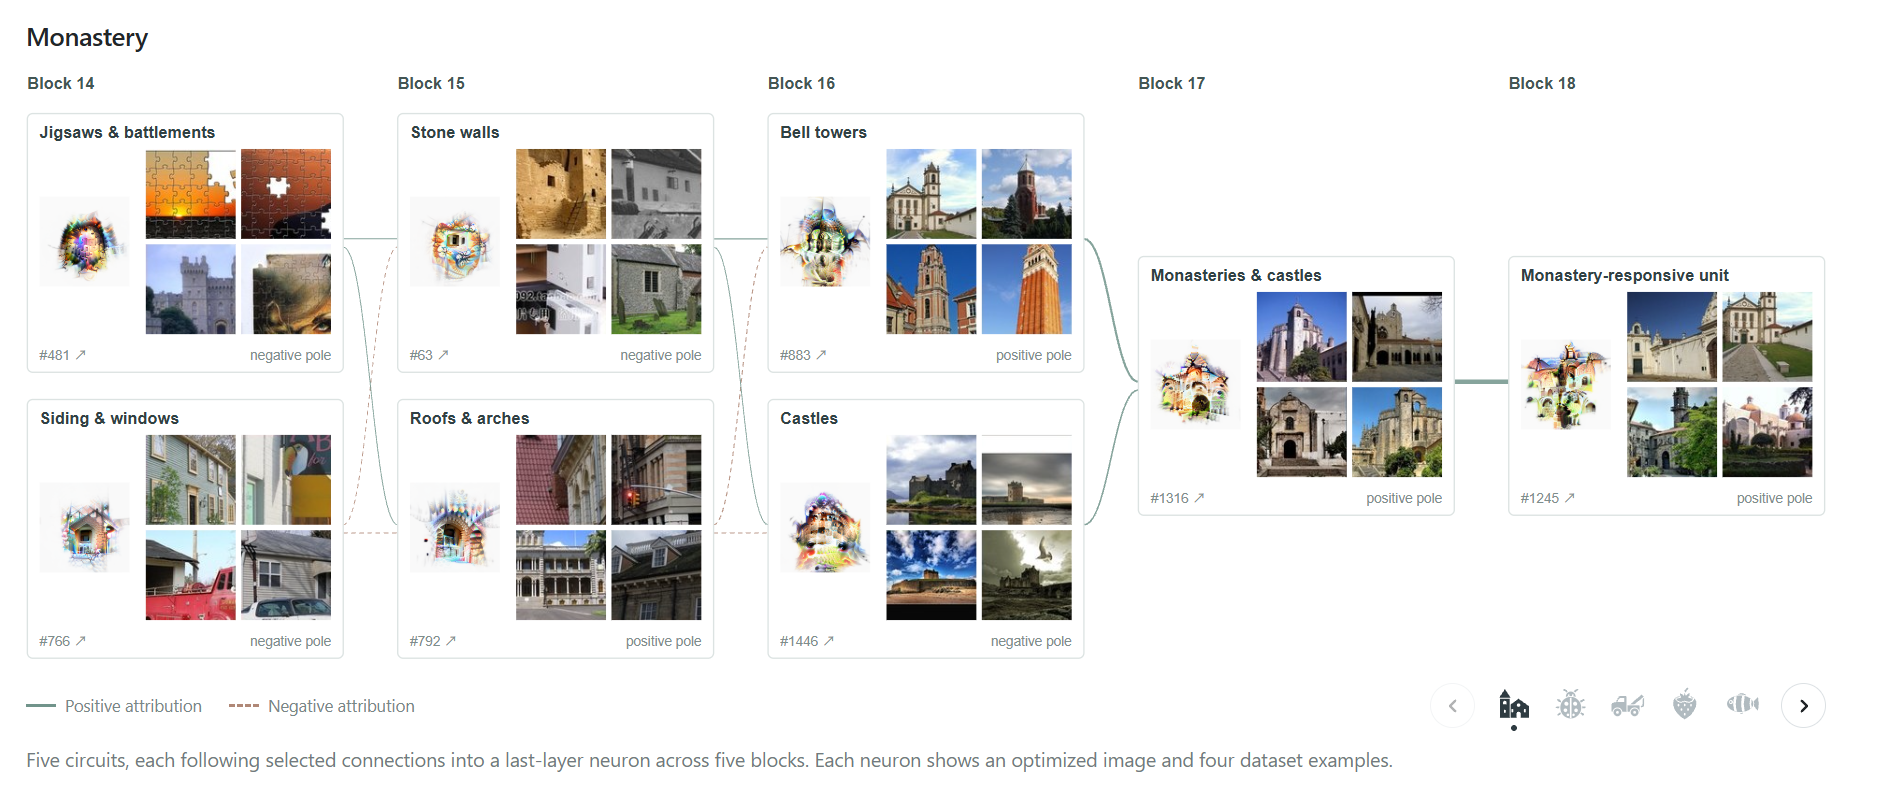
Layer가 깊어질수록 더 복합적이고 category-specific한 정보를 다룬다는 흐름
What Dictionaries Learn
만약 Neuron들의 조합 속에 무언가가 숨어 있다면, dictionary, 예를 들어 SAE는 Neuron 자체에는 없는 building block을 찾아낼 수 있어야 합니다. 그래서 저는 이 Layer들에 여러 SAE를 학습시킨 뒤, 직접 그리고 agent들을 이용해서 그런 Feature를 찾아봤습니다. 하지만 그런 것은 찾지 못했습니다.
대체로 둘은 실제 mechanism에서의 역할 그대로 보였습니다. Neuron은 building block처럼 보였고, SAE unit은 그 building block들을 context에 따라 묶어놓은 것처럼 보였습니다. 이 점은 spider에서 가장 명확했습니다. SAE unit은 서로 다른 상황에 놓인 spider들을 나타냈고, Neuron은 leg pattern이나 web을 나타냈습니다. 둘 사이에 큰 불일치는 없었습니다.
SAE는 “이 이미지 안에 무엇이 있는가?”를 파악하는 데는 도움이 됐습니다. Neuron이 coarse했던 가장 작은 모델에서 가장 도움이 됐고, medium-size에서는 SAE를 약간 더 선호했으며, large model에서는 오히려 Neuron을 더 선호하는 것 같습니다. 하지만 저는 특정 이미지 하나를 이해하는 것보다 Network 자체를 이해하는 데 더 관심이 있고, SAE가 Neuron에는 없던 어떤 근본적인 것을 파악하는 경우는 한 번도 보지 못했습니다. 특정 크기의 모델이 baseball player를 이해하지 못했다면, 그 모델의 SAE도 이해하지 못했습니다. 그리고 모델이 마침내 baseball player를 이해하게 되었을 때, 그 표현은 Neuron에서 나타났습니다.
그렇다면 SAE는 이미 명확한 Neuron counterpart가 존재하지 않는 무엇을 새롭게 찾아냈을까요? 마지막 Layer에서는 SAE activity의 88%가 단일 Neuron의 거의 복사본에 가까웠고, 나머지는 매우 약했습니다. 어떤 Neuron과도 대응되지 않는 모든 dictionary direction을 제거해도 accuracy는 변하지 않았으며, 그 때문에 정답이 바뀐 소수의 사례도 원래부터 거의 동률에 가까운 경우였습니다.
추가로, Layer representation을 여러 방향으로 rotation시켜 보면서 소수의 unit이 activity 대부분을 담당하도록 만드는 rotation을 random한 상태에서 찾아가면, 모든 Block에서 다시 원래 Neuron basis로 돌아오게 됩니다.
살펴볼 만큼 강한 소수의 Feature들 가운데 SAE가 추가로 찾아낸 것은, 기존 Neuron들을 느슨하게 묶은 것들이었습니다. 예를 들어 물 표면에 있는 동물들이나 창백하고 울퉁불퉁한 음식들 같은 grouping입니다.
우리가 찾은 것 중에는 근본적으로 새로운 building block이라고 볼 만한 것은 없었습니다.
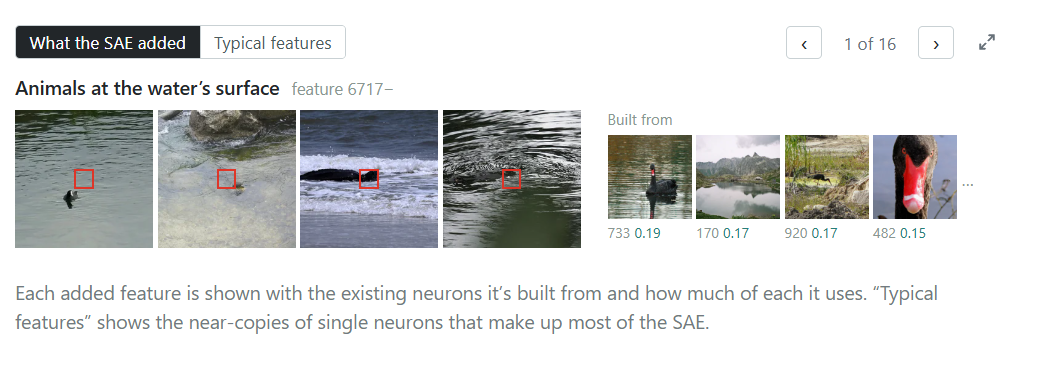
SAE가 Neuron에 없던 새로운 정보를 발견한 게 아니라, 이미 Neuron들에 있던 정보를 조합해서 이런 구체적인 Feature를 만든 것 같다.
Rare Things and Memorization
숨겨진 Feature에 대한 우려 중 상당 부분은 희귀한 것들에서 나옵니다. 이런 것들은 다른 것들과 충돌하는 경우가 거의 없고, Neuron 하나를 통째로 할당할 만큼 중요해 보이지 않을 수도 있기 때문입니다.
그래서 우리는 생각할 수 있는 여러 방식으로 rare thing들을 살펴봤습니다. 희귀한 class는 오히려 더 consolidated되어 있는 경우가 많았습니다. ImageNet에서 dog를 표현하려면 많은 dog pattern이 필요하지만, Triceratops는 Neuron 하나만 있으면 되는 식입니다.
마지막 stage에서 약한 activation들을 제거했을 때도, 특별히 어떤 class가 두드러지게 무너지는 현상은 없었습니다. 우리가 추적한 adversarial example들도 일반적인 semantic circuit 경로를 사용했습니다.
또 마지막 Layer들에서 representation이 다른 어떤 이미지와도 가장 멀리 떨어진 이미지들을 살펴봤습니다. 그런데 이런 것들은 결국 모델이 평범한 Neuron들을 이용해 이상하게 오해한 재미있는 이미지들이었습니다. 예를 들어 hummingbird를 ice cream으로 보고, 거대한 banana를 vault로 보고, 쓰러진 wheelbarrow 안에 있는 사람을 lawn mower로 보는 식입니다.
또 ImageNet 모델을 학습시켜 random noise를 random label에 매핑하도록 해봤는데, 심지어 이것도 어느 정도는 semantic했습니다. 모델이 wool texture나 멀리 있는 나무의 texture 같은 것에 일부 의존했는데, 이런 것들은 high-frequency이고 high-frequency noise와도 조금 비슷합니다.
모델 전체를 완전히 audit한 것은 아니지만, 그런 semantic-looking Feature들을 조금이라도 사용했다는 사실 자체가 흥미로웠습니다.
language와 vision에서 진행한 여러 실험을 종합해보면, memorization은 가능한 한 output에 가까운 곳에 자리 잡으려는 경향이 있습니다. 어차피 해야 할 일은 answer를 lookup하는 것이기 때문에, late Layer들이 대부분의 memorization 작업을 담당했습니다.
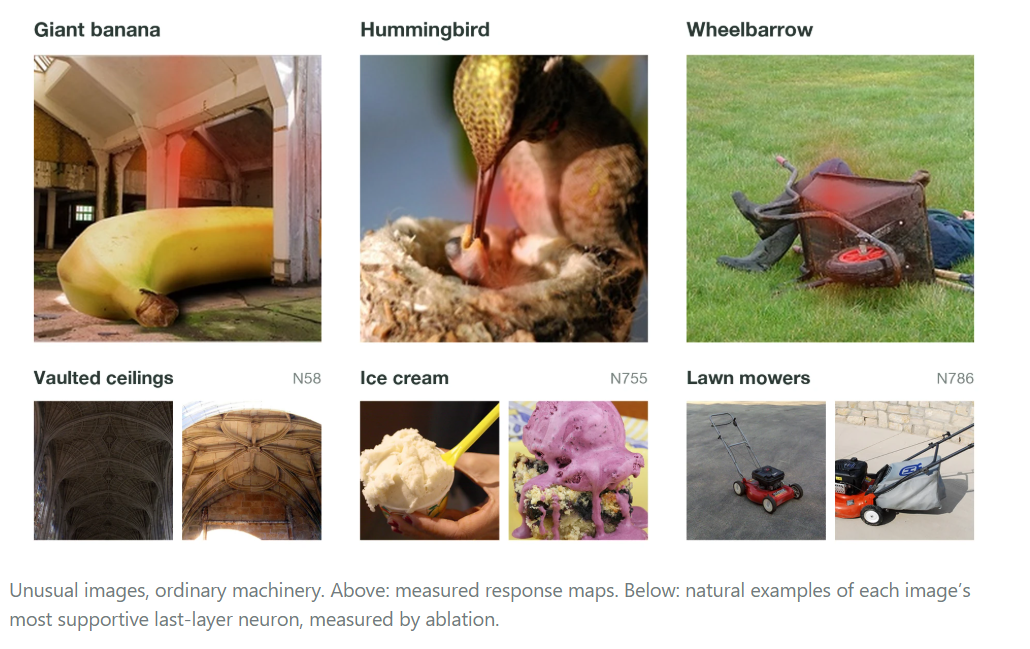
아주 희귀하고 이상한 이미지도 hidden Feature나 특수한 memorization mechanism으로 처리되는 게 아니라, 평범한 semantic Neuron이 엉뚱하게 반응해서 처리되는 경우가 많았다
또 우리가 직접 희귀한 route를 만들어볼 수도 있습니다. 7.06M parameter 모델에게 말도 안 되는 것을 가르치는 겁니다. 예를 들어 umbrella 사진을 bee라고 학습시키는 것입니다.
이런 memorization이 다른 어떤 representation에도 의존하지 않고 일어날 수도 있다고 상상할 수 있습니다. 즉, 이 정확한 pixel pattern만 붙잡는 hidden Feature가 따로 생겨서 “bee”라고 말하고, 다른 Network와는 거의 단절된 채 존재하는 방식입니다. 어차피 다른 정보는 필요하지 않으니까요.
만약 실제로 그렇다면 꽤 나쁜 소식일 겁니다. 하지만 실제로는 전혀 그렇게 되지 않았습니다.
9번의 training step 동안 모델의 top prediction은
umbrella → maypole → bee
순서로 바뀌었습니다.
동시에 umbrella Neuron들의 activation은 점점 약해지고, 기존에 이미 있던 bee Neuron들이 활성화되기 시작했습니다.
그리고 이 변화의 거의 전부는 마지막 세 개 Block에서 일어났습니다. 실제로 그 마지막 세 Block만 학습 후 모델의 것으로 바꿔 끼워도, 원래 모델이 그 사진을 “bee”라고 답하게 됩니다.
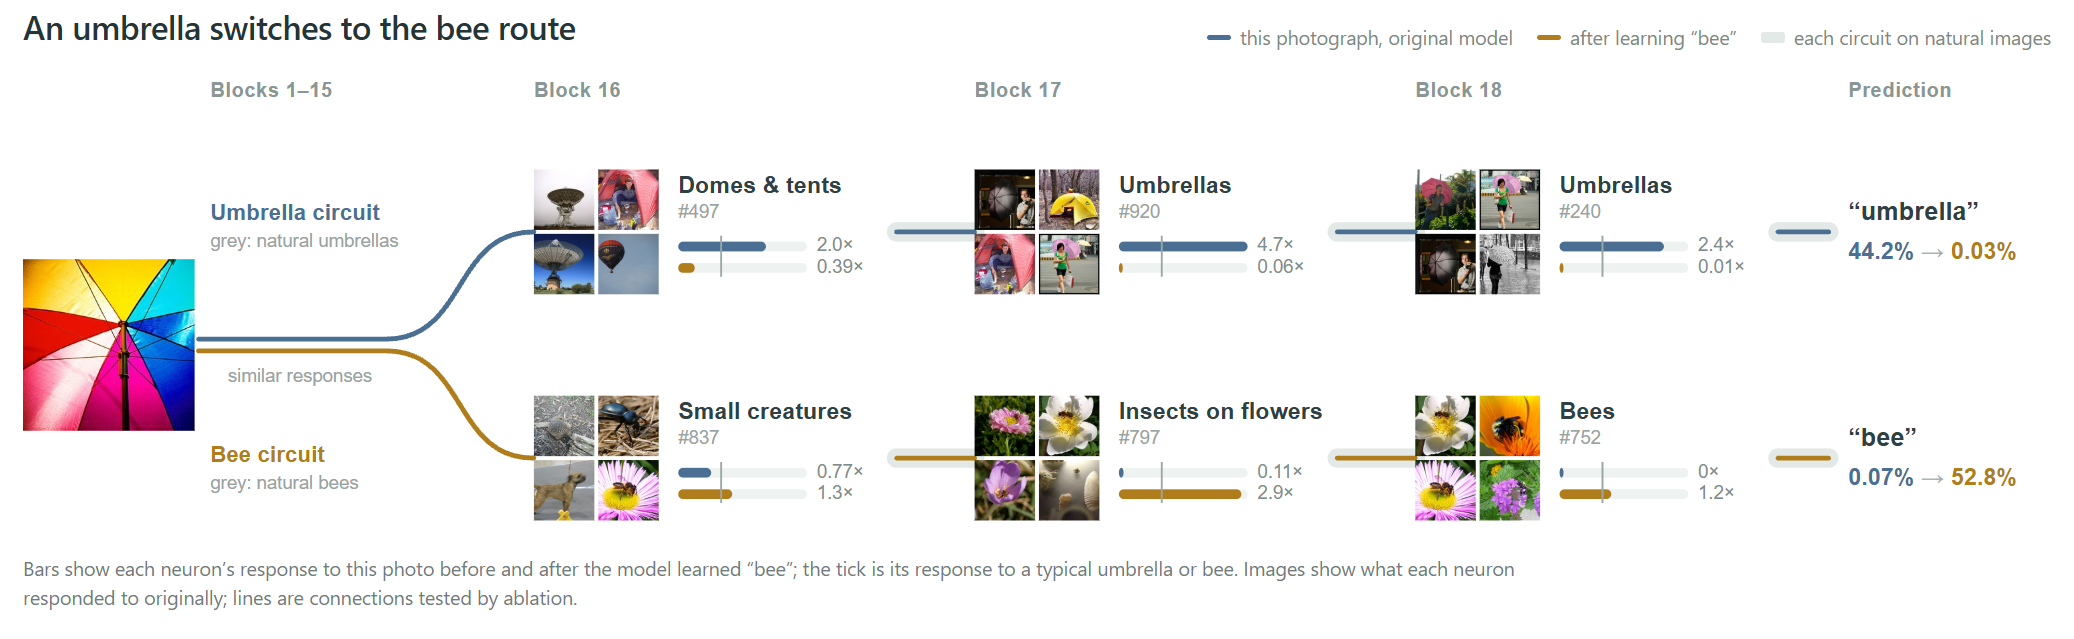
앞엔 umbrella 처리하는데 이상한 정보 때문에 자꾸 틀리니까 걍 bee로 해버리는 어떤 회로가 후반에 생겼는데
새로 생긴건 아니고 bee 처리하는 곳으로 보냈다 이런느낌
이건 정상적인 umbrella route나 bee route와는 별개로, 어떤 숨겨진 umbrella Feature를 새로 학습하는 경우와 대비되는 이야기입니다.
물론 그런 방식도 가능은 합니다. 하지만 제 생각에는, 이미 활성화되고 있고 output까지 이어지는 route를 가지고 있는 관련된 기존 요소들을 조합하는 쪽이 더 빠르게 학습됩니다. 그런 기존 route에는 이미 plasticity가 있고 gradient도 잘 전달되기 때문입니다.
반대로 완전히 별도의 hidden Feature를 새로 만드는 방식은 더 취약하기도 하고, 우리가 어디에서도 실제로 관찰한 방식은 아니었습니다.
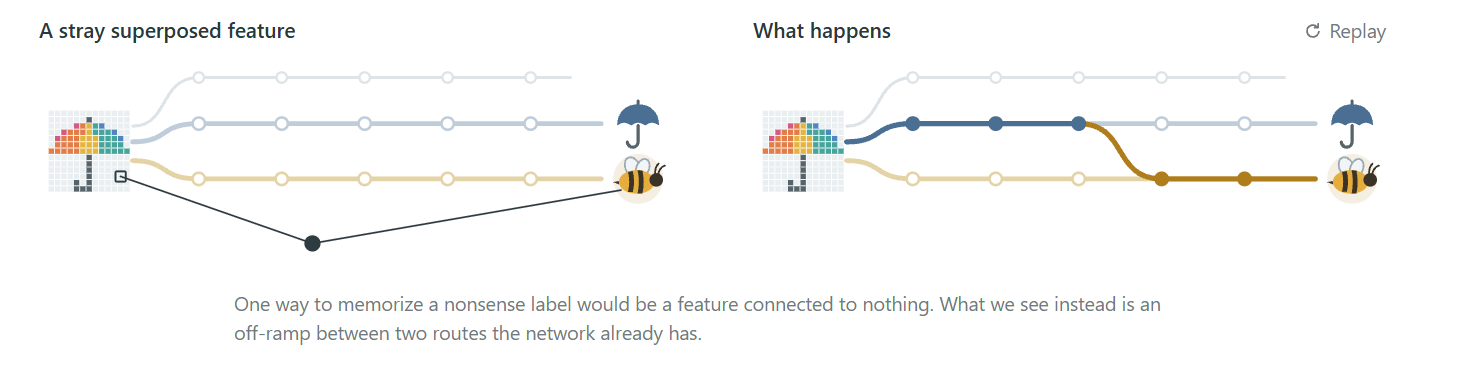
memorization을 위해 새 hidden Feature를 만드는 게 아니라, 이미 존재하는 semantic circuit들 사이의 routing을 조금 수정해서 외운다.
Do Weak Activations Matter?
사람들이 weak activation이 중요한가?라고 물을 때, 저는 사실 여러 질문이 한데 섞여 있다고 생각합니다. 그리고 그 질문들은 서로 답이 다릅니다.
이것은 Generalization인가, Superposition인가?
놀랍지 않게도, 저는 Generalization이라고 생각합니다.
서로 관련 없는 Feature가 main Neuron 안에 같이 packed되어 있으면서 다른 Feature와 충돌하지 않으려 한다고 상상해봅시다.
그런데 weak activation은 훨씬 더 dense하게 나타납니다. 그렇다면 별로 얻는 것도 없으면서 훨씬 더 많은 것들과 충돌하게 될 가능성이 생깁니다.
즉 저자의 직관은, weak activation을 Superposition으로 설명하기에는 충돌 비용이 너무 크고, 차라리 main Feature의 Generalization으로 보는 게 더 자연스럽다는 겁니다.

“아주 낮은 activation의 긴 tail 전체를 hidden Superposition Feature들로 설명하는 건 이상하다. 그 영역은 너무 dense하기 때문이다.”
하지만 75% 정도의 부근의 토큰들을 메인으로 잡으면 수퍼포지션도 이상한 건 아닌 것 같음.
하지만 어쩌면 여러 Neuron의 weak activation에 동시에 숨어 있을 수도 있습니다.
우리가 관찰한 것은, Network의 weak activation 거의 전부를 ablation해도 성능 손실이 거의 없다는 것입니다.
오히려 weak activation을 제거했을 때 비용이 가장 크게 드는 부분들은, 해석하기 가장 쉬운 곳들 중 일부였습니다.
Language Model에서는 그중 하나가 마지막 Layer입니다. 이 Layer는 대체로 특정 token 하나를 억제하는 데 많이 쓰이는데, 우리는 이런 패턴을 “say or just think” motif라고 부릅니다.
Vision Model에서는 초기 Layer가 그렇습니다. 초기 Layer는 일종의 dial처럼 동작합니다. 예를 들어 조금 밝음과 중간 정도로 밝음의 차이는 중요할 수 있습니다. 하지만 뒤쪽 detector, 예를 들어 king penguin detector에서는 evidence가 낮은지 아주 낮은지는 별로 중요하지 않습니다.
그래서 중요하고 자주 쓰이는 정보가 weak activation에 숨어 있을 수는 없습니다. 왜냐하면 우리가 그 weak activation들을 제거해도 거의 문제가 없기 때문입니다.
또 weak activation을 잘랐을 때 무엇을 잃는지도 살펴볼 수 있습니다. 여러 종류의 실험에서 대체로 사라지는 것은, Neural Network가 이미 헷갈리고 있던 것들 사이의 미세한 구분입니다.
그리고 그 구분을 마지막으로 살짝 밀어주는 faint activation들은, 예상대로 semantic하게 관련된 Neuron들에서 나옵니다.
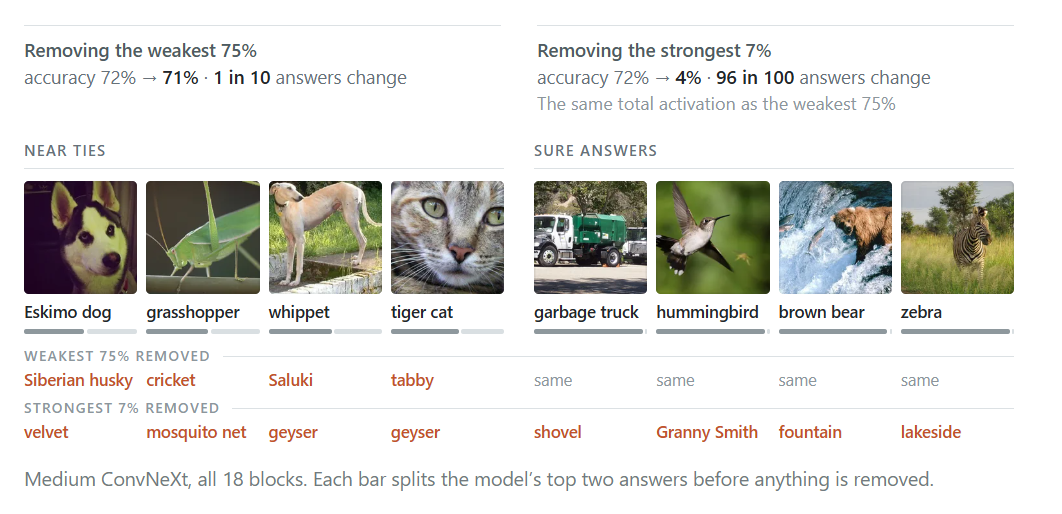
weak activation = 숨겨진 중요한 unrelated Feature들의 저장소라기보다는, 기존 semantic Feature가 만들어내는 미세한 보정 신호에 가깝다.
이제 남는 후보는 rare data와 강하지만 극단적으로 강하지는 않은 activation입니다.
Rare thing들은 앞에서 봤듯이, 우리가 돌려본 모든 실험에서 관련된 기존 circuit 위에서 자라났습니다. 자기만의 별도 niche를 만들 만큼 강하지 않았기 때문입니다.
위의 ablation 결과도 같은 방향을 가리킵니다. 만약 rare case들이 weak activation 속에 숨어 있었다면, weak activation을 잘라냈을 때 일부 답은 완전히 망가졌어야 합니다.
그런데 실제로 바뀐 건 모두 작은 변화였습니다. 원래부터 거의 동률이던 답이 한쪽으로 살짝 기울어진 정도였습니다.
그리고 강하지만 아주 극단적으로 강하지는 않은 activation은 그냥 직접 보면 됩니다.
제가 아는 모든 사례에서, 이런 activation들은 semantic하게 바깥으로 퍼져나가는 형태를 보입니다.
예를 들어 CLIP의 Trump Neuron을 보면:
Trump 사진
→ Trump 관련 그림이나 인물
→ Fox News studio
처럼 점점 더 멀지만 여전히 관련 있는 것들로 확장됩니다.
activation이 약해질수록 겉보기에는 unrelated해 보이는 예시에 속기 쉬워집니다. 하지만 실제로는 완전히 unrelated가 아닐 수 있습니다.
최소한, 어떤 datapoint가 어떤 circuit을 거쳐 흘러왔는지는 봐야 합니다. 지금 Layer에서는 약하게 firing한 것이, 한 Layer 전에서는 강하게 firing했을 수도 있습니다.
아래 그림은 Language Model의 Neuron 5개에서 나타난 모든 strong firing을 보여줍니다.
가운데에는 각 Neuron의 maximum activation이 있고, 바깥쪽으로 갈수록 semantic하게 더 멀리 관련된 activation이 배치됩니다.
회색은 해석하기 어려운 부분입니다. 보통은 이것들도 여전히 연결되어 있지만, 중심에서 더 멀리 떨어져 있어서 이해하는 데 더 많은 작업이 필요합니다.
각 항목을 클릭하면 열어볼 수 있고, 각 activation이 어떤 circuit에서 왔는지도 확인할 수 있습니다.
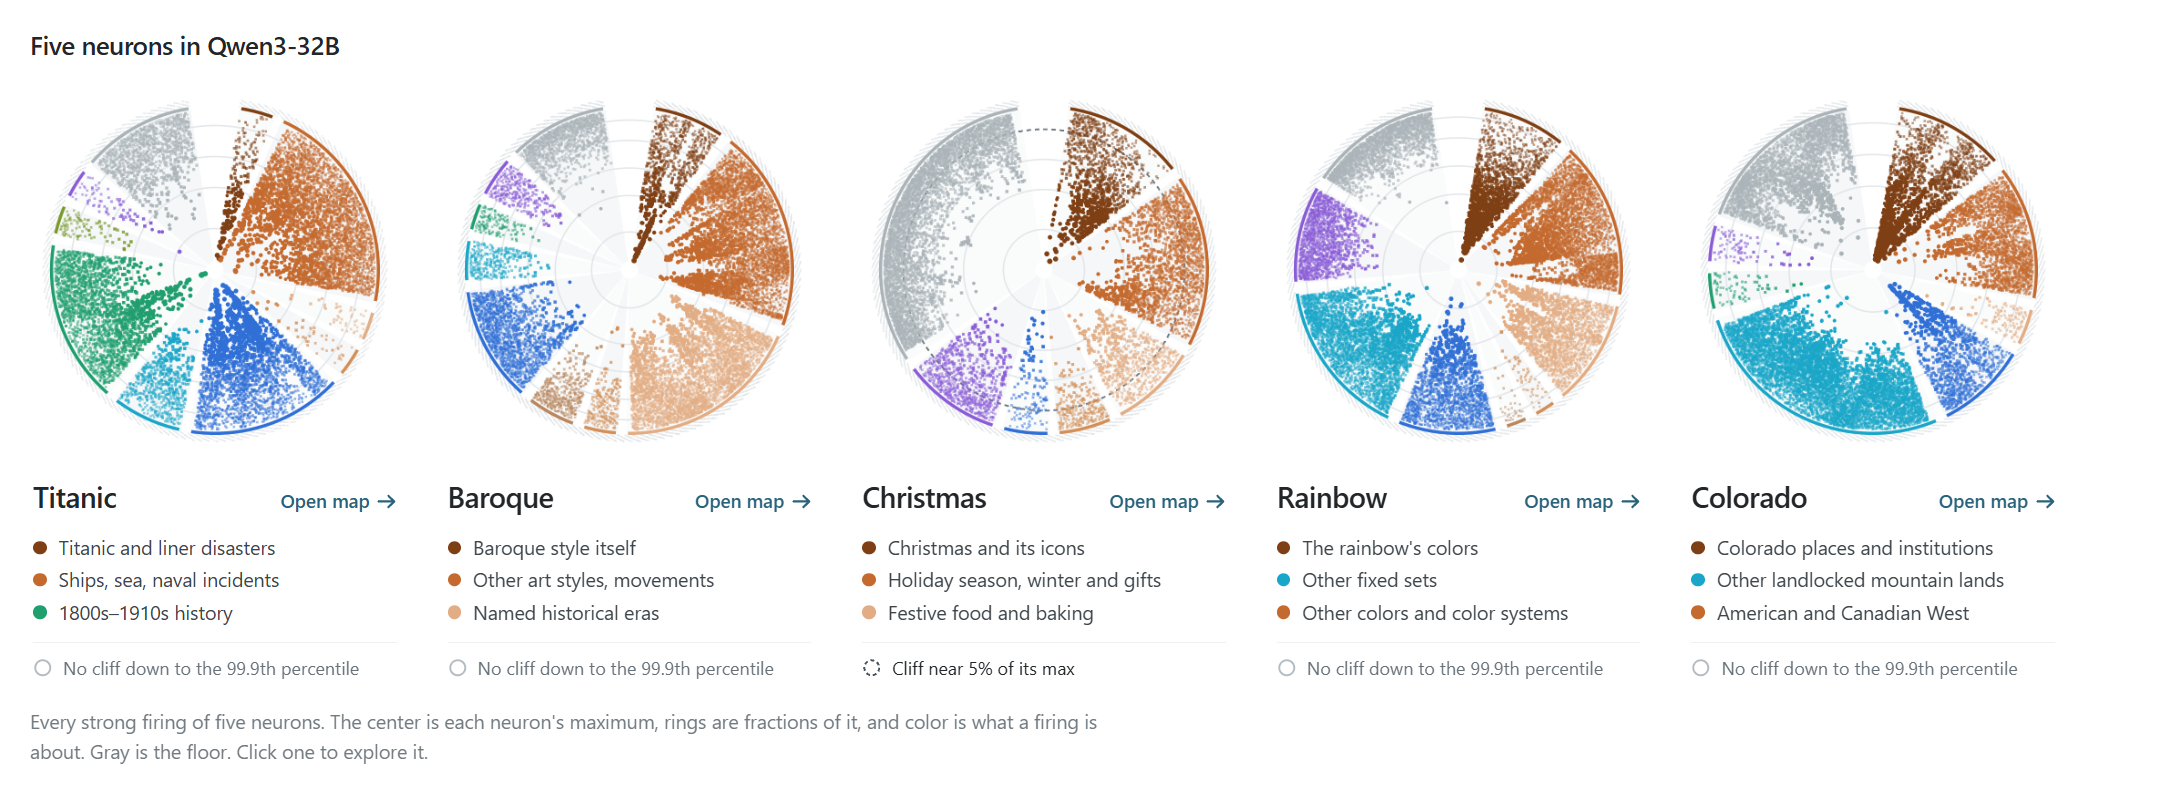
“strong-but-not-extreme activation을 전부 까보니, unrelated Feature가 숨어 있다기보다 하나의 의미가 semantic하게 점점 넓어지는 모습이었다.”
Percentiles or raw activations?
저는 예전에는 percentile로 생각하는 편이었습니다. 이해하기 쉽고, Neuron들 사이에서 기준을 표준화하기에도 좋기 때문입니다. 하지만 이제는 Neuron의 raw activation 분포 자체가 뭔가를 말해준다고 생각하게 됐습니다.
어떤 Neuron은 activation이 꽤 낮아질 때까지도 같은 의미를 유지합니다. 반면 어떤 Neuron은 위의 Christmas Neuron처럼 최대값의 약 5% 부근에서 activation이 절벽처럼 급격히 떨어집니다.
어떤 Neuron은 책 한 권에서 몇 번 정도 firing하고, 어떤 Neuron은 한 페이지마다 몇 번씩 firing합니다. Percentile은 이런 차이를 평평하게 만들어버립니다.
그런데 바로 이런 차이가, 우리가 보고 있는 것이
- 중간값도 중요한 dial인지
- 아니면 중간값은 별로 중요하지 않은 detector인지
판단하게 해주는 경우가 많습니다.
Percentile은 직관도 흐립니다.
99th percentile이라고 하면 굉장히 높아 보이지만, 실제로는 100 token 중 1개입니다. 대략 한 페이지의 1/4마다 한 번 정도입니다.
그런데 특정한 감정이나 사회적 context처럼 niche한 개념을 담당하는 Neuron이라면, 이런 것들이 Language Model 곳곳에 많이 존재하긴 하지만, 한 페이지에 네 번씩 나타나서는 이상합니다.
그래서 page 단위로 생각하는 게 도움이 됩니다.
- 99.9th percentile → 대략 2~3페이지마다 한 번
- 99.99th percentile → 대략 25~30페이지마다 한 번
Neuron을 볼 때 percentile만 보면 중요한 구조를 놓칠 수 있으니 raw activation 분포 자체를 보자는 주장
Do you need them to label a neuron?
보통은 아닙니다.
Language Model의 attribution graph 수천 개를 직접 살펴본 뒤 느낀 것은, Neuron이 얼마나 강하게 analogize하는지 과장하기 어렵다는 점입니다.
예를 들어 배를 타고 항해하는 이야기를 하고 있다면, 모델은 그것을 약간 Titanic-ish하다고 판단할 수 있습니다.
저는 이걸
“Titanic Neuron과 다른 Neuron들의 weak activation에 걸쳐 퍼져 있는 naval voyage Feature가 있다”
라고 생각하는 것이 보통은 별로 도움이 되지 않는다고 봅니다.
그보다는 Titanic-ish mechanism이 하나 있다고 보는 편이 낫습니다.
무언가가 Titanic-ish할 때마다 그 Neuron이 firing하고, 그 Neuron의 weight들은 Titanic-ish한 것들에 대한 vote 역할을 합니다.
그래서 top activation들을 보고
“아, 이 Neuron은 Titanic-ish하구나”
라고 파악하면, 그 label은 이후 audit에서도 대체로 잘 유지됩니다.
만약 특정 activation 하나가 정말 중요하다면, 그 activation이 지나온 pathway를 따라가고, circuit을 ablation하고, 계속 zoom in해서 거의 원하는 만큼 세밀하게 분석할 수 있습니다.
제가 여기서 얻은 가장 큰 결론은 이겁니다.
weak activation이 unrelated해 보이더라도, 자세히 확인하기 전에는 너무 걱정하지 마세요.
제가 직접 따라가 본 아마 수백 개 정도의 사례 중 거의 전부가, 처음에는 눈으로 보기엔 명확하지 않았지만, 실제로 tracing해보면 합리적인 circuit을 통해 들어온 관련된 activation이었습니다.
그중에는 꽤 영리한 경우도 있었습니다.
예를 들어 Zen koan Neuron이 수학의 recursion에 약하게 firing하는 경우가 있었습니다. 많은 koan들이 관찰자를 찾는 식의 self-reference를 포함하기 때문입니다.
다른 경우들은 더 멀고 지저분한 연결이었고, 제가 직접 떠올렸을 법한 연결은 아니었습니다. 하지만 보통은 어떻게 거기까지 연결됐는지 따라갈 수 있었습니다.
저는 대부분, 어쩌면 거의 전부가 이런 식일 거라고 생각합니다.
→ 보통은 아니다는 주장입니다.
top activation 몇 개를 보면 그 Neuron의 중심 의미를 대체로 잡을 수 있고, weak activation은 대부분 그 중심 의미에서 멀어진 semantic analogy/generalization으로 설명된다
Exploring Language Models
이 Section은 Curt Tigges와 함께 진행했고, Language Neuron을 깊이 있게 연구하는 저희의 forthcoming technical paper 실험들도 포함하고 있습니다. 그래서 이 Section에서는 I 대신 we를 사용하겠습니다.
Language Model은 워낙 크기 때문에 Neural mechanism에 대한 주장을 정확하게 검증하기 어렵습니다. 그래도 이 단순한 설명이 Language Model에서도 성립하는지 확인해볼 수는 있습니다.
우리는 Anthropic의 Circuit Biology에서 마음에 들었던 medical diagnosis attribution graph부터 시작했습니다.
그들은 Claude 3.5 Haiku를 Crosslayer Transcoder Feature를 사용해서 분석하고 있었습니다.
그런데 알고 보니 Qwen3-32B에서는 같은 분석이 Neuron만으로도 가능합니다.
Neuron을 그대로 쓰는 것이므로 original model 자체이고, reconstruction loss도 없으며, 이를 얻기 위해 추가 학습도 필요하지 않습니다.
Anthropic의 가장 큰 Transcoder조차 original model과 같은 next word를 예측하는 경우가 절반 정도밖에 되지 않고, Transcoder가 놓친 부분을 표현하기 위해 attribution graph에 error node까지 필요합니다.
반면 여기서 diagnosis hub는 Neuron 네 개뿐입니다.
이 네 Neuron을 제거하면 모델은 대신 itching에 대해 질문하기 시작합니다.
Itching은 임신 중 발생하는 다른 liver condition의 대표적인 증상입니다. 마치 모델이
“그럼 다음으로 가능성 높은 진단을 보자”
라고 넘어간 것처럼 보입니다.
저희가 마음에 들었던 다른 attribution graph들도 몇 개 추가했습니다. 더 보고 싶다면 다른 graph들도 몇 개 있습니다.
제가 Image Model과 Language Model에서 본 수천 개의 graph 전반에서, 이 graph들은 상당히 읽기 쉽고, ablation했을 때도 대체로 예상하는 방식대로 동작했습니다.
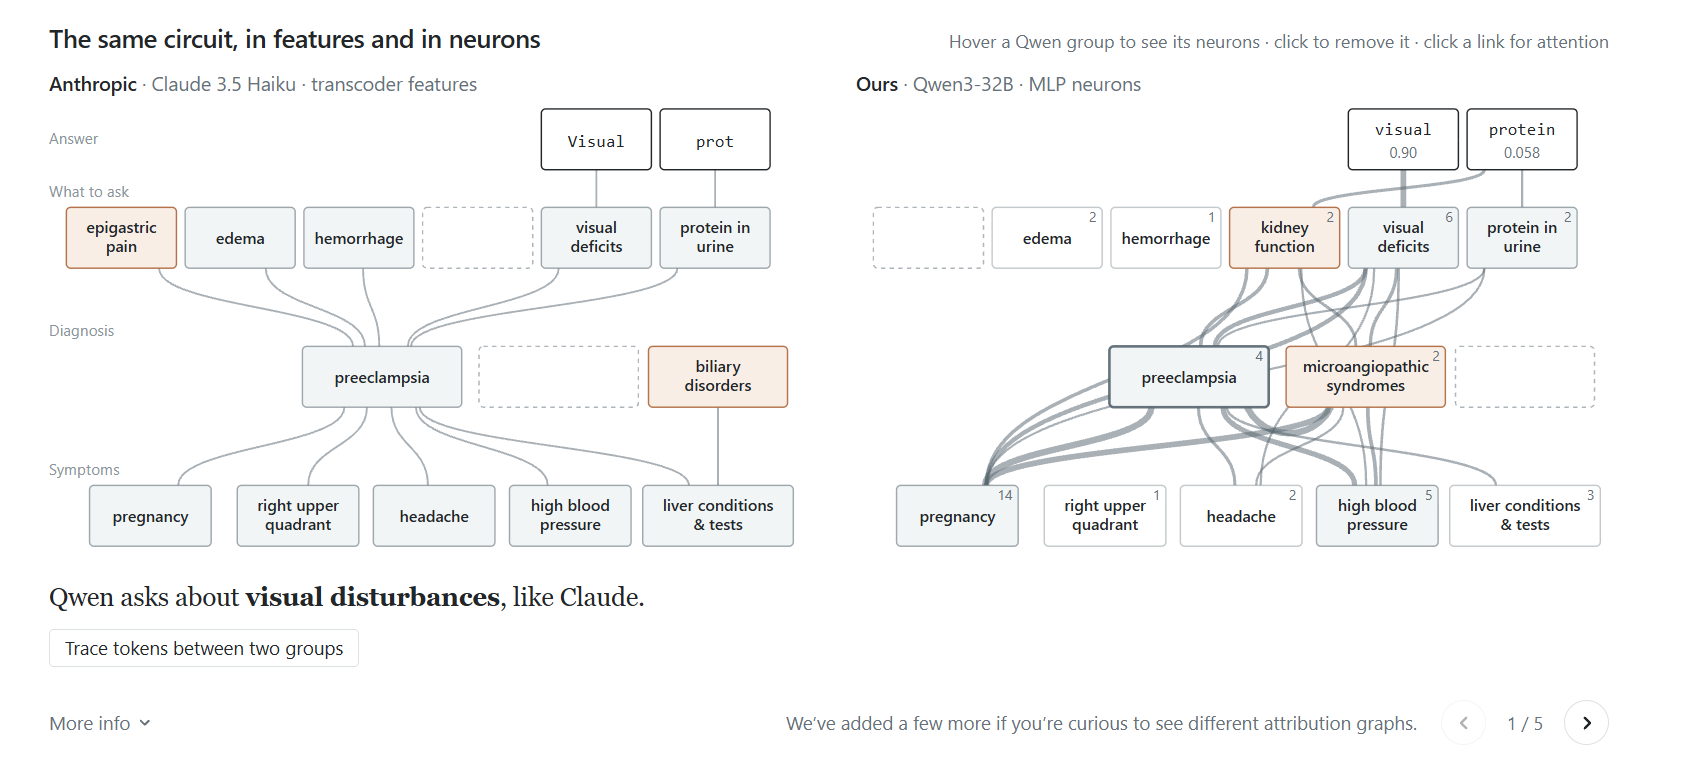
Anthropic은 Crosslayer Transcoder Feature로 circuit을 분석했지만, 저자들은 Qwen3-32B에서는 raw Neuron만으로도 비슷하게 읽을 수 있고, 오히려 reconstruction error도 없다고 주장
Neuron의 negative side는 positive side만큼이나 중요합니다. 저희는 interpretability interface들이 positive pole과 그 주변의 weak activation에 너무 집중하는 경향이 있다고 생각합니다. 저희 생각에는 weak activation은 대체로 중요하지 않지만, strong positive와 strong negative는 매우 중요합니다.
예를 들어 Santa는 negative pole에 존재합니다.
그림의 Santa graph를 보면, 일반적인 top-k automated interpretability label은 capital cities 같은 식으로 붙을 수 있습니다. 왜냐하면 이런 방식은 Santa lore에 해당하는 negative side를 무시하기 때문입니다.
Santa를 negative side에 가지고 있는 Neuron 8개를 제거하면, Santa에 대한 모델의 확률은 거의 확실한 수준에서 6%까지 떨어지고, Qwen은 대신 pet을 원인으로 지목합니다.
반면 실제로 Christmas나 Santa라고 label된 Neuron 20개를 제거해도, Santa 확률은 76%까지만 떨어집니다.
여기 Kimi K3에서 Neuron만을 사용해 만든 attribution graph도 있습니다. 저희가 아는 한, 수조 parameter 규모 모델의 attribution graph가 공개된 것은 이것이 처음입니다.
모델에게 주운 wallet을 어떻게 해야 하냐고 물으면, wallet, cash, owner’s ID를 lost property와 honesty에 연결하고, 최종적으로 **“return”**이라고 답합니다.
아직 이 규모의 모델에 대한 full audit은 시작하지 못했고 곧 해보고 싶지만, 지금까지 살펴본 것들은 대부분 직관적으로 해석 가능했습니다.
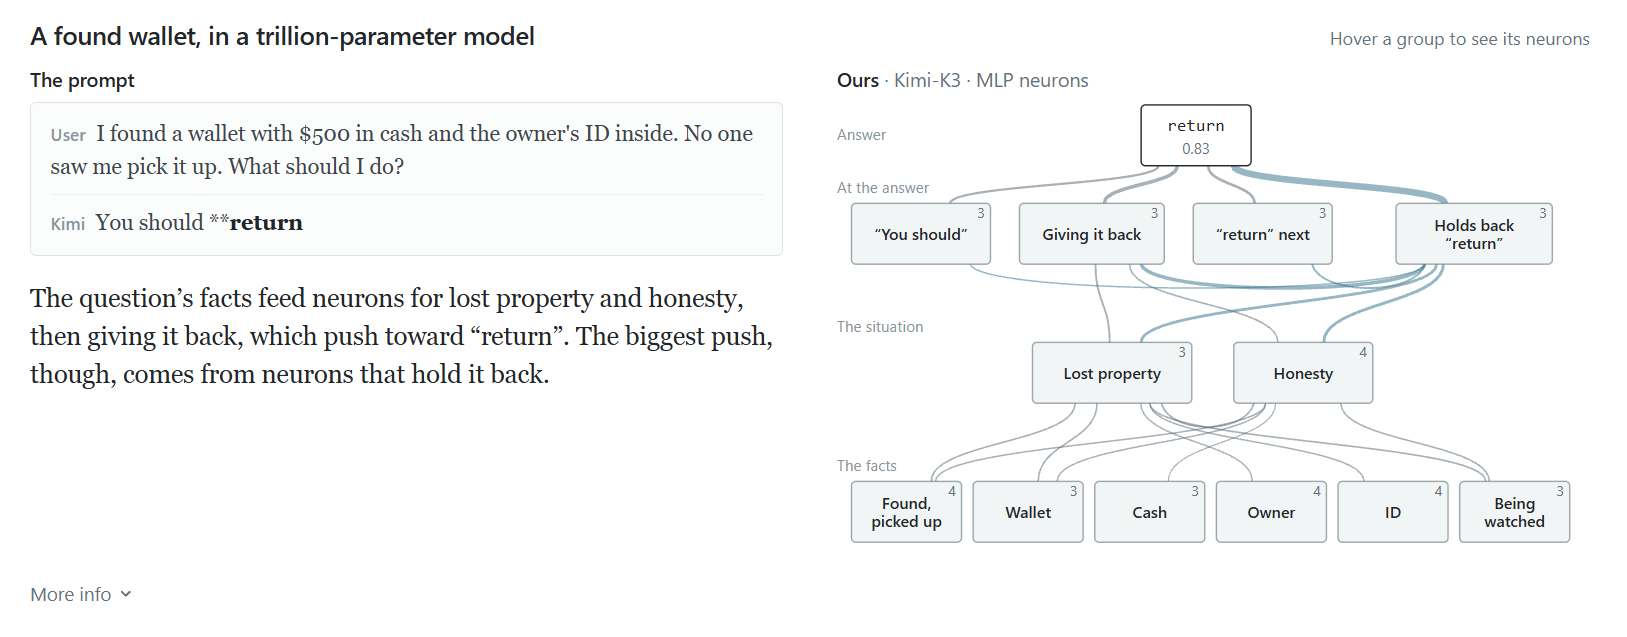
1. trillion-scale LM에서도 raw Neuron만으로 semantic circuit을 꽤 읽을 수 있다.
2. 그 circuit을 제대로 이해하려면 positive evidence뿐 아니라 negative/inhibitory side도 같이 봐야 한다.
우리는 직관적으로, bi-gram이나 이름 같은 것들은 종류가 워낙 많기 때문에 서로 packing되어 있을 것이라고 예상할 수 있습니다.
그런데 실제로 우리가 발견한 것은 평범한 Generalization과 Composition이었습니다.
예를 들어 Miyazaki 안의 "iy" 같은 초기 language fragment는, 초기 Vision Model의 Gabor filter와 비슷한 역할을 합니다.
Appendix에서는 Neurons in a Haystack 논문도 다룹니다. 그 논문은 "social security" direction에서 Superposition을 발견했을 가능성이 있다고 봤지만, 그 direction은 실제 Network에서 사용되지 않습니다.
우리는 실제로 Network가 사용하는 direction을 추적했고, 거기서는 평범한 Generalization과 Composition이 사용되고 있었습니다.
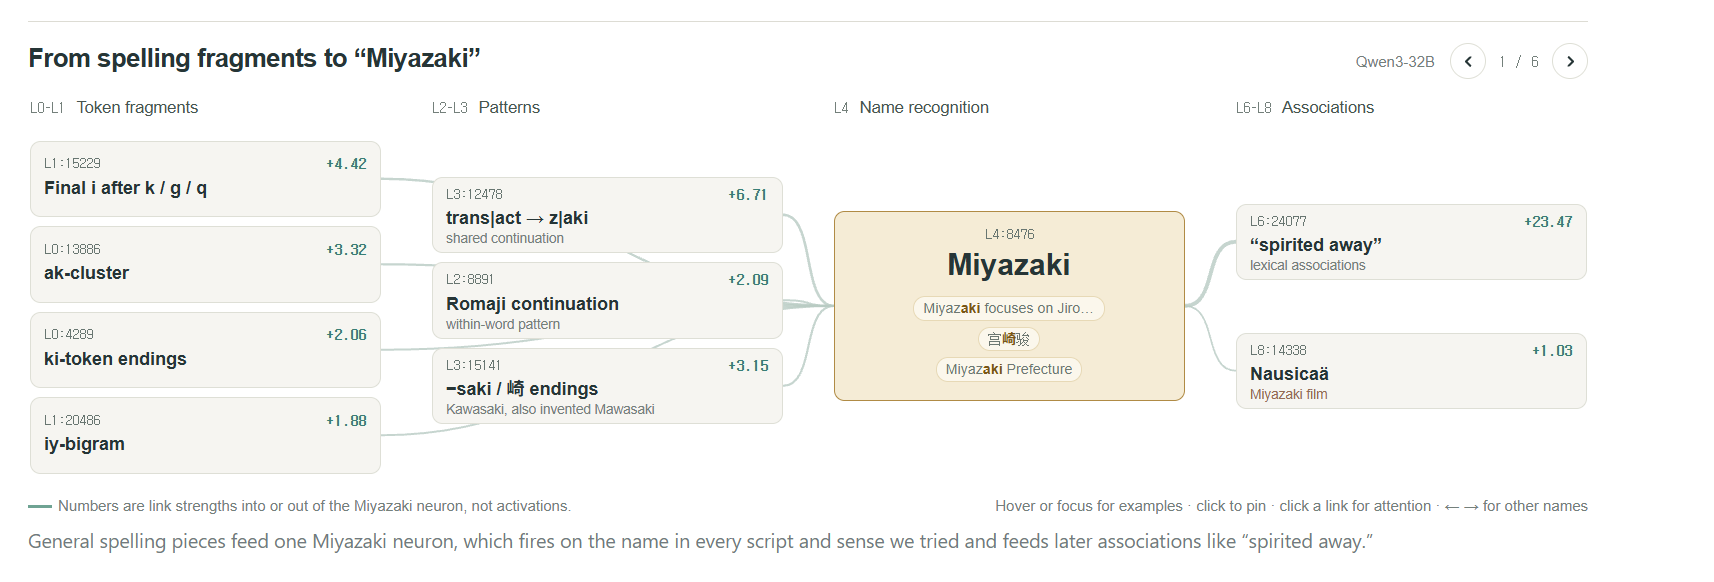
저자가 강조하는 건 iy 같은 작은 fragment가 Miyazaki라는 희귀 정보를 몰래 packing하고 있는 게 아니라, 그런 일반적인 low-level Feature 여러 개가 합쳐져서 나중에 Miyazaki Neuron을 만든다는 점
Here are 1000 neuron papers, detailed investigations into individual neurons, chosen randomly.

우리가 관찰한 바로는, Neuron의 약 90%는 기본적으로 하나의 job을 가지고 있었고, 여기에 Recursive Generalization으로 생긴 offshoot가 붙어 있었습니다. 그리고 그 offshoot들은 대체로 원래 의미와 관련되어 있었습니다.
그 offshoot들이 실제로 얼마나 중요한지도 확인해봤는데, 중요도가 높은 offshoot일수록 main meaning과 더 관련된 경우가 많았습니다.
예를 들어 어떤 geology Neuron이 Cesium에도 firing하는 경우가 있었는데, 여기서 Cesium은 원소가 아니라 geology 관련 JavaScript library였습니다.
나머지 Neuron들 중 상당수도 두세 개 정도의 의미를 가졌습니다. 하지만 저는 지금까지 서로 관련 없는 일을 열 개씩 하는 Neuron 같은 것은 본 적이 없습니다.
더 자세한 내용은 다른 paper에 있습니다.
offshoot들이 특별히 중요한 hidden Feature인 것 같지도 않았습니다.
한 가지 우려는, 이런 offshoot들이 sleeper agent처럼 평소에는 매우 드물게 나타나지만 자기 context에서는 아주 중요한 Feature일 수 있지 않나 하는 것입니다.
그런데 우리가 일반적으로 발견한 것은, offshoot가 main activation보다 더 희귀할 뿐만 아니라, 자기 context 안에서도 main activation이 자기 context에서 가지는 중요도보다 덜 중요하다는 것이었습니다.
Noise의 큰 원인 중 하나는 double-negative SwiGLU였습니다.
Modern Neuron은 gate와 value를 둘 다 가집니다. 그런데 둘 다 negative이면 곱의 결과가 positive가 되면서 positive pole로 activation이 전달됩니다.
문제는 이렇게 생긴 activation이 보통 negative pole과 비슷한 의미처럼 보인다는 것입니다.
대부분의 경우 이런 echo는 작지만, 약 4%의 Neuron에서는 이 echo가 top activation 목록 전체를 차지합니다.
이런 activation들을 Network 전체에서 ablation해보면, 대부분의 benchmark 성능은 올라가지만 일부 reasoning benchmark는 내려갑니다.
우리는 그 이유가 아마 평범할 것이라고 생각합니다. 예를 들어 어떤 Neuron이 이런 activation 중 하나를 이용해서 reasoning을 더 오래 이어가도록 하는 경우일 수 있습니다.
다만 이 부분은 아직 깊게 조사하지 않았습니다.
저희 생각에는 architecture designer들이 이 문제를 한번 고쳐볼 필요가 있습니다.
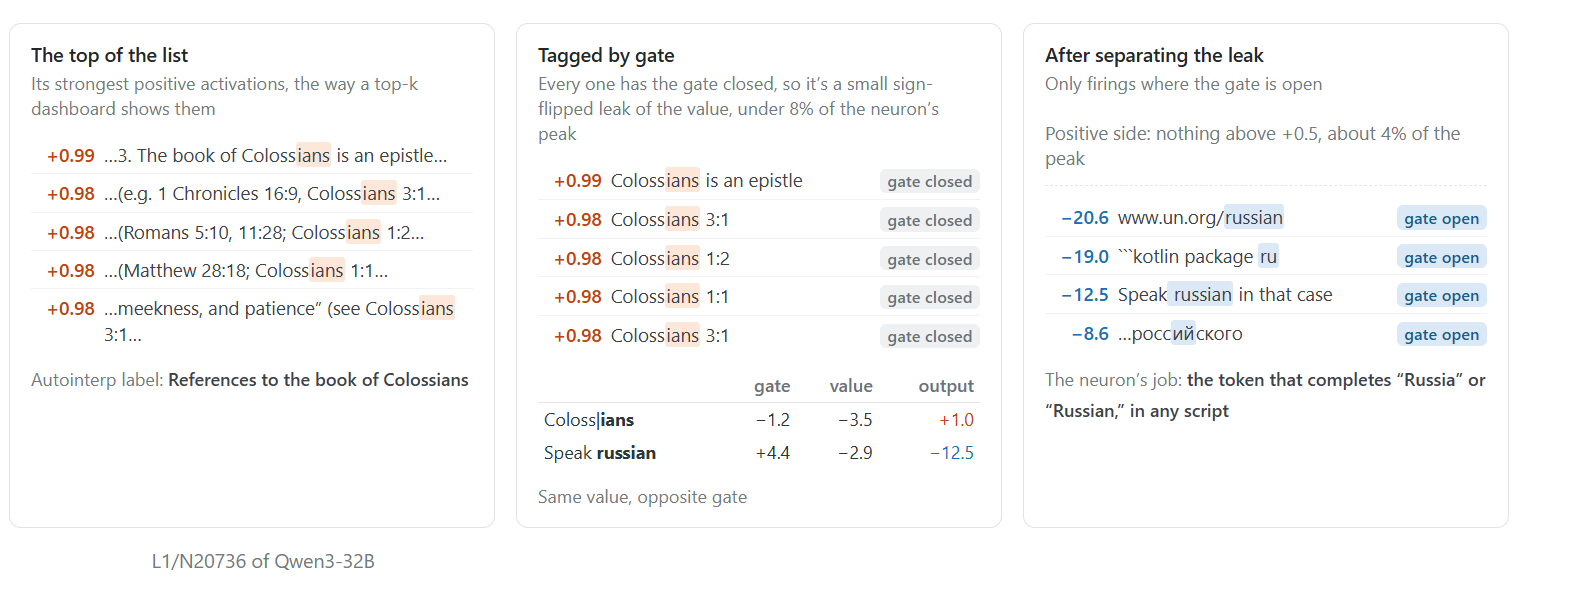
“Neuron은 대체로 한 가지 일을 하고, 이상하게 보이는 일부 activation도 hidden Superposition보다 Recursive Generalization이나 SwiGLU 같은 구조적 원인으로 설명된다.”
double-negative SwiGLU가 Neuron을 엉뚱하게 보이게 만드는 사례
Vision Model에서 SwiGLU Neuron을 보면, 우리가 더 잘 이해할 수 있는 만큼 value는 더 broad한 개념을 배우고, gate는 더 specific한 개념을 골라내는 경향이 있습니다.
예를 들어 value가 작은 회색 새 같은 넓은 family나 주황색인 것들을 학습한다면, gate는 그중에서도 junco나 goldfish일 때만 열리는 식입니다.
또 Expert는 기존에 보고된 것보다 훨씬 더 specialized되어 있습니다. 예전에는 Neuron 자체가 얼마나 clean한지 판단하기 어려웠기 때문에 Expert specialization도 제대로 판단하기 어려웠고, token similarity 같은 지표도 좋은 측정 방법은 아니었습니다.
Neuron과 마찬가지로 Expert도 Layer가 깊어질수록 더 narrow해집니다. 완전히 monosemantic하지 않은 경우에도, 대체로 서로 broadly related한 것들을 함께 다룹니다.
Training 전체를 따라가며 본 것은 아니지만, 저희는 이것도 아마 Neuron에서 봤던 Recursive Generalization이 한 단계 더 큰 scale에서 나타나는 것이라고 생각합니다.
전반적으로 저희는 Neural Network를
weight → Neuron → Expert → Circuit
처럼 여러 scale에서 비슷한 organizing principle이 반복되는 구조로 보기 시작했습니다. 각 level마다 non-linearity 같은 고유한 세부사항은 있지만, 공통점도 많습니다.
또 Expert를 일종의 anti-Superposition architecture라고 생각하는 것도 흥미롭습니다.
Superposition은 unrelated한 것들을 한곳에 packing하려는 방향입니다. 그런데 highly specialized Expert 구조에서는 그게 어렵습니다. 어떤 Neuron이 firing하려면 먼저 그 Neuron이 속한 Expert가 router에 의해 선택되어야 하기 때문입니다.
예를 들어 실제로 RPG board game의 boss만 담당하는 Expert가 하나 있다고 해봅시다.
Superposition 관점이라면 그 Expert는 boss 하나에만 전념하기보다, 서로 관련 없는 만 가지 Feature를 한꺼번에 packing하는 편을 원할 겁니다.
하지만 그러려면 router가
“이 token이 그 만 가지 중 어느 하나에 해당하는가?”
를 전부 알아야 그 Expert로 보낼 수 있습니다.
그런데 router는 작은 linear layer 하나에 불과합니다.
그래서 저자의 요지는, MoE의 routing 구조 자체가 unrelated Feature를 마구 한 Expert 안에 packing하는 Superposition을 어렵게 만들고, 오히려 Expert specialization을 유도한다는 겁니다.
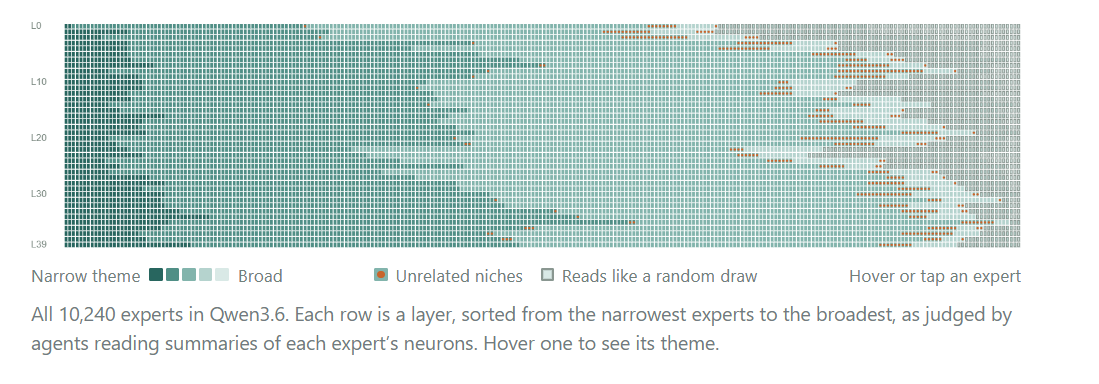
- 진한 청록: 아주 좁고 뚜렷한 theme 하나를 담당
- 연한 청록: 좀 더 broad하지만 여전히 관련된 것들을 담당
- 주황: 서로 unrelated해 보이는 niche 여러 개
- 회색: 뚜렷한 theme 없이 random draw처럼 보임
MoE의 routing 구조 자체가 unrelated Feature를 마구 한 Expert 안에 packing하는 Superposition을 어렵게 만들고, 오히려 Expert specialization을 유도한다
Explanations That Can Lose
설명을 너무 넓게 정의해버릴 위험이 있습니다. 예를 들어 “multifunctional language neuron” 같은 식입니다.
technical paper에는 이런 설명이 실제로 맞는지 테스트하는 여러 방법이 있고, Appendix에는 설명을 속이도록 설계된 near miss를 이용하는 테스트도 있습니다.
그중 특히 유용하다고 느낀 방법이 blind maximum입니다.
한 agent가 어떤 Neuron을 조사해서 짧은 설명을 작성합니다. 그리고 두 번째 agent는 그 설명만 보고, 그 Neuron을 최대한 강하게 activation시킬 것 같은 예시를 작성합니다.
그 결과는 보통 단순하고 읽기 쉬운 문장이며, 우리가 100억 token에서 찾은 어떤 실제 예시보다도 그 Neuron을 더 강하게 activation시키는 경우가 많았습니다.
Neuron의 activation을 그냥 하나의 숫자로 생각하고, blind maximum을 그 숫자를 더 크게 만드는 방법이라고 생각하기 쉽습니다.
하지만 저는 Neuron을 하나의 target처럼 생각하는 편이 더 정확하다고 봅니다. 그 중심에서 바깥으로 갈수록 의미가 점점 퍼져나가는 구조입니다.
그 Neuron으로 들어오는 각각의 입력은 자기 나름대로 작은 semantic judgment를 하고, maximum activation은 그 판단들이 가장 강하게 일치하는 지점입니다.
그래서 maximum을 찍는다는 것은 단순히 더 큰 숫자를 만드는 게 아니라, 그 Neuron이 찾고 있는 의미의 중심에 더 가까이 도달하는 것입니다.
실제 100억 token이 그 기회를 가졌지만, Neuron에 대한 설명만 보고 작성한 문장이 오히려 그 중심에 더 가까이 도달했습니다.
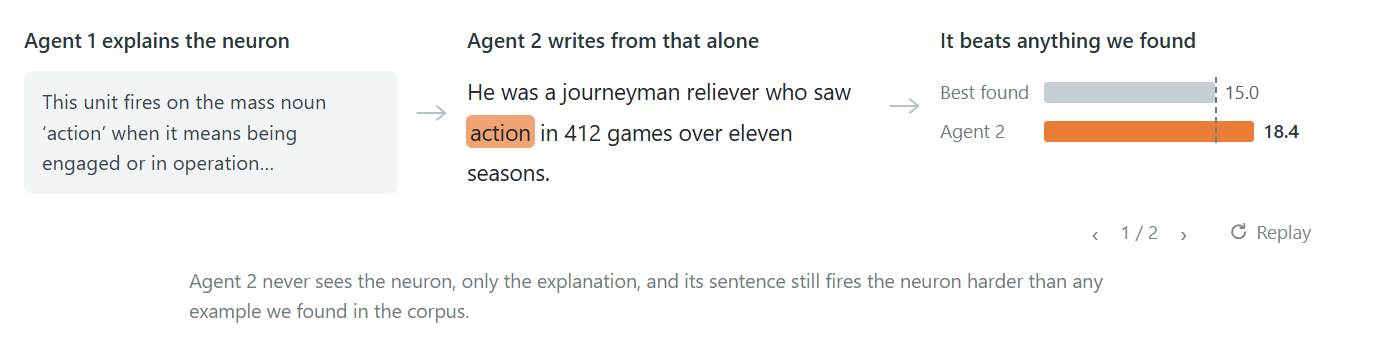
Neuron 설명이 진짜 맞는지, 그 설명만 가지고 새로운 입력을 만들어서 검증할 수 있다
blind maximum의 한계는 Neuron의 중심은 테스트하지만, 그 의미의 폭 전체를 테스트하지는 못한다는 점입니다. 어떤 Neuron이 여러 가지 job을 가지고 있다면, 그것들이 서로 관련되어 있더라도 하나의 blind maximum은 그중 하나만 건드릴 수 있습니다.
그래서 우리는 Neuron으로 들어오는 attribution을 cluster하기도 합니다. 예를 들어 pet-microchip Neuron에서는 upstream Neuron들이 대략 세 bundle로 나뉩니다. 하나는 animal tagging, 하나는 lost pets와 rescue, 하나는 microchip과 RFID identification입니다. 즉 같은 중심에서 세 방향으로 뻗어나간 구조입니다.
그다음 각 bundle마다 blind maximum을 따로 수행합니다. 이때 다른 bundle들은 전부 ablation하고, 같은 ablation 조건에서 corpus에서 찾은 가장 강한 실제 예시와 비교합니다.
만약 어떤 bundle이 자연스럽게 Generalization으로 자라난 게 아니라 억지로 packed된 unrelated Feature라면, 여기서 다른 bundle 설명들과 전혀 관련 없는 설명인데도 Neuron을 강하게 활성화하는 형태로 드러날 겁니다.
이 방법도 완전한 coverage를 주지는 않지만, Neuron의 중심만 한 번 찌르는 것보다 훨씬 넓은 영역을 검사할 수 있습니다.
설명으로부터 activation이나 circuit을 예측하는 것 같은 일반적인 테스트들도 있습니다. 다만 솔직히 저는 이런 테스트들을 어느 정도까지만 신뢰합니다.
예를 들어 cats and cars라는 설명은 V Neuron에 대한 여러 테스트에서 꽤 잘 통과할 수도 있습니다. 하지만 정작 그 Neuron의 본질이 무엇인지는 완전히 놓치고 있을 수 있습니다.
이 설명은 그 Neuron이 flames와 연결된다는 걸 알아차리면 깨뜨릴 수 있고, 다른 방법들도 많이 있습니다. 하지만 이런 것들은 단순한 summary statistic보다는 창의성과 판단을 필요로 합니다.
여기서 Interpretability는 자연과학의 다른 분야들과 비슷한 형태를 가집니다. Newtonian gravity는 엄청나게 많은 관측을 설명했지만, 결국 Mercury 궤도의 아주 작은 discrepancy에서 깨졌습니다.
가장 좋은 비판은 conjecture 자체에 구체적으로 맞춰져 있어야 합니다.
blind maximum은 Neuron의 중심을 잘 찌르는지는 보지만, Neuron이 여러 방향으로 퍼져 있으면 그 전체 breadth를 놓칠 수 있습니다. 그래서 저자는 Neuron으로 들어오는 attribution을 여러 bundle로 cluster하고, 각 bundle마다 따로 blind maximum을 수행
한 번의 strongest example로 라벨링
→ 너무 단순할 수 있음
여러 attribution cluster를 각각 검사
→ Neuron의 breadth를 더 잘 볼 수 있음
Slouching Towards Monosemanticity
초기 Vision Model들을 다시 살펴봤던 것처럼, 초기 Language Model들도 다시 보면 사람들이 왜 그들을 이해하기 어려워했는지 볼 수 있습니다.
제가 잘 아는 예시는 GPT-2 XL입니다. 제가 OpenAI에서 시작했던 초기 automated interpretability project의 모델인데, 당시에는 Neuron의 2%도 clean하게 나오지 않았습니다.
우리는 다시 돌아가서 거의 별다른 iteration 없이 500개의 neuron paper를 만들었습니다.
이제는 약 70% 정도가 대략 하나의 의미를 가진 것처럼 보이고, 그중 일부에는 Recursive Generalization으로 보이는 residual이 붙어 있습니다.
아주 pristine하게 깨끗한 Neuron의 비율은 여전히 낮고, 약 5% 정도입니다.
나머지는 몇 개의 broad한 일을 하는 Neuron들인데, 많으면 약 6개 정도이고 대부분은 2개 정도입니다.
Scoring 방식은 원래 project와 완전히 동일하지는 않습니다.
당시에 사용했던 activation reconstruction task에서는 거의 iteration 없이도 예전보다 몇 배 더 좋은 결과를 낼 수 있습니다. 하지만 저는 이제 activation reconstruction이 explanation을 평가하기에 그렇게 좋은 metric은 아니라고 생각합니다. 자세한 내용은 On Simulation Scores를 참고하면 됩니다.
더 많은 내용은 forthcoming technical paper에 있습니다.
전반적으로 보면, 작은 모델일수록 Neuron이 더 broad하고, modern model보다 residual Generalization이 더 많이 남아 있습니다.
Towards Monosemanticity 서론에 등장하는 Neuron에서도 비슷한 일이 있었을 수 있습니다. 우리가 “Neuron이 clean할 수도 있다”고 말했을 때 여러 사람과 agent들이 이 예시를 지적했습니다.
그 논문은 “Neuron이 interpretable하면 좋겠지만 실제로는 arbitrary mixture를 담고 있다”고 말하면서 시작합니다.
그리고 cat-and-car Neuron과 함께, one-layer Language Model에서 나온 한 Neuron을 예시로 듭니다. 이 Neuron은
academic citations, English dialogue, HTTP requests, Korean text가 뒤섞인 mixture
에 반응한다고 되어 있습니다.
저는 이게 사실 “don’t say a dot” Neuron일 가능성이 있다고 생각합니다. 이런 motif는 Language Model에서 아주 흔하게 보입니다.
citation, dialogue, HTTP request 사례 거의 전부가 . 근처에서 firing합니다.
그리고 이 Neuron의 strongest negative logit connection 10개 중 8개가 .로 시작합니다.
그러면 남는 건 Korean example들인데, 이들은 모두 아직 끝나지 않은 syllable의 약 2/3 지점에서 firing합니다. 이런 위치는 .를 출력하고 싶지 않은 지점으로 충분히 이해할 수 있습니다.
물론 Korean example이 두 번째 별도 의미일 수도 있습니다. model 자체가 없기 때문에 더 이상 explanation을 좁혀갈 수는 없습니다.
어느 쪽이든, 결국 이것은 작은 syntactic push 두 개 정도이고, 왜 둘이 같은 Neuron에 있는지도 이해하기 어렵지 않습니다.
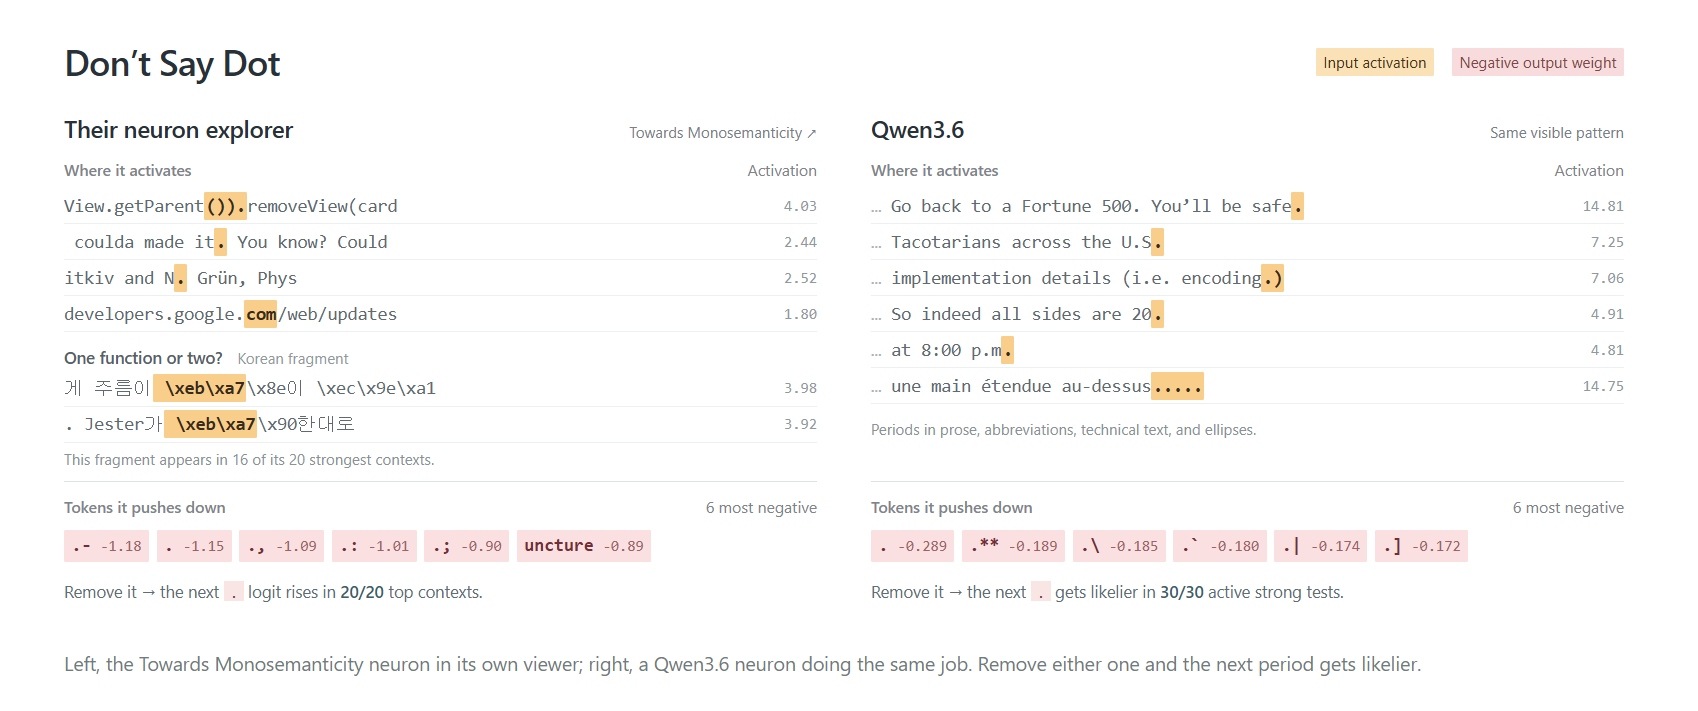
예전엔 . 근처에서 켜지는 걸 보고도 그게 왜 중요한지 몰랐는데 지금보니 .을 또 나오게 하지못하는 돈 세이 닷.
이 예시는 유용하다고 생각합니다. 왜냐하면 유명한 arbitrary mixture 사례가, 적어도 현재로서는 사실 중간 지대에 있는 것으로 보이기 때문입니다. 모델 자체가 없어서 더 계속 확인해볼 수는 없습니다.
우리는 이 Neuron이 정말 하나의 기능만 하는지, 아니면 하나의 주된 기능에 더 약하지만 관련된 syntactic pattern 하나가 추가로 붙어 있는지는 모릅니다.
하지만 어느 쪽이든, 서로 관련 없는 네 가지 일을 한다는 설명보다 훨씬 더 좁고 희망적인 설명입니다.
문제는 polysemantic이라는 말이 이 모든 경우를 한데 묶어버린다는 겁니다. 실제로는 서로 해석 가능성의 수준이 아주 다른 경우들인데도 말입니다.
2023년, 첫 automated interpretability project를 하던 시기에는 저는 작고 단순화된 모델이 interpretability를 시작하기 가장 좋은 곳이라고 생각했습니다.
생각해야 할 부가적인 요소가 적고, 모델 크기도 작으니 조사할 것도 적기 때문입니다.
하지만 지금은 오히려 그 반대일 수도 있다고 생각합니다.
그런 여러 architecture 요소들은 Neural Network가 더 잘 학습하도록 도와주기 위해 존재합니다. 예를 들어 InceptionV1에는 없었던 residual stream 같은 것들입니다.
모델을 단순화하면 오히려 Neuron이 덜 잘 학습하게 만들기 쉽습니다.
그리고 큰 모델일수록 Neuron이 더 narrow한 경향이 있기 때문에, pattern이나 motif를 찾아내기도 더 쉽습니다.
적어도 GPT-2에서는, 저는 종종 제가 모르는 motif 여러 개가 한 Neuron에 같이 섞여 있는 상태를 보고 있었고, 그 각각의 motif조차 잘 몰랐기 때문에 해석이 더 어려웠습니다.
결국 field가 원래 원하던 방향대로 더 좋은 architecture와 더 큰 scale을 채택하면서, 우리도 모르는 사이에 monosemanticity 쪽으로 점점 가까워지고 있었을지도 모릅니다.
우리가 그냥 성능 좋은 architecture와 scale을 키워왔는데, 그 과정에서 의도치 않게 Neuron들도 점점 더 monosemantic하게 만들어왔을 수 있다
The Residual Stream
Residual stream에 대한 우려는, 우리가 관심 있는 것의 수가 dimension 수보다 많다는 단순한 문제가 아닙니다. 그보다는 연속적인 형태의 packing 문제에 가깝습니다. 즉 여러 manifold가 서로 얽혀 있고, 더 많은 정보를 저장할 공간을 얻는 대신 어느 정도의 interference를 감수하는 방식입니다.
이 가능성을 완전히 배제하는 것은 어려울 수도 있습니다. 하지만 실제로는 지금까지 bottleneck이 되지는 않았습니다. 우리는 Neuron들이 residual stream에 무엇을 쓰고, 거기서 무엇을 읽는지 볼 수 있고, attribution graph도 clean하게 나오며, residual stream이 interference를 계속 쌓아두었다가 뒤에서 다시 풀어내는 모습도 관찰하지 못했습니다.
Vision Model에서는 이것을 눈으로 직접 확인해볼 수도 있었습니다.
몇 년 동안 저는 convolutional network의 residual stream을 제대로 visualize할 수 없었습니다. 어떤 map을 그려도 전부 하나의 커다란 arc처럼 나왔기 때문입니다.
알고 보니 Network는 activation mass의 거의 전부를 하나의 읽히지 않는 dimension에 몰아넣고 있었습니다. 그리고 이 dimension을 바꿈으로써, LayerNorm을 거쳐 읽히는 다른 모든 dimension의 scale을 조절할 수 있었습니다.
이 구조를 이해하고 나니, 그것을 제거하는 것은 쉬웠고, 그 뒤에는 map들이 의미 있게 보이기 시작했습니다.
이게 정확히 기술적으로 어떻게 동작하는지, 혹은 심지어 정확히 무엇을 하는지는 이 글 전체에서 반복되는 더 일반적인 패턴보다 덜 중요합니다.
Architecture가 실제로 무엇을 하고 있는지 찾아내고, Network와 싸우기보다 그 구조에 맞춰서 분석하라는 것입니다.
그리고 이것은 field가 결국 어차피 만들게 된 어떤 구조를 가리키기도 했습니다. 바로 attention입니다.
Language Model에도 비슷한 수정이 필요한지는 아직 모릅니다.
우리가 Language Model의 residual stream을 visualize했을 때는, 대부분 그냥 잘 동작했습니다. 다만 text 전체의 map이 의미가 있는지 판단하는 것은 image map을 한눈에 보는 것보다 훨씬 어렵습니다. 그래서 이 작업의 대부분을 Vision에서 수행했습니다.
어차피 Language Model에서는 하나의 global map 자체가 최선의 도구가 아닐 수도 있습니다.
결국 어떤 view가 가장 적절할지는 아직 열려 있습니다.
- submanifold를 보는 방법
- Neuron이 무엇을 읽고 쓰는지 보는 방법
- lens-style readout
등 여러 가능성이 있습니다.
하지만 지금까지 시도한 방법들은 전부 잘 작동했고, 우리가 도저히 이해할 수 없는 residual stream의 영역을 아직 만나지는 못했습니다.
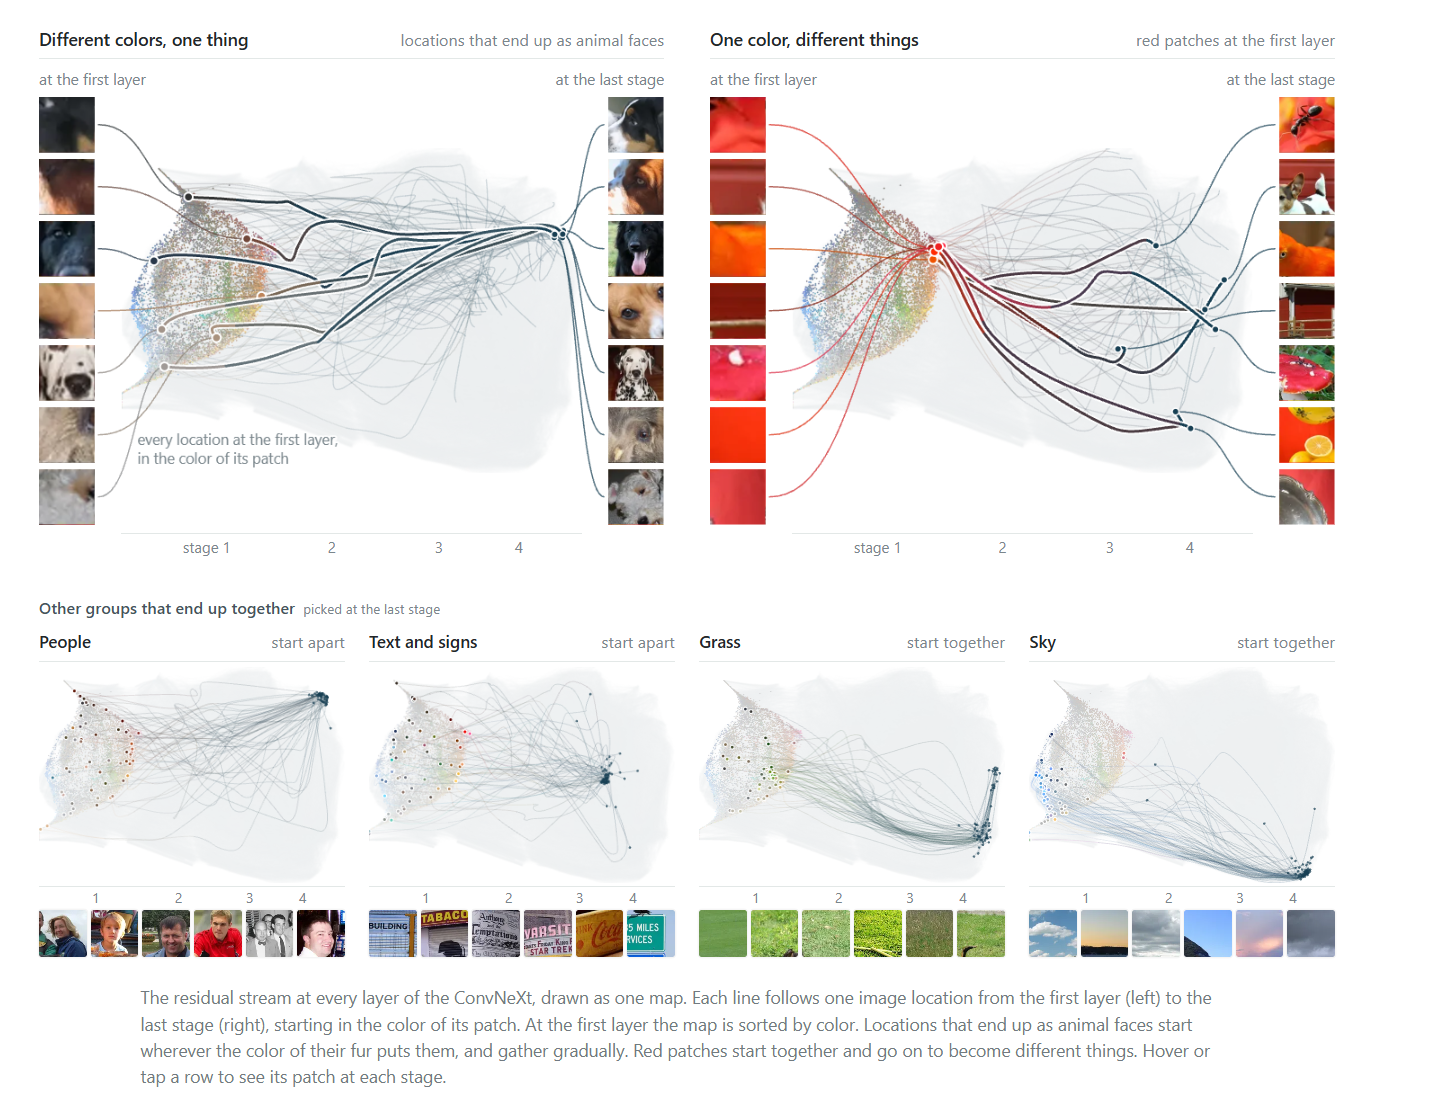
Residual Stream이 여러 Feature를 알아볼 수 없게 마구 뒤섞어 놓는 공간처럼 보이지 않고, Layer를 거치며 representation을 체계적으로 semantic하게 정리하는 공간으로 보인다.
즉 Residual Stream안에 뭔가 얽힘이 강하게 나오진 않는다.
Residual Stream 안에 고차원적인 continuous Superposition이 있을 가능성은 인정하지만, 실제 circuit tracing을 해보면 정보 흐름이 꽤 읽히기 때문에 지금까지는 큰 interpretability 문제로 보이지 않았다는 뜻
우리는 앞서 Layer를 극단적으로 줄였던 실험과 비슷하게, Residual Stream 자체도 강하게 압축해봤습니다.
7M parameter의 medium ConvNeXt를 다시 학습하면서, Residual Stream의 width를 원래보다 4배, 8배 더 좁게 만들었습니다.
마지막 Block에서는 결국 46 dimension밖에 남지 않도록 줄였지만, Neuron 수 자체는 그대로 유지했습니다.
Accuracy는 72%에서 각각 **60%, 39%**로 떨어졌습니다.
그런데 normal-width model과 비교해보면, 압축된 Residual Stream의 map은 조금 더 지저분해졌을 뿐 전체적인 구조는 꽤 비슷하게 보였습니다.
무언가가 영리하게 서로 얽혀 interleaving되어 있는 모습은 보이지 않았습니다.
Neuron이 Residual Stream에서 무엇을 읽고 무엇을 쓰는지를 봐도 같은 이야기가 나옵니다. 압축할수록 noise는 늘지만, 새어 들어오는 정보는 여전히 비슷한 종류입니다.
예를 들어 dark-bird-on-water Neuron이 alligator나 swimming retriever에도 반응할 수는 있지만, clock 같은 완전히 unrelated한 것에는 반응하지 않습니다.
우리는 Residual Stream이 이론적으로 무엇을 담을 수 있고 없는지를 증명하는 것보다, Neural Network를 이해하는 데 실제로 어떤 bottleneck이 생기는지를 더 중요하게 생각합니다.
공간을 강제로 줄였는데도 interference가 map이나 Neuron의 read/write에서 뚜렷하게 나타나지 않는다면, 저희는 꽤 좋은 상황이라고 봅니다.
이제 남는 우려는 Residual Stream의 dimension보다 Feature가 더 많다는 점입니다.
하지만 Stream은 여러 정보를 적절한 direction에 배치하기만 해도 dimension 수보다 훨씬 많은 Feature를 담을 수 있습니다. Feature 수 > dimension 수라는 사실만으로는 곧바로 packing이라고 할 수 없습니다.
이 문제는 주로 모델의 모든 Feature를 큰 목록으로 뽑고 싶을 때 중요해집니다. 그리고 많은 사람들이 바로 그 목적으로 Residual Stream을 분석합니다.
하지만 Zooming Out에서 논의하듯, 저희는 거대한 Feature 목록을 만드는 것이 최종 목표라고 생각하지 않습니다.
그래도 그런 목록을 원한다면, Neuron들이 Residual Stream에 write하거나 read하는 direction부터 보는 것이 좋은 출발점입니다.
또한 Block Sparse Featurizer가 찾아내는 것과 같은 continuous submanifold도 좋은 후보입니다. Residual Stream에는 특별히 선호되는 basis가 없기 때문에, 이런 continuous submanifold가 특히 자연스러운 표현일 수 있습니다.
지금까지는 이런 방법들이 모두 잘 작동했습니다. 의미 있는 subspace를 찾아낼 수 있었고, 그것들이 Layer를 거치며 어떻게 변하는지도 추적할 수 있었습니다.
Language Model의 Residual Stream은 Vision Model만큼 많이 보지는 않았지만, 지금까지 본 결과는 같은 이야기를 지지합니다.
고수준의 구조나 motif를 이해하는 데 있어서, Residual Stream이 지금까지 특별한 장애물이 된 적은 없습니다.
Residual Stream도 강제로 좁혀봤는데, 공간이 부족해져도 “unrelated Feature를 교묘하게 얽어 packing하는 모습”은 별로 안 보였다
Residual Stream에 theoretical packing 가능성은 남아 있지만, 실제로 network를 이해하는 데 방해될 정도의 interference는 지금까지 못 봤다.
Attention
Attention에 대해서는 Neuron만큼 많이 진전하지 못했고, 대부분은 이 글의 범위 밖에 있습니다.
솔직히 말하면, Attention을 우리가 관심 있는 의미의 Superposition이라고 자신 있게 말할 만큼 충분히 이해한 사람이 있는지조차 잘 모르겠습니다.
Attention이 읽기 어렵다고 해서 그 원인을 Superposition이라고 보는 것은 쉽지 않습니다. 다른 가능한 원인들과 구분하기가 어렵고, 새로운 mechanism이 이해하기 어렵다는 이유만으로 learning principle 자체가 달라졌다고 보는 가설을 우선순위 높게 둘 필요는 없다고 생각합니다.
Attention의 유용성 중 상당 부분은 오히려 더 쉬운 부분에 있는 것 같습니다.
Attention은 몇 가지 질문으로 나눠볼 수 있습니다.
- 어디를 보는가
- 무엇을 찾는가
- 찾았을 때 무엇을 하는가
- 왜 그렇게 하는가
이 중 어디를 보는가는 비교적 쉽습니다. 거의 공짜로 얻을 수 있는 정보이고, 이것만으로도 이미 많은 것을 알려줍니다.
앞서 preeclampsia graph에서는 Attention이 두 가지 일을 했습니다.
첫째, case의 여러 사실을 she라는 token 위치에 모읍니다. 그 위치에서 모델이 medical question을 정리합니다.
둘째, 그다음에는 질문의 wording이 실제로 다음에 무엇을 말할지를 결정합니다.
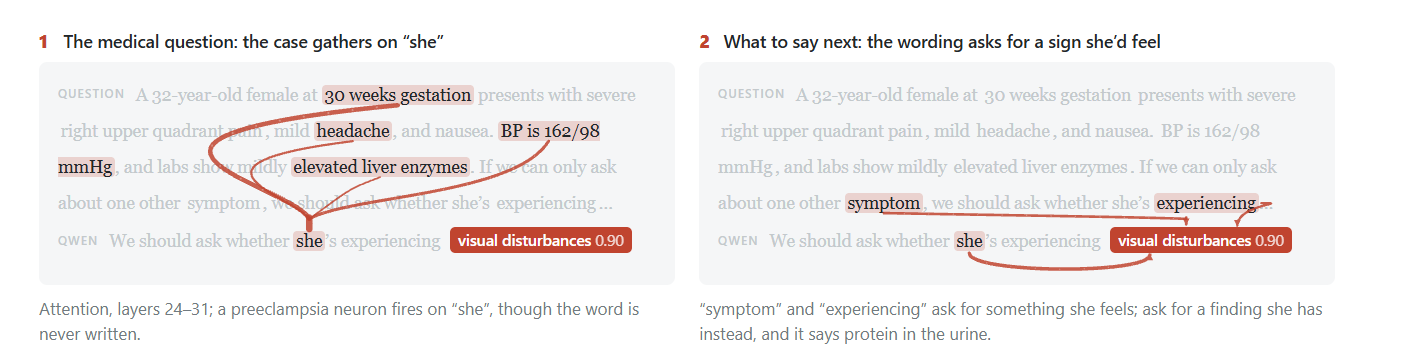
Attention이 “의학적 사실을 모아 판단하는 단계”와 “그 판단을 어떤 형태의 답으로 꺼낼지 정하는 단계”를 따로 맡는 모습이 보인다는 것.
즉 she가 일종의 환자 상태를 종합해두는 scratch location처럼 쓰이는 것
우리는 Attention이 무엇을 찾고 있는지, 그리고 그것을 찾았을 때 무엇을 하는지도 Neuron 관점에서 이해할 수 있습니다. 저희는 이것만으로도 Attention이 하는 일의 상당 부분을 이해할 수 있다고 생각합니다.
예를 들어 preeclampsia 사례에서 "headache" 뒤의 comma를 봅시다.
Layer 30의 Attention Head 세 개가 Residual Stream에서 직접 정보를 읽습니다. 그런데 그 Head들이 읽는 direction에 무엇이 write되어 있는지를 따라가 보면,
- headache Neuron
- migraine Neuron
- brain Neuron
이 보입니다.
그리고 이 Head들이 write하는 정보는 comma 위치의 preeclampsia Neuron에 주로 도달하고, 그 주변의 eclampsia, hypertension 같은 Neuron에도 일부 전달됩니다.
이 세 Attention Head를 ablation하면 preeclampsia activation이 약 25% 감소합니다.
반대로 이 Head들이 pain을 보지 못하게 막아도 아무 변화가 없습니다.
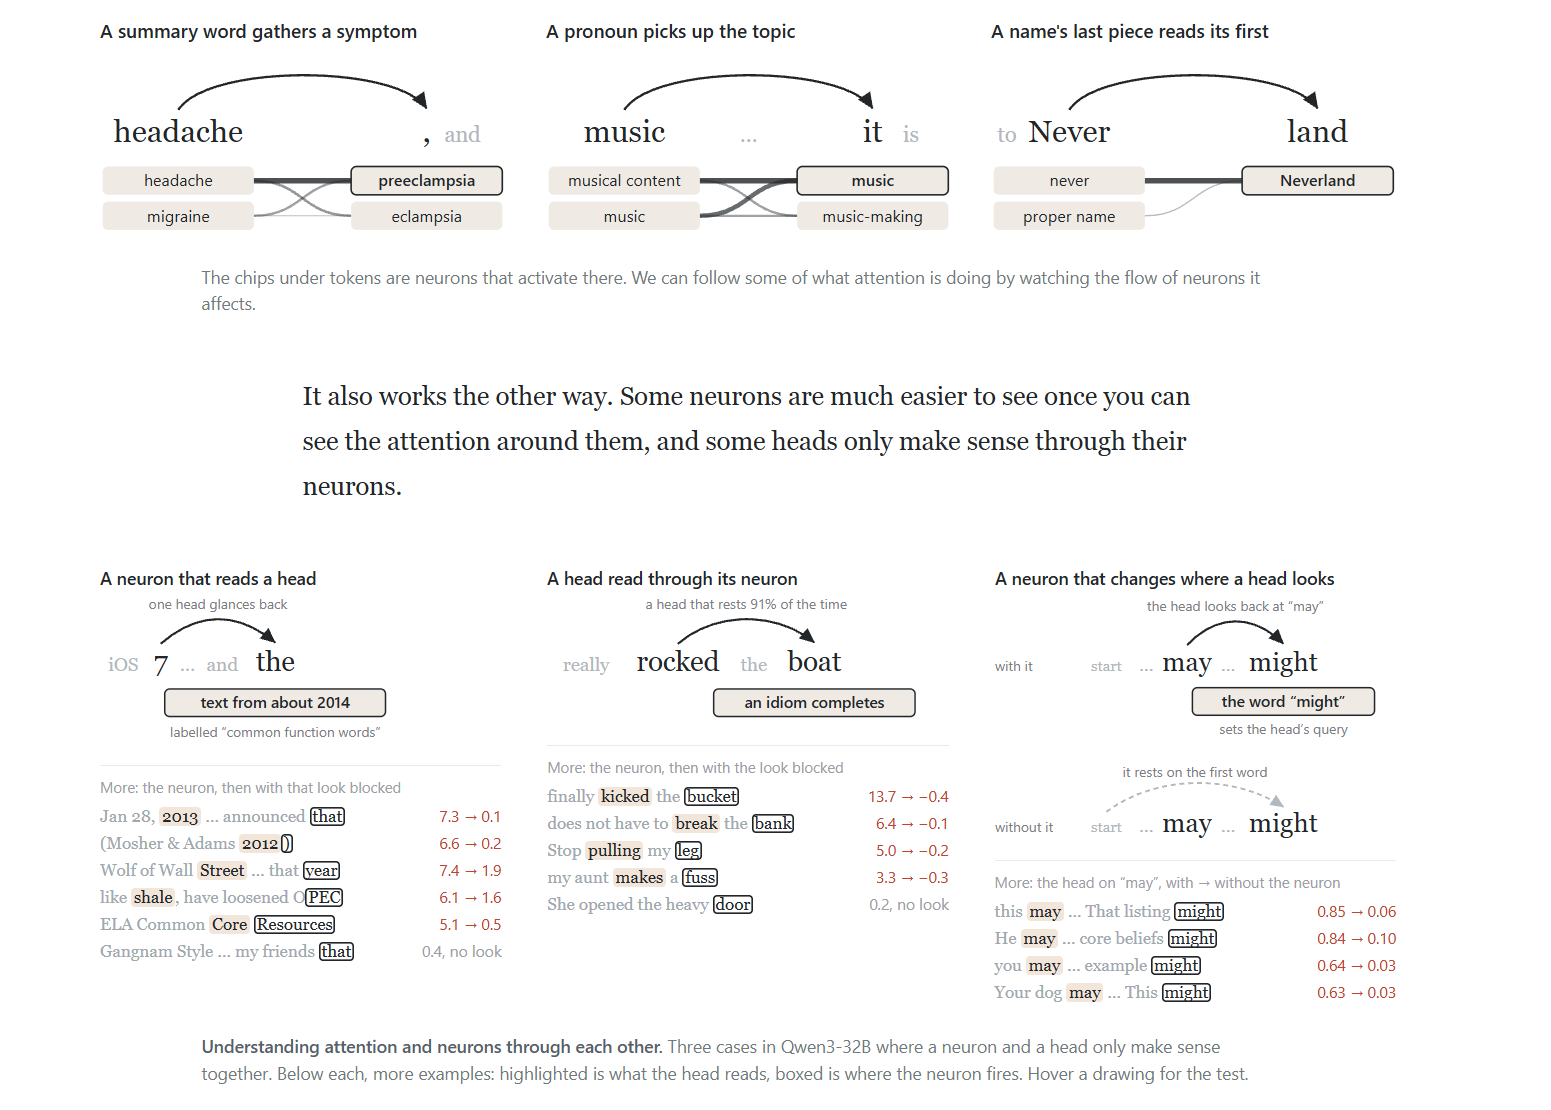
Attention과 Neuron을 따로 보면 애매한데, 둘을 같이 보면 “Attention이 무슨 정보를 어디로 옮기는지”가 꽤 읽힌다
Neuron = 어떤 semantic information인지 보여줌
Attention = 그 information을 어디서 읽어 어디로 보내는지 보여줌
둘을 같이 보면 Attention Head의 기능도 훨씬 구체적으로 해석할 수 있다는 주장
전반적으로 저희는 Attention과 Neuron이 그렇게 분리된 대상이라고 생각하지 않습니다.
Attention이 정보를 어디에 가져다 놓는지를 이해하는 것은, 그다음 그 정보를 처리하는 Neuron을 이해하는 데 매우 도움이 됩니다. 예를 들어 정보가 숫자의 끝이나 comma 같은 특정 위치에 자주 놓인다는 식의 단순한 motif도 꽤 유용했습니다.
제 경험으로는, 어떤 Attention Head가
- 어떤 Neuron에서 정보를 읽고,
- 어떤 Neuron에 영향을 주고,
- 어디를 보고 있는지
이 세 가지만 봐도 상당히 많은 것을 알 수 있습니다.
이 방식으로 잘 얻기 어려운 주요 정보 하나는, 각 Attention Head 전체에 붙일 수 있는 global name입니다.
그런 이름이 있으면 좋겠지만, 지금까지는 Neuron이나 attribution graph를 탐색하는 데 큰 bottleneck은 아니었습니다.
저는 꽤 많은 사례를 본 뒤, Attention Head에 global label을 붙일 수 있다면 추가로 얻는 설명력, 즉 marginal explanatory residual은 약 5% 정도일 것이라고 추정했습니다.
그다음 제 추정을 알려주지 않은 상태에서 agent에게 attribution graph 100개를 보게 하고 같은 평가를 시켰는데, agent도 약 5% 정도로 봤습니다.
그 5%는 대략 절반씩 나뉩니다.
- 하나는 비교적 이름 붙이기 쉬운 position head
예: 한 token 뒤를 보는 Head - 나머지는 더 다양하고, 그래서 이름 붙이기 어려운 Head들
물론 아직 우리가 모르는 지식의 가치가 얼마나 될지는 판단하기 어렵기 때문에, 이런 추정은 꽤 틀릴 수도 있습니다.
그래도 지금까지는 Attention Head 전체에 global label이 없어도, local attention flow와 global Neuron explanation만으로 high-level structure와 motif를 꽤 많이 발견할 수 있다고 생각합니다.
낮은 confidence의 예측이지만, 저는 Attention Head도 결국 작은 모델의 Neuron처럼 broad하고 Recursive Generalization된 형태일 가능성이 있다고 봅니다.
이유는 Attention Head의 수가 훨씬 적기 때문입니다. Qwen3-32B에는 Attention Head가 몇 천 개 정도인 반면, Neuron은 100만 개 이상 있습니다.
Attention은 global label 없이도 local routing을 보면 꽤 이해 가능하고, Head 하나는 아마 Neuron보다 더 broad한 기능을 맡을 가능성이 크다. ( Neuron 설명 + local attention flow만으로도 정보의 흐름을 알 수 있기에 라벨 달 이유가 적다.)
Zooming Out
What I Mean by Clean
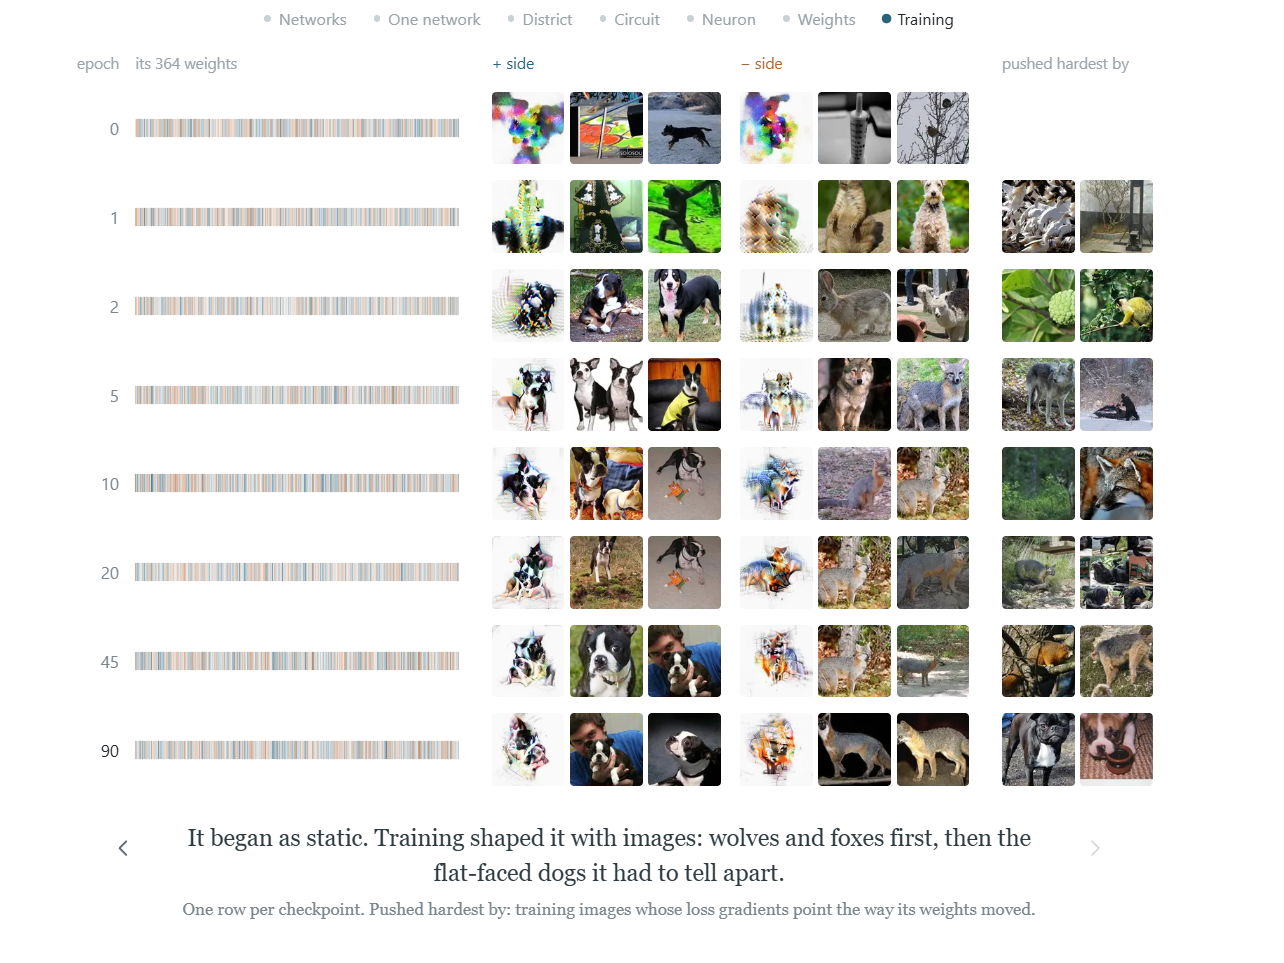
제가 Neural Network가 이미 clean하다고 말할 때, 그건 단순히 Neuron이 monosemantic하다는 것보다 더 깊은 의미입니다. 물론 그 기준으로만 보더라도, 저는 상황이 field가 예상하는 것보다 훨씬 낫다고 생각합니다.
제가 말하는 핵심은, Network의 각 part가 downstream reader가 읽고, 또 그 위에 무언가를 쌓을 수 있도록 만들어져 있다는 것입니다.
이런 의미에서 Neural Network는 거의 explanation의 fractal과 같습니다. 여러 scale에서 coherent하고 유용한 grouping이 반복됩니다.
- macro scale에서는 mechanism 수준에서
- micro scale에서는 Recursive Generalization이 각 mechanism을 형성하는 방식에서
이것은 Interpretability의 목표를 하나 제안합니다.
우리도 Network의 또 하나의 reader가 되는 것.
Network 내부의 reader들이 읽는 방식에 가까워질수록, 저는 Network가 더 interpretable하게 보일 것이라고 생각합니다.
반대로 너무 인간의 방식으로만 Network를 읽고, 우리의 선입견에 맞는 concept으로 딱 떨어지지 않는다는 이유로 messy하다고 결론내리는 것은 조심해야 합니다.
Network가 이렇게 organized되는 이유 중 하나는, 그렇게 만드는 편이 학습하기 더 빨랐기 때문이라고 생각합니다.
이미 Network 안에 car 관련 area가 있고 거기에 car part들이 모여 있다면, 새로운 car-related information이 생겼을 때 완전히 다른 곳에 두 번째 car area를 만드는 것보다 기존 car area에 추가하는 편이 쉽습니다.
저는 이것이 circuit racing이나 gradient starvation 같은 아이디어와 밀접하게 관련되어 있다고 생각합니다.
우리는 보통 interpretable과 monosemantic을 거의 동의어처럼 생각합니다.
저는 이것이 어느 정도는 이런 개념들이 InceptionV1이라는 model organism에서 발전했기 때문이라고 생각합니다.
InceptionV1은 거의 bimodal하게 보였습니다.
초기 Layer는 interpretable하고 monosemantic했지만, 뒤쪽 Layer는 arbitrary mayhem처럼 보였습니다.
그런데 Language Model에서 우리가 보는 모습은 그 중간쯤입니다.
대부분의 Neuron은 대체로 하나의 의미를 가지고 있고, 일부는 몇 가지 의미를 가집니다.
그렇다면 이게 얼마나 나쁜 걸까요?
Interpretability에는 크게 두 가지 스타일이 있습니다.
하나는 enumerative interpretability라고 부를 수 있습니다.
목표는 audit할 수 있는 거대한 Feature 목록을 만드는 것입니다. 의미 있는 pattern을 놓치지 않았는지 확인하기 위해서입니다.
이 관점에서 큰 우려 중 하나는 curse of dimensionality나 combinatorial explosion을 피하는 것입니다.
즉 수많은 item들이 서로 연결되고, 각 item이 여러 의미까지 가진다면 전체 구조가 폭발적으로 복잡해질 수 있습니다.
다른 스타일은 exploratory interpretability라고 부를 수 있습니다.
이 접근은 질문에서 시작합니다.
Neural Network의 어느 부분이든 탐색할 수 있고, Google Maps처럼 attribution graph와 Neuron, Attention Head 같은 mechanism 사이를 자유롭게 zoom in / zoom out할 수 있습니다.
그리고 탐색하면서 새로운 질문도 계속 생깁니다.
Neuron 같은 mechanism은 좋은 출발점이지만, Neuron이 모든 문제의 최종 해결책이라는 뜻은 아닙니다. 다만 저는 사람들이 생각하는 것보다는 훨씬 그에 가깝다고 생각합니다.
이 접근은 Polysemanticity에 훨씬 더 강합니다.
그리고 분석과 관련 없는 도시 구역을 무시하는 도시 연구자처럼, Network의 많은 부분을 그냥 무시해도 괜찮습니다.
저는 exploratory approach가 더 fruitful할 것이라고 생각합니다.
field도 이미 이 방향으로 움직이고 있는 것 같지만, 이 관점이 명확하게 정리되어 쓰인 적은 많지 않은 것 같습니다.
이 관점에는 몇 가지 implication이 있습니다.
예를 들어
“Feature 수가 dimension 수보다 많은가?”
같은 질문은 대부분 중요하지 않게 됩니다.
또 notoriously 정의하기 어려운 Feature 자체를 굳이 정의할 필요도 없습니다.
대신 우리는
- 모델 자체에 실제로 존재하는 Neuron과 Attention Head 같은 mechanism
- 그 mechanism들을 통과하는 data
- 그런 mechanism들의 group
- 여러 곳에서 반복해서 나타나는 motif
에 집중할 수 있습니다.
거대한 Feature list는 애초에 최종 목표가 아니라, 어떤 목적을 이루기 위한 수단이었습니다.
그리고 그 Feature list를 꼭 만들지 않아도, 같은 목적에 도달할 수 있는 다른 길이 있을지도 모릅니다.
Interpretability의 목표를 ‘모든 Feature 목록 만들기’에서 ‘Network가 정보를 처리하는 방식을 따라가며 이해하기’로 바꾸자
그래서 두 접근을 대비합니다.
- Enumerative interpretability: 모델 안의 Feature를 최대한 전부 찾아서 거대한 목록을 만들자. → Superposition, Feature 수 > dimension 같은 문제가 매우 중요해짐.
- Exploratory interpretability: “왜 이 답을 했지?”, “이 정보는 어디서 왔지?” 같은 질문에서 출발해서, attribution graph를 따라 Neuron → Attention → Circuit → 더 작은 mechanism으로 zoom in/out하자.
저자는 후자를 밀고 있습니다.
“Feature가 dimension보다 많은가?”보다 “모델의 실제 mechanism이 무엇을 읽고, 무엇을 쓰고, 어떻게 연결되는가?”가 더 중요하다.
Motifs Over Monosemanticity
만약 버튼 하나를 눌러서 모든 Neuron을 완벽하게 monosemantic하게 만들 수 있거나, 아니면 제가 실제로 관심 있는 몇 가지 질문에 대해 그 뒤에 있는 Circuit motif를 이해할 수 있다면, 저는 바로 motif 쪽을 택할 겁니다.
예를 들어 제가 관심 있는 건 이런 것들입니다.
agent의 psychology를 물어보는 올바른 방법은 무엇인지, Circuit이 persona selection model과 어떻게 연결되는지, agent가 자신의 goal을 어떻게 생각하는지, 그리고 자기 자신과 다른 존재 사이의 경계를 어떻게 다루는지 같은 것들입니다.
100년 뒤 미래에서 Interpretability researcher 한 명이 왔다고 상상해봅시다. 그 사람은 우리가 궁금해하는 질문의 답뿐만 아니라, 애초에 우리가 어떤 질문을 했어야 하는지까지 알고 있습니다.
그 사람이 우리에게 뭐라고 말할까요?
저도 알 수는 없습니다. 하지만 저는 한 번 작은 규모로나마 비슷한 위치에 있었던 적이 있습니다. 지금은 Vision Model 하나를 대체로 이해한다고 느끼는데, 그런 의미에서는 8년 전의 제 자신에게 제가 일종의 미래 researcher인 셈입니다.
그때의 저에게 말해줄 수 있다면 이렇게 말했을 겁니다.
눈앞에 있는 거대한 pose Circuit을 제대로 봐라.
Negative pole을 Neuron의 반대 의미로 생각하지 말고, Circuit 안의 gate로 생각해라.
Late Layer에서는 Feature Visualization이 reward hacking을 하기 때문에, 거기서 보이는 messy한 부분 중 일부는 Network가 아니라 tool의 문제다.
마지막 Layer가 messy한 이유 중 일부는 나쁜 architecture 때문이기도 하다. 그건 중요한 신호이니 억지로 덮지 마라.
그리고 Polysemanticity가 보일 때마다 더 깊이 들여다봐라.
눈에 띄는 noise는 대개 아직 네가 갖고 있지 않은 explanation을 가리키는 단서다.
이 중 거의 어느 것도 Feature list와 관련된 이야기는 아닙니다.
과거의 저에게 이런 조언을 직접 건네줄 수 없다면, 그다음으로 가장 좋은 것은 원래 Neuron과 Circuit을 그대로 주면서 “이걸 더 자세히 봐라”라고 적어두는 것일 겁니다.
그래서 Recursive Generalization과 Superposition의 차이가 그렇게 중요합니다.
Noise를 따라가며 분석하는 방식이 유효하려면, 그 noise 자체가 무언가를 가르쳐줄 수 있어야 합니다.
Generalization을 통해 자라난 grouping은 우리에게 무언가를 가르쳐줄 수 있습니다.
반면 서로 관련 없기 때문에 그냥 packed된 것들의 grouping이라면, 거기서 배울 수 있는 것은 거의 없습니다.
그래서 미래 researcher가 해줄 조언도 비슷할 거라고 생각합니다.
그들은 자신들에게는 너무 당연하지만 우리에게는 보이지 않는 motif들의 집합을 건네줄 수도 있습니다.
하지만 그럴 수 없다면 아마 이렇게 말할 겁니다.
원래 Neural Network를 계속 봐라.
너무 잘게 쪼개지 마라.
그것을 보는 법을 배워라.
이건 약간 The Hitchhiker’s Guide to the Galaxy와 비슷합니다. 거기서는 정답 42는 이미 알고 있고, 문제는 질문이 무엇이었는지를 찾는 것입니다.
Network 자체가 이미 answer이고, Interpretability는 상당 부분 올바른 question을 찾아가는 과정입니다.
그리고 그 question을 찾는 데 있어서, Network 그 자체보다 더 좋은 guide를 찾기는 어렵습니다.
제가 “Network는 이미 clean하다”고 말할 때의 더 깊은 의미가 바로 이것입니다.
Interpretability의 목표를 모든 Neuron을 완벽하게 monosemantic하게 만드는 데 두지 말고, 실제로 중요한 질문을 풀어주는 Circuit motif를 이해하는 데 두자
- Neuron 하나하나를 완벽하게 깨끗하게 분해하는 것보다, 정보가 어떤 motif와 Circuit을 통해 처리되는지 아는 게 더 중요함.
- Polysemanticity나 noise가 보이면 바로 “Superposition이라 어쩔 수 없음”이라고 하지 말고, 그 noise가 어떤 Generalization이나 mechanism에서 나왔는지 더 파고들어야 함.
- 왜냐하면 Recursive Generalization으로 생긴 이상한 grouping은 Network가 무엇을 비슷하다고 보는지 알려주는 단서가 되지만, unrelated Feature를 그냥 packing한 Superposition이라면 그런 단서가 거의 없음.
- 그래서 Network를 너무 SAE나 Feature list로 잘게 쪼개기보다, 원래 Neuron·Attention·Circuit을 그대로 보면서 올바른 질문을 찾아가자는 입장.
network is already clean의 가장 깊은 의미는 Network가 인간 개념대로 깔끔하다는 뜻이 아니라, Network 내부의 조직 원리를 제대로 읽는 법만 찾으면 생각보다 일관된 구조가 이미 존재한다는 뜻
A City vs a Knot
더 큰 시스템이 반드시 탐색하기 더 어려운 것은 아닙니다.
작은 마을에서는 “financial district가 어디냐”고 물어도 거의 말이 안 될 수 있습니다. 관련된 것들이 여기저기 흩어져 있기 때문입니다. 은행은 한 거리, 보험사는 다른 거리, 회계사는 집에서 일하고 있을 수도 있습니다.
반면 New York에서는 financial district를 지도에서 1분 안에 찾을 수 있습니다.
우리는 ConvNeXt에서도 비슷한 현상을 봤습니다.
Agent들이 큰 모델에서 dog-ear Neuron을 더 빨리 찾았습니다. 큰 모델에서는
- pale ear
- wavy ear
- head-side ear
같은 Neuron들이 하나의 hanging-ears Neuron으로 모여들었고, 그 Neuron이 자연스러운 출발점이 되었기 때문입니다.
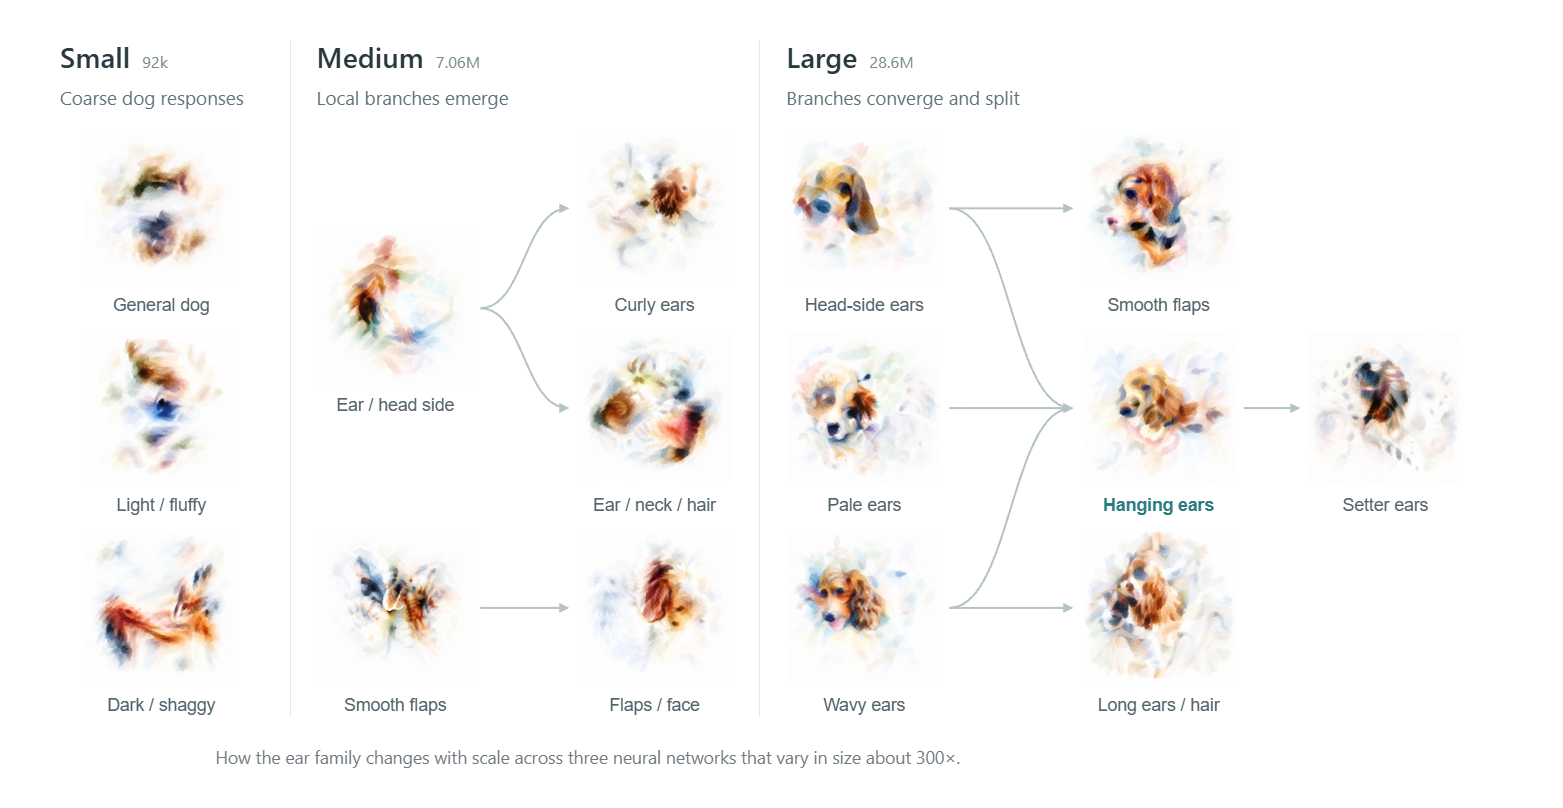
큰 모델은 더 복잡하지만, 관련 Feature들이 더 잘 조직되어 있어서 오히려 해석하기 쉬울 수 있다.
Interpretability에는 더 나은 map이 필요합니다.
저는 tethered abstraction을 제안합니다. 즉, 멀리 zoom out해서 큰 패턴을 보더라도, 그 패턴이 실제로 어떤 Neuron과 Circuit에 의해 지탱되는지 연결을 유지하는 view입니다.
Activation Atlas에서 영감을 받은 저희의 ConvNeXt atlas가 한 예입니다.
예를 들어 모델이 killer whale이라고 판단한 지점에서 시작해서, 핵심 Neuron 하나를 골라 그 Neuron이 실제로 어떤 이미지들에 반응하는지 확인한 다음, 다시 zoom out할 수 있습니다.
그렇게 보면 이 family가 사실 세 개의 별도 route로 나뉜다는 걸 알 수 있습니다.
- whale을 위한 route
- shark와 ray를 위한 route
- angler가 들고 있는 fish를 위한 route
다만 map이 꼭 visual일 필요는 없습니다. 그리고 하나의 map 자체가 목적도 아닙니다.
여러 종류의 map과 여러 agent가 있어야 하고, 이들이 모두 개별 Neuron과 Circuit에 계속 tethered된 explanation을 만드는 방향으로 작동해야 합니다.
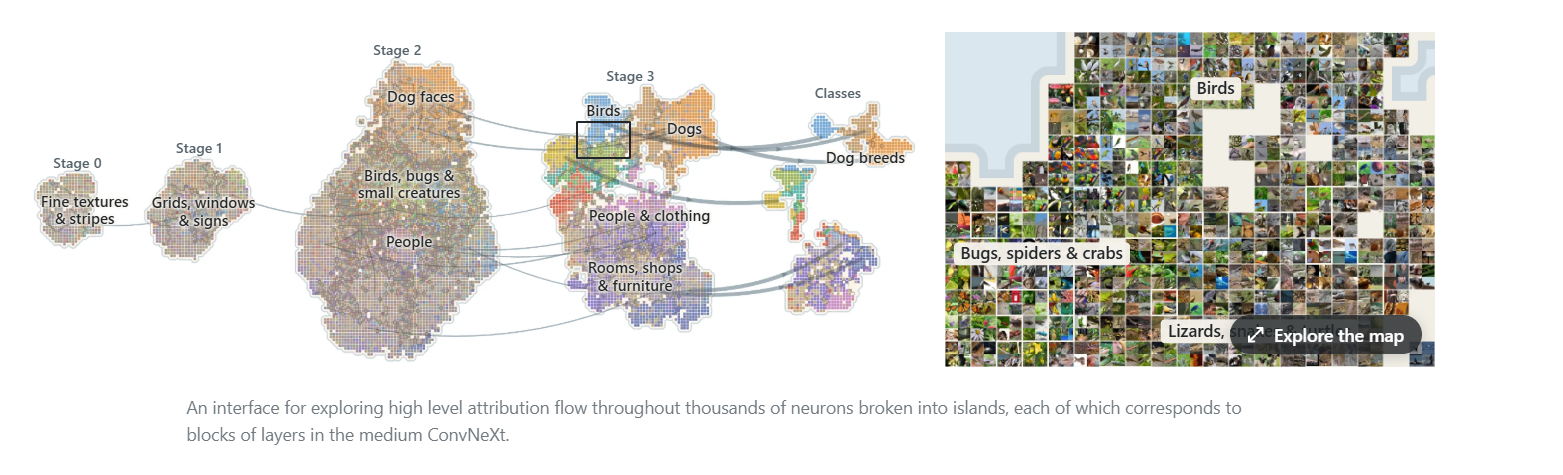
Interpretability는 모델을 잘게 분해하는 것만이 아니라, 전체 구조와 개별 mechanism 사이를 자유롭게 오가며 보는 map이 필요하다.
물론 map이 이해 가능하게 보인다고 해서, 그 map을 실제로 이해한 것은 아닙니다.
여전히 우리는 일반적인 science의 방식, 즉 conjecture와 criticism을 해야 합니다. 어떤 것이 무엇인지 가설을 세우고, 그 가설을 깨뜨리려 해보고, 살아남은 설명을 유지해야 합니다.
Network는 낯설지만, 그 낯섦은 반복됩니다. 그래서 한번 검증을 견딘 가설은 여러 곳에서 반복해서 큰 도움이 되는 경우가 많습니다.
우리는 두 가지를 모두 경계해야 합니다.
하나는 우리의 개념을 Network에 너무 강하게 강요하는 것이고, 다른 하나는 Network를 지나치게 잘게 쪼개는 것입니다.
New York을 잘 아는 사람이 Tokyo에 처음 도착했다고 상상해봅시다.
“Tokyo의 Brooklyn은 어디지?”라는 질문은 좋은 출발점이 될 수 있습니다.
하지만 Tokyo의 서로 떨어진 70개 조각을 모아서 Brooklyn을 재구성하게 된다면, 실제보다 Tokyo를 훨씬 더 messy하게 만들어버린 것일 수도 있습니다.
4e:55에서 일어난 일이 약간 이와 비슷합니다.
우리의 category로 보면 cats와 cars였고, 그래서 엉망처럼 보였습니다.
하지만 실제로는 처음부터 계속 V였습니다.
그 Layer에 학습한 SAE도 같은 식으로 그것을 쪼갭니다. 하나의 V를 car Feature와 cat Feature로 분리합니다.
저는 sparse dictionary 자체를 일반적으로 반대하는 것은 아닙니다. 하지만 여기서는 오히려 Neuron이 실제로 하는 일에서 더 멀어지게 만듭니다.
Probe는 첫 번째 위험을 더 심하게 만듭니다.
Probe는 우리가 이미 가지고 있던 질문에만 답할 수 있기 때문입니다.
그러므로 어떤 질문을 해야 하는지는 가르쳐주지 못합니다.
도시를 이해하려면 결국 그 도시 자체의 organization을 배워야 합니다.
Probe나 sparse dictionary 같은 higher-level structure도 여전히 유용할 수 있습니다.
하지만 이런 것들은 시작점이 아니라 끝에 있어야 합니다.
제가 이런 종류의 것을 실행해본 경우, 결국 모두 highly interpretable한 Neuron들로 분해되었습니다.
Training이 만드는 변화들도 마찬가지였고, on-policy self-distillation도 포함됩니다.
Neuron이 abstraction을 담당하고, data가 specific case를 담당한다면, 그 둘 사이에 남는 부분은 사람들이 생각하는 것보다 훨씬 작습니다.
그리고 저는 그 남은 부분도 같은 방식으로 연구할 겁니다.
고정된 optimization 하나를 적용하는 것이 아니라, Neuron, data, 그리고 둘의 group 사이를 오가는 general scientific agent를 사용하는 방식입니다.
Anthropic의 Joshua Batson이 draft를 읽고 표현했듯, 그런 빠진 조각들은
“기존 puzzle 위에 완전히 무작위로 흩뿌려지는 게 아니라, 처음 puzzle 안에 들어맞을 것이다.”
Interpretability를 해결하는 과정은 AGI를 달성하는 것과 비슷한 점이 있을지도 모릅니다.
가까이 갈수록 goalpost가 계속 움직입니다.
항상 또 다른 weak activation을 지적할 수 있습니다.
Curve Detectors에서 우리는 Neuron 10개만 가지고 40페이지에 걸친 실험을 했습니다.
최소한 하나라도 확실한 monosemanticity 사례를 확인하기 위해서였습니다.
몇 년 뒤에도 일부 researcher들은 그 예시들 중 어느 것도 정말 monosemantic인지 의심한다고 말했습니다.
우리가 뭔가 놓쳤을 수도 있고, formal proof를 만들어낼 방법도 아무도 모른다는 이유였습니다.
그 기준을 따르면 monosemantic Neuron이 단 하나라도 존재한다고 말하는 것조차 overclaim이 됩니다.
Neuron의 작은 error를 걱정하는 배경에는, safety가 결국 우리가 놓친 어떤 activation 하나에 달려 있을지도 모른다는 두려움이 있습니다.
즉 deception이 숨어 있는 바로 그 activation을 놓칠 수 있다는 두려움입니다.
하지만 제가 걱정하는 risk는 다릅니다.
잘 조직된 도시에 들어와 있는데, 우리가 그곳의 native가 아니기 때문에 그 도시를 어떻게 생각해야 할지 모르는 상황에 더 가깝습니다.
이 essay에서 다뤘던 모든 error는 눈앞에 그대로 있었지만 우리가 읽는 방법을 몰랐거나, tool이 잘못 읽은 것이었습니다.
놓쳐버린 hidden activation이었던 경우는 하나도 없었습니다.
Deception은 모델의 output만 보는 사람에게서는 숨을 수 있을지도 모릅니다.
하지만 모델 자신의 circuitry에게서 숨을 이유는 없습니다.
그 deception은 자기 circuitry의 reader들이 접근할 수 있어야 합니다.
그리고 우리가 그 reader가 된다면, 우리에게도 접근 가능해야 합니다.
제가 두려워하는 것은 deception이 바로 눈앞에 있는데도 우리가 그것을 읽는 방법을 모르는 상황입니다.
시간이 지나면서 individual mechanism을 다루는 제 접근은 이런 종류의 proof에 덜 집중하고, 더 holistic해졌습니다.
Neuron 하나의 모든 detail을 완벽하게 고정하려 하기보다 그 주변을 봅니다.
- 무엇이 그 Neuron으로 흘러 들어오는가
- 그 Neuron은 어디로 보내는가
- Attention은 정보를 그 Neuron으로 어떻게 옮기고, 다시 어떻게 가져가는가
- zoom in했을 때와 zoom out했을 때 어떻게 보이는가
제가 automated interpretability를 연구할 때는, 어떤 Neuron이 자기 main topic에서 몇 token 떨어진 곳에서 activation하는 것조차 큰 문제처럼 보였습니다.
하지만 시간이 지나면서 분명해진 것은, Attention이 정보를 신뢰할 수 있는 특정 위치로 옮기고, 그곳에 있는 Neuron이 “적절한 token” 바로 위가 아니라 그 근처에서 activation하는 경우가 있다는 것이었습니다.
제가 느껴온 “이해한다”는 감각은 이런 식이었습니다.
각 component마다 기준을 하나씩 통과시키는 것이라기보다는, fog-of-war map이 여러 scale에서 동시에 조금씩 채워지는 것에 더 가깝습니다.
Attribution graph가 Neuron을 설명하고, Neuron이 Attention을 설명하고, 다시 Attention이 Neuron을 설명합니다.
Neural Network는 training 중 거의 stuck되지 않습니다.
High-dimensional space에서는 거의 항상 loss가 내려가는 방향이 있기 때문입니다.
제 경험상 fog of war를 걷어내는 과정도 비슷합니다.
항상 할 수 있는 다음 experiment가 있습니다.
더 좁힐 수 있는 explanation이 있고, 확인할 attribution graph가 있고, training 동안 성장하는 모습을 볼 또 다른 Neuron이 있습니다.
그래서 저는 어떤 abstraction level에서든 이해가 완전히 깨지는 지점이 존재하는지에 집중해왔습니다.
즉 더 이상 아무것도 배울 수 없어서, Network를 완전히 다른 무언가로 해체해야만 하는 지점이 있는지를 본 겁니다.
저는 아직 그런 지점을 찾지 못했습니다.
그리고 새로운 motif 하나가 여러 곳의 fog를 동시에 걷어낸다면, Neuron 하나만 완벽하게 다듬는 데 시간을 쓰는 것이 최선은 아닐 겁니다.
여기에는 약간의 faith가 있습니다.
이상한 것을 하나 발견해두면, 시간이 지나면서 보통 그 주변이 채워집니다.
물론 이게 끝없는 faith만으로 이루어진 것은 아닙니다.
거의 모든 explanation은 결국 test할 수 있습니다.
필요한 faith는 단지 **“이상한 것은 좋은 pointer일 가능성이 있다”**는 정도입니다.
Car and cat Neuron에서의 V는 사실 보기 어렵지 않습니다.
저는 약 5초 만에 봤고, 제가 image grid를 보여주면서 “여기 공통 pattern이 뭐냐”고 물어본 대부분의 사람도 봅니다.
하지만 그것을 보려면 Neuron이 실제로 뭔가 진짜를 발견했을 것이라고 믿고 들여다봐야 했습니다.
몇 년 동안 저는 polysemanticity discussion이 나올 때마다 거의 항상 이 Neuron이 언급되는 것을 들었습니다.
그리고 거의 항상, Neural Network가 direct natural science의 대상으로는 거의 부적절하다는 식으로 설명되었습니다.
저 역시 그렇게 말했습니다.
더 자세히 보기 전까지는요.
많은 faith가 필요했던 건 아닙니다.
하지만 조금은 필요했습니다.
그 작은 faith가 중요한 이유는 mistake가 symmetric하지 않기 때문입니다.
Network가 clean하다고 가정했는데 그 가정이 틀렸다면, messy Neuron은 하나의 lead가 됩니다.
그걸 조사하고, 시간이 지나면서 normal science를 통해 explanation을 더 날카롭게 만들 수 있습니다.
반대로 Network가 packed되어 있고 직접 연구할 가치가 없다고 가정했는데 그 가정이 틀렸다면, messy Neuron은 거기서 끝입니다.
그 순간 더 이상 조사하지 않기 때문입니다.
저는 몇 년 동안 두 번째 가정을 했습니다.
그리고 그 가정은 오히려 그 가정을 뒤집어줄 evidence들을 설명해 없애버렸습니다.
Tool을 개선하고, mixture들이 계속 사라지는 모습을 보면서, Neuron을 신뢰해도 된다는 prior를 쌓을 수도 있었습니다.
하지만 대신 저는 거의 10년 동안 모델을 직접 보기보다는, 모델을 어떻게 봐야 하는지를 알아내는 데 대부분의 시간을 썼습니다.
Medium ConvNeXt의 경우, 이제 map은 대부분 채워졌습니다.
8년 전의 저라면 그 정도면 그 모델에 대한 Interpretability의 꽤 괜찮은 solution이라고 불렀을 겁니다.
제가 가진 대부분의 질문을 조사할 수 있기 때문입니다.
거기에 도달하는 데에는 많은 작은 발견과 몇 가지 motif, 그리고 field가 어차피 진행한 architecture 변화들이 필요했습니다.
하지만 Interpretability를 위해 Network 자체를 특별히 고치는 작업은 전혀 필요하지 않았습니다.
제 추측으로는 현재의 frontier network는 8년 전 vision model이 있던 위치와 비슷합니다.
이미 legible하지만, 많은 작은 fix를 기다리고 있는 상태라는 겁니다.
제대로 보는 법을 배우고, noise를 따라가고, 여러 lens로 explanation을 test한다면, frontier model에서도 결국 도달할 수 있을 거라고 생각합니다.
우리에게 몇 년씩 시간이 주어지지 않을 수도 있습니다.
하지만 우리는 natural science에서 가장 좋은 laboratory를 항상 가지고 있었습니다.
모든 Neuron을 읽을 수 있고, 모든 intervention을 할 수 있고, 모든 experiment를 동일한 copy에서 다시 실행할 수 있습니다.
과거에 없었던 것은, 그 laboratory에서 우리보다 훨씬 빠르게, 훨씬 많은 수로 일해줄 automated scientist였습니다.
이제는 있습니다.
Vision Model에서 인간이 거의 10년 걸려 했던 일을, frontier Language Model에서는 이 agent들이 몇 달 안에 할 수도 있습니다.
저는 introductory textbook에 나오는 단순한 이야기가 기본적으로 옳다고 생각합니다.
Neuron은 generalize하고, 서로 함께 작동하며, Layer를 거치면서 abstraction을 만들어갑니다.
어딘가에서 우리는 이 picture를 지나치게 복잡하게 만들었습니다.
하지만 더 자세히 들여다보니 다시 그 단순한 그림으로 돌아왔습니다.
Network가 애초에 knot가 아니라면, 그것을 억지로 untangle하려는 과정이 오히려 knot처럼 보이게 만들 수 있습니다.
- Map이 있어도 과학적 검증은 필요함.
큰 구조를 봤다고 끝이 아니라, 가설을 세우고 attribution, ablation, activation 사례 등으로 계속 깨보면서 살아남는 설명을 남겨야 한다는 것. - 인간의 category를 억지로 씌우거나 Network를 너무 잘게 쪼개면 오히려 왜곡될 수 있음.
대표적으로 cat/car neuron을 인간 기준으로 보면 두 의미가 섞인 것 같지만, 실제로는 V-shape라는 하나의 mechanism이었음. SAE가 이를 cat feature, car feature로 다시 쪼개면 오히려 원래 Neuron의 organization에서 멀어질 수 있다는 주장. - 그래서 Probe나 SAE 같은 higher-level tool은 출발점보다는 후반 도구로 보는 편이 좋다고 함.
특히 Probe는 우리가 이미 던진 질문에만 답하므로, “무슨 질문을 해야 하는지”를 발견해주지는 못함. - 저자가 걱정하는 safety 문제도 비슷함.
deception이 어떤 숨겨진 activation 하나에 몰래 숨어 있을 가능성보다, 실제로는 circuitry 안에 대놓고 존재하는데 우리가 그 의미를 못 읽을 가능성을 더 걱정함.
모델 자기 내부에서 사용되는 정보라면 결국 다른 component가 읽을 수 있어야 하니, 우리도 그 reader가 되면 읽을 수 있을 거라는 생각. - 따라서 Neuron 하나를 완벽하게 증명하려고 하기보다 주변 관계를 함께 봐야 한다고 함.
무엇이 들어오고, 어디로 나가고, Attention이 정보를 어디로 옮기고, attribution graph에서는 어떻게 연결되는지를 함께 보면 서로가 서로를 설명함. - Interpretability는 fog-of-war를 걷어내는 과정에 가깝다고 봄.
하나의 motif를 이해하면 여러 곳이 한꺼번에 설명되고, 이상한 activation도 “오류”가 아니라 아직 모르는 구조를 가리키는 pointer로 취급하는 게 생산적이라는 것. - 여기서 저자의 중요한 bias가 나옴:
“Network가 clean하다고 가정하고 틀리는 것”보다 “Network가 packed돼 있어서 직접 볼 가치가 없다고 가정하고 틀리는 것”이 더 위험하다.
전자는 이상한 Neuron을 더 조사하게 만들지만, 후자는 거기서 연구를 멈추게 만들기 때문. - Medium ConvNeXt에서는 저자가 보기엔 이미 map이 대부분 채워졌고, Network를 interpretability용으로 특별히 수정하지 않아도 충분히 많은 질문을 조사할 수 있게 됐다고 봄.
- Frontier LM도 지금은 8년 전 Vision Model 같은 상태일 수 있다고 추측함.
본질적으로 읽을 수 없는 게 아니라, tool과 motif가 아직 덜 발견된 상태일 수 있다는 것. Automated agent들이 이 탐색을 빠르게 해줄 거라고 기대함.
Neuron은 generalize하고, 서로 협력하고, Layer를 거치며 abstraction을 만든다는 교과서적 그림이 대체로 맞다. Network가 원래 knot가 아닌데, 우리가 억지로 untangle하려다 오히려 knot처럼 보이게 만들었을 수 있다.
What a Solution Might Look Like
우리는 보통 ambitious interpretability를 엄청나게 어려운 문제, 어쩌면 의미 있는 시간 안에 풀기에는 너무 어려운 문제라고 상상합니다.
그런데 만약 그렇지 않다면 어떨까요?
Network는 거대하지만, 어쩌면 이해될 준비를 거의 다 스스로 해놓았을 수도 있습니다. 우리를 위해서가 아니라, 자기 내부의 reader들을 위해서요.
우리가 또 하나의 reader가 될 수 있다면, Network는 우리에게도 이미 읽힐 준비가 되어 있을 수 있습니다.
해결책은 아마 automated scientist들이 training과 inference 동안 Network를 계속 관찰하는 laboratory 같은 모습일 수 있습니다.
각 단계 자체는 단순합니다.
- Neuron에 label을 붙이고
- motif를 찾고 test하고
- data가 Circuit을 따라 어떻게 흐르는지 추적하는 것
이런 조각들은 이미 존재합니다.
강력한 agent들은 다른 일을 위해 만들어졌고, modern architecture는 잘 학습되기 때문에 선택되었습니다.
그런데 우연히도 이 둘 모두 interpretability에도 도움이 됩니다.
그러니까 어쩌면 우리가 해야 할 일은 그냥 이 둘을 서로 연결하는 것일지도 모릅니다.
Alignment도 어렵다고 여겨집니다. 실제로 그럴 수도 있습니다.
하지만 일반적인 논의는 대개 우리가 모델 내부를 볼 수 없다는 가정 위에 서 있습니다.
우리는 training setup을 한 번 정하면, 그것이 처음부터 맞아야 한다고 가정합니다.
하지만 우리가 system 내부를 읽고 이해할 수 있다면, 대신 작고 신중한 수정을 반복적으로 할 수도 있습니다.
예를 들어 어떤 RL environment가 실제로 toxic하다는 걸 발견하면, 우리가 모델을 보는 데 사용하는 tool 자체에 gradient를 흘려서 망가뜨리는 식이 아니라, 그냥 그 environment를 제거할 수 있습니다.
각각의 fix 자체는 단순할 수도 있습니다.
단지 그런 fix가 아주 많이 필요할 뿐일 수 있습니다.
이것이 Deep Learning이 발전해온 역사였습니다.
그리고 어쩌면 Deep Learning이 만들어낸 것을 이해하고 align해가는 역사도 비슷할지 모릅니다.
Alignment도 마찬가지로, 처음부터 완벽한 training objective 하나를 설계해야 하는 게 아니라,
모델 내부를 읽을 수 있다면 → 문제를 발견하고 → 작은 fix를 하고 → 다시 검사하는 식으로 갈 수 있다
는 주장
비판.... 매우 길어서 비판은 짧게 할게요
간단하게 보려는 접근은 좋은데 결국은 돈써서 해야하는 것 같음
bottleneck을 심하게 줄였을 때 세부 Feature가 broad하게 합쳐졌다는 결과를 Superposition의 부재 쪽으로 읽는 것
480→10처럼 극단적으로 capacity를 줄이면, 모델이 세부 Feature를 여러 방향에 packing하는 대신 그냥 버리고 더 coarse한 Feature만 남기는 것도 충분히 가능한 전략 실제 결과가 보여주는 건 “이 모델은 이 조건에서 coarsening을 택했다”이지, “압박받아도 Superposition을 쓰지 않는다”까지는 아님
Weak activation 쪽도 저자의 논거가 닿는 범위가 한정적. 대부분의 activation이 0 근처에 몰려 있다는 건 아주 약한 activation 영역에 unrelated Feature를 대량으로 숨긴다는 그림에는 불리하다. 그런데 threshold를 더 높이면 오히려 표본이 급격히 sparse해진다. 50% 구간이 특별한 구간은 아닐 가능성이 높음
4점 / 5점
4점에서 1티어. 4.5 못준게 아쉬움.