
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- ing
- #삼립수박샌드 #수박샌드 #삼립신상 #삼립빵 #신상빵 #편의점신상 #편의점빵 #편의점디저트 #세븐일레븐신상 #세븐일레븐빵 #편의점간식 #신상과자리뷰 #신상리뷰 #수박맛 #수박맛빵 #수박바맛 #수박디저트 #여름간식 #여름디저트 #크림샌드 #크림카스테라 #카스테라 #빵리뷰 #간식추천 #편의점추천
- Into
- 중국AI
- GPT
- #뱅크시 #뱅크시전시 #뱅크시전시회 #뱅크시서울전시 #뱅크시스틸히어 #BANKSY #BANKSYSTILLHERE #더현대뱅크시 #더현대서울뱅크시 #더현대서울전시 #더현대전시 #더현대전시회 #더현대서울ALT1 #ALT1 #현대백화점전시 #서울전시 #서울전시회 #서울전시추천 #서울전시회추천 #서울미술전시 #서울미술관 #서울가볼만한곳 #서울실내데이트 #서울데이트 #서울데이트코스 #서울데이트추천 #여의도전시 #여의도데이트 #여의도가볼만한곳 #여의도데이트코스 #
- 영어학습법
- deekseek
- From
- 0528
- 자리의힘
- 자리
- 5형식
- TO
- \
- IS
- 김원스쿨
- be to 부정사
- put
- TO 부정사
- 딥시크
- AS
- Today
- Total
AI바라기의 인공지능
Protein : 빠른 논문 리뷰 : Protein language models trained on biophysical dynamics inform mutation effects 본문
Protein : 빠른 논문 리뷰 : Protein language models trained on biophysical dynamics inform mutation effects
AI바라기 2026. 10. 1. 19:04용어 설명 (Terminology)
- SeqDance: 진화 정보(pre-trained pLM 가중치) 없이 처음부터(from scratch) 분자 동역학(MD) 및 정규 모드 분석(NMA) 기반 biophysical dynamics 특성만을 학습한 sequence-based 단백질 언어 모델(pLM).
- ESMDance: 사전 학습된 ESM2-35M의 encoder 가중치를 완전히 동결(freeze)한 상태에서 biophysical dynamics 예측 head만을 학습시켜 진화적 정보와 동역학 정보를 결합한 모델.
- Structure Ensemble: 단백질이 하나의 고정된 3D 구조로 존재하는 것이 아니라 용액 내에서 지속적으로 요동치며 취하는 다양한 구조들의 집합(동역학적 앙상블).
- IDRs (Intrinsically Disordered Regions): 고정된 3차원 입체 구조를 갖지 않고 유연하게 형태가 변하는 비정형 단백질 영역으로, 상동 서열이 부족하거나 발산되어 서열 기반 정렬 분석이 어려운 특징을 지님.
- NMA (Normal Mode Analysis): 단백질의 평형 구조 주변에서 발생하는 조화 진동을 탄성 네트워크 모델(GNM, ANM)을 통해 계산하는 기법으로, 계산 비용이 큰 전원자 MD를 보완하는 저주파 대규모 집체 거동(collective motion) 정보를 제공함.
- RMSF (Root Mean Square Fluctuation): 앙상블 시뮬레이션 동안 각 잔기(residue)가 평균 위치로부터 얼마나 크게 흔들리는지 나타내는 유연성 지표.
- Comovement Correlation: 두 아미노산 잔기의 C-alpha 원자 간 움직임 방향 및 크기의 상관관계를 측정한 지표.
- ddG (ΔΔG): 돌연변이가 발생했을 때 단백질 접힘 자유에너지(folding free energy)의 변화량으로, 돌연변이가 단백질 안정성에 미치는 물리적 영향을 나타냄.
Purpose of the Paper
- 기존 연구의 한계 극복:
- AlphaFold2/3, ESMFold, ESM2 등 기존 state-of-the-art 단백질 딥러닝 모델은 정적 3차원 구조(static structures) 또는 **진화적 서열 정렬(MSAs, evolutionary sequence databases)**에만 의존함.
- 이로 인해 열역학적 앙상블, allostery, 단백질 유연성이 핵심인 IDRs를 설명하지 못하며, 상동 서열이 거의 없는 de novo designed protein이나 초고속 변이 바이러스 단백질에서는 zero-shot 돌연변이 효과 예측 성능이 급격히 저하됨.
- 새로운 문제 정의 및 접근:
- 고차원이고 불규칙한 분자 동역학 시뮬레이션(MD) 궤적 전체를 직접 생성하는 과도한 연산 대신, 64,000개 이상의 단백질 앙상블에서 추출한 **핵심 biophysical dynamics 통계량(잔기별 유연성 및 pairwise 동역학적 상호작용/동반 움직임)**을 pLM의 self-supervised/pre-training objective로 재정의함.
- 오직 단일 아미노산 sequence만을 입력받아 단백질의 고유 동역학적 특성과 돌연변이로 인한 앙상블 변화를 zero-shot으로 직접 예측하는 새로운 프레임워크를 제시함.
Key Contributions & Novelty
- 대규모 Biophysical Dynamics 데이터셋 구축 및 다중 태스크 학습:
- 고해상도(all-atom MD, PED, GPCRmd, mdCATH 등 7,799개)와 저해상도(IDRome 거친 입자 MD 28,058개, PDB NMA 28,546개)를 통합하여 총 64,403개 단백질 기반 dynamics 데이터셋 구축.
- 잔기 수준 4종(RMSF, SASA, 2차 구조, phi/psi/chi1 dihedral angles)과 pairwise 수준 9종 상호작용 빈도 및 comovement correlation을 통합 loss function으로 설계.
- SeqDance & ESMDance 이중 모델 아키텍처 제시:
- SeqDance: ESM2-35M과 동일한 12-layer Transformer encoder를 사용하되 바닥부터(from scratch) 학습하여, 진화 정보 없이 biophysical dynamics만으로 잔기 간 interaction 및 comovement를 self-attention map에 내재화 성공.
- ESMDance: ESM2-35M의 가중치를 고정하고 1.2M 파라미터의 prediction head만 추가 학습시켜, 방대한 진화 지식과 물리적 동역학 정보를 35M 소형 모델에서 극대화.
- Pairwise Dynamic Head 설계의 참신성:
- 서열 길이에 의존하는 interaction frequency와 길이에 독립적인 comovement correlation의 차이를 반영하기 위해, SoftMax 기반 attention map과 길이 무관 pairwise residue embedding을 결합한 특화 linear prediction head를 도입.
- 비진화 기반 Zero-shot 돌연변이 안정성 예측 패러다임 입증:
- 야생형(WT)과 돌연변이(MT) 서열의 예측 동역학 프로파일 상대 변화율(relative change)의 기하평균을 취하는 물리 기반 zero-shot 채점 방식을 고안하여, 진화 정보가 부재한 인공 설계 단백질에서 거대 pLM을 능가하는 일반화 성능 확보.
Experimental Highlights
- 실험 설정 (Benchmarks & Baselines):
- IDR 및 정적 구조 거동 평가: IDRome 1,249개 IDRs(STARLING 대조), 고해상도 규칙 단백질 404개(GNM, ANM 대조).
- 전역 형태 지표 예측: IDR 28,717개 앙상블의 Re, asphericity, Rg 및 PDB 10,000개 단량체 Rg 예측(ProSE, METL, ESM2-650M 대조).
- 돌연변이 안정성 평가: Megascale 단백질 접힘 데이터셋(412개 단백질, 52만 개 이상의 단일/이중 돌연변이 ddG), 135개 비상동 de novo 설계 단백질, ProteinGym 23개 바이러스 단백질.
- Baselines: ESM2(35M, 650M, 15B), SaProt-35M, STARLING, ESMFold, ProteinMPNN, Rosetta, FoldX.
- 주요 실험 결과 수치:
- IDR 동역학 예측: SeqDance는 IDR pairwise comovement correlation에서 median Pearson r = 0.89를 기록하여 IDR 생성 전문 모델 STARLING(200 conformations 기준 0.85) 및 ESMDance(0.83)를 능가함.
- Self-attention을 통한 물리 상호작용 학습: SeqDance는 사전 학습만으로 attention head가 IDR comovement에 대해 median Spearman r = 0.74, pairwise interaction frequency에 대해 r = 0.52를 달성하며 ESM2와 대등하거나 우수한 상호작용 포착 능력을 보임.
- IDR 전역 형태 특성(Transfer Learning): SeqDance의 480차원 embedding 기반 linear regression은 random baseline 대비 MAE 31% 감소, ESM2-650M 대비 25%, ProSE 대비 31% 감소를 달성하며 IDR 형태 예측에서 타 모델을 압도함.
- Designed Proteins 돌연변이 zero-shot ddG 예측: 상동 서열이 전혀 없는 135개 설계 단백질에서 ESMDance는 median Spearman r = 0.46을 기록하여 ESM2-35M(0.21), ESM2-15B(0.29), SaProt-35M(0.06), SeqDance(0.20)를 큰 폭으로 능가함.
- Supervised ddG 회귀 예측: ESMDance와 SeqDance 예측치를 ESM2와 결합한 다중 모델 linear regression은 median MAE 0.47 kcal/mol, median Spearman r = 0.70을 달성하여 AlphaFold 구조를 직접 입력받아 계산한 Rosetta 및 FoldX의 예측 정밀도를 앞섬.
- 바이러스 단백질 Zero-shot: 상동 서열이 희소한 23개 바이러스 단백질에서 ESMDance는 Spearman r = 0.25를 기록해 ESM2-35M(0.03)과 SaProt-35M(0.14) 대비 우수한 예측력을 보임.
Limitations and Future Work
- 전체 앙상블의 직접적 궤적 생성 부재:
- 원인 및 중요성: 계산 비용 한계로 인해 앙상블 궤적 전체를 생성하지 않고 통계적 요약값(평균, 표준편차 등)만 학습함. 이에 따라 시간에 따른 전이 경로(transition pathway)나 고차 비선형 구조 변화를 완벽히 재현하는 데 한계가 있음.
- Future Work: 거대 앙상블을 직접 샘플링할 수 있는 diffusion 모델 또는 generative time-series 구조와의 접목이 필요함.
- 전장 단백질 단위의 단순 Zero-shot Metric:
- 원인 및 중요성: 현재 zero-shot 점수는 단백질 전장 전체의 상대적 동역학 변화를 단순 평균하여 사용함. 이는 단백질 접힘 안정성(folding stability)에는 적합하지만, 활성 부위(catalytic site)나 결합 계면(binding interface)의 국소적 동역학 변화가 중요한 단백질 기능, 효소 활성, 수용체 결합 예측에는 최적화되어 있지 않음.
- Future Work: 기능적 중요 부위에 가중치를 부여하는 residue-weighted scoring 방식 도입이 요구됨.
- 정적 구조 입력의 부재 및 최대 길이 제한:
- 원인 및 중요성: 서열만을 입력으로 사용하고 최대 길이를 1,024개 잔기로 제한하여 훈련함. 규칙 단백질의 20-mode NMA 예측 등 복잡한 장거리 3차원 접촉 정보에서는 실제 3D 구조를 입력받는 물리 모델(GNM/ANM) 대비 예측력이 다소 떨어짐.
- Future Work: AlphaFold2의 Evoformer처럼 구조 및 pairwise 공간 좌표 정보를 입력 토큰이나 bias로 통합하고, 모델 크기 및 context length를 scaling-up하여 장거리 상호작용 포착력을 개선해야 함.
Overall Summary
이 논문은 정적 3D 구조나 서열 진화 정보에 치중되어 있던 기존 단백질 딥러닝의 한계를 돌파하기 위해, 64,000개 이상의 단백질에서 추출한 MD 시뮬레이션 및 NMA biophysical dynamics를 학습한 단백질 언어 모델 SeqDance와 ESMDance를 제시했습니다. 연구팀은 Transformer의 self-attention과 embedding 공간이 명시적인 3차원 좌표 없이 서열 입력만으로도 잔기 간 동적 상호작용, 유연성, 전역 형태적 특성을 정밀하게 학습할 수 있음을 입증했습니다. 특히 ESMDance는 진화적 지식과 물리적 동역학을 융합함으로써 상동 서열이 없어 기존 대형 pLM이 실패하던 de novo 설계 단백질 및 바이러스 돌연변이의 안정성 변화를 뛰어난 정확도로 zero-shot 예측하는 데 성공하여, 향후 계산 기반 단백질 설계와 변이 기능 분석에서 '단백질 동역학'이 필수 불가결한 축임을 확립했습니다.
쉬운 설명
기존의 단백질 AI(AlphaFold, ESM 등)가 단백질을 **'한 컷의 정지 사진'**이나 **'오랜 세월 축적된 족보(진화 서열)'**로만 바라보았다면, 이 논문은 단백질이 물속에서 끊임없이 춤추듯 움직이는 **'동영상 속 율동(물리적 동역학)'**을 AI에게 가르친 것과 같습니다.
덕분에 자연계에 족보가 전혀 없는 완전히 새로운 '인공 디자인 단백질'이나 족보가 제멋대로 바뀌는 '변종 바이러스'를 만났을 때도, 족보를 외운 기존 AI와 달리 **"아, 이 부위의 아미노산이 바뀌면 단백질의 춤동작(유연성과 결합 균형)이 이렇게 깨지겠구나!"**를 물리 법칙 기반으로 즉각 알아채고 돌연변이의 위험성을 훨씬 정확하게 맞힐 수 있게 되었습니다.
Abstract
Structural dynamics는 단백질 기능과 mutation effects에 있어 근본적인 요소입니다. 현재의 단백질 deep learning models는 주로 sequence 및/또는 static structure data를 바탕으로 trained되어 단백질의 dynamic한 본질을 포착하지 못하는 경우가 많습니다.
이를 해결하기 위해, 64,000개 이상의 단백질에 대한 molecular dynamics simulations 및 normal mode analyses로부터 도출된 dynamic biophysical properties를 바탕으로 trained된 두 가지 protein language models인 SeqDance와 ESMDance를 소개합니다.
두 models는 사전에 접하지 않은(unseen) ordered 및 disordered 단백질의 dynamic properties를 predict하는 데 직접 적용될 수 있습니다.
Trained from scratch로 구축된 SeqDance는 residues 간의 dynamic interaction과 comovement를 포착하는 attentions를 가지며, 해당 embeddings는 단백질 dynamics의 풍부한 representations를 encode하여 transfer learning을 통해 training tasks를 넘어선 conformational properties를 predict하는 데 추가로 활용될 수 있습니다. 또한 SeqDance가 predict한 dynamic property 변화는 단백질 folding stability에 미치는 mutation effect를 반영합니다.
ESM2(Evolutionary Scale Model II) outputs를 기반으로 구축된 ESMDance는 진화적 정보가 부족한 designed 단백질 및 viral 단백질을 대상으로 한 mutation effects의 zero-shot prediction에서 ESM2를 대폭 능가합니다.
종합적으로, SeqDance와 ESMDance는 단백질 dynamics를 language models에 통합하는 framework를 제공하여 단백질 거동과 mutation effects에 대해 보다 generalizable한 predictions를 가능하게 합니다.
Introduction / Background
단백질 deep learning models는 3D structure [예: AlphaFold, RoseTTAfold, ESMFold], 단백질 기능, stability, localization 및 interactions를 predict하는 데 상당한 진전을 이루어냈습니다. 효과적인 models를 개발하는 데 있어 핵심적인 과제는 models가 해석하고 학습할 수 있는 정보 원천을 선택하는 데 있습니다. 크게 보면, 이러한 정보는 evolutionary 정보와 biophysical 정보의 두 가지 주요 유형으로 분류될 수 있습니다.
Evolutionary 정보는 유사한 선택압에 의해 형성되어 온 여러 종에 걸친 단백질 homologous sequences로부터 도출됩니다. Homologs의 Multiple sequence alignments (MSAs)에는 보존된 모티프와 공진화 쌍(coevolutionary pairs)에 관한 정보가 포함되어 있습니다. 최근에는 대규모 단백질 sequence datasets를 바탕으로 trained된 ESM1,2, ProtTrans, ProGen과 같은 protein language models (pLMs)가 evolutionary 정보를 암묵적으로 학습하는 강력한 도구로 부상했습니다. pLMs는 evolutionary 정보의 풍부한 representations를 학습하며 다양한 tasks 전반에 걸쳐 우수한 성능을 보여, 새로운 models를 평가하는 일반적인 baselines가 되었습니다. MSAs와 pLMs는 3D structures를 predict하고, 병원성 돌연변이를 predict하며, signal peptides를 식별하고, 심지어 새로운 단백질을 generate하는 데에도 성공적으로 적용되었습니다.
그러나 evolutionary 정보의 유효성은 사용 가능한 homologous sequences의 품질과 수량에 의존합니다. 예를 들어, structure predictions의 신뢰도는 homologous sequences의 수와 상관관계를 갖습니다. 결과적으로 homologous sequences가 희소하거나 매우 다양한 intrinsically disordered regions (IDRs), designed 단백질, 빠르게 진화하는 viral 단백질, 면역 단백질, 그리고 극한미생물과 같이 연구가 미흡한 종 유래 단백질에서는 evolutionary 정보의 효과가 떨어집니다. 게다가 homologs에 나타나는 evolutionary patterns는 근본적인 원인이라기보다는 단백질 기능의 결과물에 가깝습니다 (Fig. 1A). Evolutionary 정보에 지나치게 의존하면 models가 단백질 거동을 지배하는 근본적인 원리를 학습하기보다는 상관관계 패턴에 편향(bias)될 위험이 있습니다.
주로 단백질 구조로부터 도출되는 biophysical 정보는 이러한 evolutionary 정보의 한계를 극복합니다. Biophysical 정보로부터 단백질 거동을 predict하는 것은 sequence가 structure를 결정하고, structure가 기능을 관장한다는 중심 패러다임(Fig. 1A)과 일치하며, 이를 통해 models가 전체 단백질 universe에 걸쳐 보다 광범위하게 generalize될 수 있도록 지원합니다. Biophysical 정보는 광범위한 생물학적 문제에 적용되어 왔습니다. 예를 들어, predicted structures는 mutation effects 및 functional sites를 predict하는 데 사용되었습니다. MaSIF는 단백질 표면의 biophysical 및 기하학적 features를 활용하여 단백질 interactions를 연구했습니다. PScore는 PDB 구조에서 도출된 $\pi$-interactions를 predict하도록 trained되어 상분리(phase-separating) 단백질을 식별하는 데 사용될 수 있습니다. 또한 biophysical 정보를 pLMs에 통합하려는 시도들이 이루어졌습니다. ProSE는 masked residues, static structures 내의 접촉, 그리고 구조적 유사성을 predict하도록 trained되었으며, METL은 static structures에서 도출된 biophysical properties를 predict하도록 개발되었습니다 (Fig. 1B). 구조 token 정보를 통합하는 pLMs 역시 개발되었습니다.
그러나 현재의 단백질 models는 static structures에서 얻은 biophysical 정보를 사용합니다. 이러한 구조적 snapshots에는 열역학, allostery, folding 및 dynamic interactions에 관한 중요한 정보가 결여되어 있습니다. 더욱이 static structures는 인간 프로테옴의 30% 이상을 차지하며 고유한 유연성을 활용하여 필수적인 생물학적 과정을 매개하는 IDRs의 dynamic한 특성을 설명하지 못합니다. 단백질 dynamics는 단백질 거동과 mutation effects를 이해하는 데 기본적입니다. 비록 evolutionary 정보가 단백질 dynamics의 측면들을 encode하고 있기는 하지만, 이는 homologous sequences의 품질과 수량에 의존하며 직접적으로 추출될 수 없습니다. Molecular dynamics (MD) simulations는 단백질 dynamics를 연구하는 데 일상적으로 사용되며, 시뮬레이션 시간 동안 정의된 물리적 힘을 기반으로 구조의 ensembles를 생성합니다. All-atom MD simulations는 수렴된 평형 상태에 도달하기 위해 종종 많은 계산을 필요로 합니다. Coarse-grained models는 단백질 residues를 beads로 단순화하고 특화된 force fields를 사용하여 계산 비용을 절감합니다. 아울러 normal mode analysis (NMA)는 평형 conformation 주변의 단백질 진동을 설명할 수 있으며, 저주파 modes는 대규모 운동을 포착합니다. 나아가 conformation ensembles를 generate하기 위해 deep learning models가 개발되기도 했습니다. 이러한 방법들은 단백질 dynamics 연구에 널리 사용되지만, 생성되는 data는 종종 고차원적(high-dimensional)이고 불규칙한 형태를 띱니다. 따라서 이러한 dynamic data를 단백질 deep learning models에 효과적이고 효율적으로 통합하는 것은 여전히 중요한 과제로 남아 있습니다.
본 연구에서는 dynamics data를 pLMs에 통합하기 위한 deep learning framework를 제시합니다. 64,403개 단백질의 dynamics profiles를 활용하여, 두 가지 models인 SeqDance와 ESMDance를 pretrained(즉, 특정 tasks에 적용하기 전에 유용한 정보를 학습하기 위해 대규모 일반 datasets를 대상으로 models를 train하는 것)했습니다. SeqDance는 단백질 dynamics data를 직접 기반으로 하여 trained from scratch되었으며, ESMDance는 구조적 및 진화적 정보를 암묵적으로 encode하는 ESM2 outputs를 기반으로 구축되었습니다. 우리는 이 models가 training data에 포함되지 않은 단백질에 대해서도 국소적인 dynamic properties 및 전반적인 conformational properties를 포착함을 입증했습니다. 또한 우리는 진화 기반 방법들이 일반적으로 우수한 성능을 내지 못하는 designed 단백질 및 viral 단백질을 대상으로 mutation effects의 zero-shot(추가적인 training 없이 새로운 task에 models를 직접 적용하는 것) prediction에 본 models를 적용하여 우수한 성능을 달성했습니다.
Research Note: Protein Dynamics Integration into Language Models
1. 연구 배경 및 기존 접근법의 한계
- Evolutionary Approach (ESM, ProtTrans 등):
- 원리: 대규모 Homologous sequences의 Multiple Sequence Alignment(MSA)로부터 공진화 패턴을 암묵적으로 학습.
- 한계: 상동 서열이 부족하거나 발산 속도가 빠른 타깃(Intrinsically Disordered Regions [IDRs], de novo designed proteins, viral proteins, 극한미생물)에서 신뢰도 급감. 진화적 패턴은 단백질 기능의 물리적 '원인'이 아닌 선택압의 '결과'에 불과하여 상관관계 편향이 발생함.
- Static Biophysical Approach (AlphaFold, ProSE, METL 등):
- 원리: PDB 등의 3D 정적 좌표를 입력/타깃으로 활용하여 구조-기능 매핑 학습.
- 한계: 단일 스냅샷 데이터로, 열역학(Thermodynamics), 알로스테리(Allostery), 접힘(Folding 경로), 동적 상호작용 정보를 담지 못함. 특히 인간 프로테옴의 30% 이상을 차지하며 유연성이 본질인 IDR의 거동 해석 불가.
2. 핵심 기술적 난제 (Data Bottleneck)
- 단백질 동역학 연구에는 Molecular Dynamics(MD) 시뮬레이션 및 Normal Mode Analysis(NMA)가 표준적으로 사용되나, 여기서 도출되는 Conformation ensemble 데이터는 차원이 매우 높고(high-dimensional), 시계열 및 구조 형태가 불규칙(irregularly shaped)함.
- 이러한 고차원 비정형 동역학 데이터를 표준 Language Model(LM) 구조의 입력/목적 함수로 효율적으로 수렴·통합시키는 방법론의 부재.
3. 제안 모델 및 프레임워크: SeqDance & ESMDance
- 데이터셋 규모: 64,403개 단백질의 MD 및 NMA 기반 Dynamics profiles를 전처리하여 사전학습(Pre-training)에 활용.
- Two-track Model Architecture:
- SeqDance: 단백질 동역학 데이터만을 바탕으로 Scratch 단계부터 완전히 새로 학습(Trained from scratch). Residue 간의 Dynamic interaction 및 Comovement를 포착하는 Attention 메커니즘을 내재화.
- ESMDance: 사전학습된 ESM2의 Representations(진화적·정적 구조 정보가 이미 압축된 임베딩) 위에 Dynamics 프로파일을 통합·학습하여 두 정보 소스를 결합.
4. 주요 성과 및 차별점
- Generalizability: 학습 데이터에 포함되지 않은 미학습(Unseen) 단백질(정형 및 비정형 단백질 포함)에 대해서도 국소적 동역학 특성 및 전역적 Conformation 특성을 정확히 추론.
- Zero-shot Mutation Effect Prediction: 진화 정보(MSA) 기반 모델들이 실패하기 쉬운 인공 설계 단백질(Designed proteins) 및 바이러스 단백질(Viral proteins)의 돌연변이 효과 예측에서 ESM2 대비 현격한 성능 우위 확보.
쉬운 설명 :
기존의 단백질 AI 모델들은 크게 두 가지 방법으로 단백질을 공부해 왔습니다.
- 가계도(족보) 보기 (진화 정보): 수많은 생물들의 비슷한 단백질들을 쭉 비교하면서 "이 자리는 수억 년 동안 안 바뀐 걸 보니 중요한 자리구나"라고 유추하는 방식입니다. 하지만 인간이 완전히 새롭게 인공적으로 디자인한 단백질이나, 변이가 너무 빠른 바이러스 단백질은 참고할 족보(가계도) 자체가 없어서 무용지물이 됩니다.
- 사진 한 장 보기 (정적 구조): 단백질의 멈춰 있는 3D 사진을 보고 기능을 유추하는 방식입니다. 하지만 단백질은 가만히 멈춰 있는 조각상이 아니라, 계속 춤추듯 꿈틀거리고 접히며 움직이는 기계에 가깝습니다. 사진 한 장만 봐서는 이 단백질이 어떻게 움직이고 다른 물질과 부딪힐지 알 수 없습니다.
이 연구가 해결한 핵심: 연구진은 단백질의 멈춘 사진 대신 컴퓨터 시뮬레이션으로 계산한 약 6만 4천 개의 단백질 움직임 영상(동역학 데이터)을 AI에게 직접 학습시켰습니다.
이렇게 탄생한 SeqDance와 ESMDance는 단백질 아미노산 서열만 보고도 "이 부분이 어떻게 흔들리고 움직일지"를 예측할 수 있습니다. 그 결과, 참고할 족보가 전혀 없는 완전히 새로운 인공 설계 단백질이나 신종 바이러스 단백질에서도 돌연변이가 생겼을 때 어떤 일이 일어날지를 기존 최고 수준의 모델(ESM2)보다 훨씬 정확하게 맞혀냅니다.
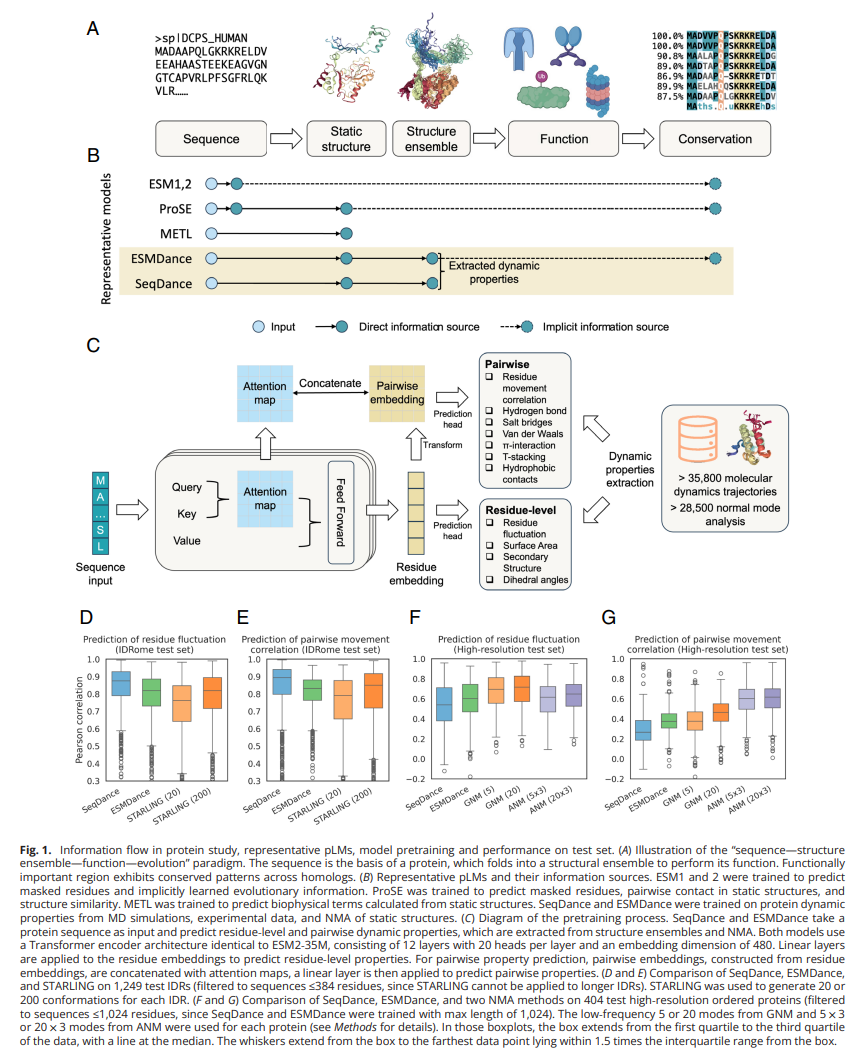
A. 단백질 연구의 정보 흐름 패러다임 (Information Flow Paradigm)
- Sequence $\rightarrow$ Static structure $\rightarrow$ Structure ensemble $\rightarrow$ Function $\rightarrow$ Conservation으로 이어지는 생물학적 인과 흐름을 보여줍니다.
- 1차 아미노산 sequence가 접혀 정적인 3차원 구조(static structure)를 거쳐 유연하게 요동치는 구조 앙상블(structure ensemble, 동역학)을 형성하며, 이 동적 상태가 biological function을 수행하고, 기능적으로 중요한 부위가 상동체 서열 간에 보존(conservation) 패턴으로 남게 됨을 설명합니다.
B. 대표적 단백질 언어 모델(pLMs)의 정보 원천 비교 (Representative Models and Information Sources)
- ESM1, 2: Sequence 상의 masked residues를 예측하도록 학습되어, 상동 서열의 진화적 보존 정보(conservation)를 암묵적으로(implicit) 습득합니다.
- ProSE: Sequence로부터 static structure의 pairwise contact 및 유사도 정보와 conservation 정보를 결합하여 학습합니다.
- METL: Static structure로부터 계산된 biophysical properties를 예측하도록 학습합니다.
- ESMDance: ESM2의 outputs(진화적 및 정적 구조 정보)를 기반으로, MD simulations 및 NMA로부터 추출된 dynamic properties를 결합하여 학습합니다.
- SeqDance: 외부 사전학습 모델의 도움 없이 sequence로부터 직접 추출된 dynamic properties를 scratch 단계부터 end-to-end로 학습합니다.
C. 모델 사전학습 구조 및 프로세스 (Pretraining Architecture)
- 입력 및 Backbone: 단백질 sequence를 입력받아 ESM2-35M과 동일한 Transformer encoder 구조(12 layers, 레이어당 20 heads, embedding dimension 480)를 통해 처리합니다.
- Residue-level 예측: 인코더를 통과한 residue embedding에 Linear layer 기반 prediction head를 연결하여 각 잔기의 Residue fluctuation(유연성/변동 폭), Surface Area(표면적), Secondary Structure(이차 구조), Dihedral angles(이면각)을 예측합니다.
- Pairwise 예측: Residue embedding을 변환한 pairwise embedding과 attention map을 Concatenate한 후, Linear layer를 통해 Residue movement correlation(잔기 간 상관 운동), 수소 결합(Hydrogen bond), 염다리(Salt bridges), Van der Waals 접촉, $\pi$-interaction, T-stacking, 소수성 접촉(Hydrophobic contacts)을 예측합니다.
- Supervision 데이터 원천: 35,800개 이상의 molecular dynamics(MD) trajectories와 28,500개 이상의 normal mode analysis(NMA)로부터 도출된 대규모 고차원 동역학 데이터가 레이블로 사용됩니다.
D & E. 비정형 단백질(IDRs) 테스트 세트 성능 (IDRome Test Set)
- 구조가 고정되지 않은 1,249개의 IDRs(길이 $\le$ 384 residues)를 대상으로 conformation ensemble 생성 모델인 STARLING(20개 및 200개 앙상블 생성)과 예측 상관계수(Pearson correlation)를 비교한 결과입니다.
- D (Residue fluctuation): SeqDance와 ESMDance는 STARLING과 대등하거나 더 우수한 상관관계를 보여 잔기 단위의 유연성을 정밀하게 포착합니다.
- E (Pairwise movement correlation): 잔기 간 동적 협동 운동 예측에서는 SeqDance와 ESMDance 모두 STARLING을 유의미하게 상회하는 성능을 기록합니다.
F & G. 정형 단백질 테스트 세트 성능 (High-Resolution Test Set)
- 404개의 고해상도 정형 단백질(길이 $\le$ 1,024 residues)을 대상으로 고전적인 물리 기반 분석 기법인 GNM(5, 20 modes) 및 ANM(5 $\times$ 3, 20 $\times$ 3 modes)과 성능을 비교한 결과입니다.
- F (Residue fluctuation): 정형 단백질의 잔기별 진동 폭 예측에서 물리 기반 NMA 모델들과 거의 동등한 수준의 높은 Pearson correlation을 달성합니다.
- G (Pairwise movement correlation): 3차원 정밀 좌표 전체를 물리 계산에 입력하는 ANM 대비로는 다소 낮으나, 3D 구조 좌표 없이 오직 아미노산 sequence만을 입력받아 고속으로 comovement 패턴을 추론해 낸다는 점에서 실용적 경쟁력을 보여줍니다.
Results
Pretraining pLMs on Dynamics Properties of over 64,000 Proteins.
단백질 dynamics dataset을 구축하기 위해, 우리는 high-resolution 및 low-resolution data sources를 모두 수집했습니다. High-resolution data에는 mdCATH, ATLAS, GPCRmd, PED로부터 얻은 experimental data 및 all-atom MD simulation trajectories가 포함됩니다. High-resolution data가 제한적이기 때문에, 우리는 IDRome의 인간 IDRs에 대한 coarse-grained MD trajectories와 PDB의 대표 구조들에 대한 NMA[Gaussian Network Model(GNM) 및 Anisotropic Network Model(ANM) 사용]를 포함한 low-resolution dynamics data를 추가로 활용했습니다. 종합적으로 우리는 ordered domains, IDRs, 막단백질, 항체 및 단백질 복합체를 아우르는 7,799개의 high-resolution data와 56,604개의 low-resolution data를 수집했습니다(자세한 내용은 Table 1 및 SI Appendix, Supplementary Methods 참조).
우리는 structure ensembles 내 특성들의 분포를 설명하는 residue-level 및 pairwise dynamic properties를 추출했습니다(Fig. 1C 및 SI Appendix, Table S1). Residue-level properties에는 정규화된 RMS fluctuation(RMSF), solvent-accessible surface area(SASA), 8개 클래스 secondary structures, 그리고 단백질 backbone과 side chains의 결합 회전을 나타내는 dihedral angles($\phi$, $\psi$, $\chi_1$)가 포함됩니다. Pairwise properties에는 $C_\alpha$ 운동의 상관관계와 수소 결합, 염다리(salt bridges), Pi-cation, Pi-stacking, T-stacking, 소수성 상호작용 및 반데르발스 상호작용의 빈도가 포함됩니다. NMA data의 경우, 각 구조의 normal modes를 주파수 기반의 3개 clusters로 분류했습니다. 각 cluster에 대해 residue fluctuation과 pairwise movement correlation을 계산했습니다(자세한 내용은 SI Appendix, Table S1 및 Supplementary Methods 참조).
우리는 SeqDance와 ESMDance라는 두 가지 models를 개발했으며, 두 model 모두 Transformer encoders와 dynamic property prediction heads(task-specific output layers)로 구성됩니다. 두 models는 단백질 sequence만을 유일한 입력값으로 받아 encoder의 final layer embeddings와 attention maps를 사용하여 residue-level 및 pairwise dynamic properties를 predict합니다(Fig. 1C). Transformer encoder는 ESM2-35M(3,500만 parameters)과 동일한 architecture를 따르며 12 layers와 layer당 20 heads로 구성되고, dynamic property prediction heads는 총 120만 개의 trainable parameters를 포함합니다. 두 models 간의 핵심적인 차이는 초기화 방식과 사전 지식의 활용 여부에 있습니다. SeqDance에서는 모든 parameters가 무작위로 초기화(randomly initialized)되어 model이 dynamic properties를 scratch 단계부터 학습할 수 있도록 했습니다. 반면 ESMDance는 ESM2-35M의 모든 parameters를 유지하고 동결(freeze)하여, ESM2에 이미 encode되어 있는 evolutionary information을 활용해 dynamic properties를 predict할 수 있도록 했습니다(자세한 내용은 Methods 참조).
서로 다른 data sources에서 비롯된 다양한 properties의 기여도를 균형 있게 맞추기 위해, loss function에서 각 가중치를 조정했습니다(자세한 내용은 Methods 참조). 우리는 50% sequence identity cutoff(ESM2 training과 동일)를 사용하여 sequences를 clustering한 후, clusters의 95%를 training set으로 무작위 선택하고 나머지 5%를 test set으로 남겨두었습니다(hyperparameter tuning을 수행하지 않았으므로 validation set은 사용하지 않음; Methods 참조). Training 및 test losses는 SI Appendix, Fig. S1에 제시되어 있습니다. SeqDance와 ESMDance는 전반적으로 대등한 test losses를 달성했으며, SeqDance는 IDRome test set과 NMA test set에서 더 우수한 성능을 보인 반면, ESMDance는 high-resolution test set에서 더 우수한 성능을 보였습니다. Pretraining 후, 두 models 모두에서 MD simulations의 comovement를 predict하는 데 사용된 linear layers의 weights와 NMA의 comovement에 사용된 linear layers의 weights 사이에 강한 상관관계가 관찰되었습니다(SI Appendix, Fig. S2). 이 결과는 NMA가 MD simulations에서 관찰되는 것과 유사한 dynamic motions를 효과적으로 포착함을 확인시켜 주며, model pretraining을 강화하기 위한 상호보완적 원천으로서의 활용을 지지합니다.
SeqDance와 ESMDance의 직접적인 유용성을 평가하기 위해, 우리는 test IDRome 및 high-resolution datasets에서 두 models를 평가했습니다. IDRs에 대한 성능은 IDR conformation generative model인 STARLING과 비교했고, high-resolution dataset에 대한 성능은 두 가지 NMA 방법인 GNM 및 ANM과 비교했습니다. 우리는 STARLING이 생성한 ensemble과 normal modes로부터 직접 계산될 수 있는 residue fluctuation 및 pairwise movement correlation[CASP 권장사항에 따라 5개 이상의 아미노산 이상 떨어진 residue pairs만 고려]에 초점을 맞추었습니다. Test IDRs에 대해 SeqDance는 residue fluctuation에서 0.87, pairwise movement correlation에서 0.89의 중간값(median) Pearson correlations를 달성했으며, ESMDance는 두 tasks에서 각각 0.82 및 0.83의 중간값 상관관계를 달성했습니다(Fig. 1 D 및 E). Baseline으로서 각 test IDR마다 STARLING을 사용하여 200개의 conformations를 generate한 후, 생성된 ensemble로부터 dynamic properties를 추출했습니다. 이 접근법은 두 tasks에서 각각 0.82 및 0.85의 중간값 상관관계를 달성하여(Fig. 1 D 및 E), ESMDance와는 대등했으나 SeqDance만큼 우수하지는 못했습니다. High-resolution ordered test 단백질의 경우, SeqDance는 residue fluctuation에서 0.54, pairwise movement correlation에서 0.27의 중간값 Pearson correlations를 달성한 반면, ESMDance는 각각 0.60 및 0.37을 달성했습니다(Fig. 1 F 및 G). Baselines로서 GNM 및 ANM(GNM은 저주파 5 또는 20 modes, ANM은 $5 \times 3$ 또는 $20 \times 3$ modes)을 사용하여 dynamic properties를 계산했습니다. ESMDance는 residue fluctuation을 predict하는 데 있어 ANM과 대등했고, pairwise correlation을 predict하는 데 있어 5개 modes의 GNM과 대등했으나, 전반적으로 ordered 단백질에 대해 20개 normal modes를 사용할 경우 SeqDance와 ESMDance 모두 GNM 및 ANM에 미치지 못했습니다(Fig. 1 F 및 G).
종합하면, 단백질 dynamic properties에 대해 trained됨으로써 SeqDance와 ESMDance는 training set과 유사하지 않은 단백질에 대해서도 residue-level 및 pairwise dynamic properties를 predict하는 데 직접 적용될 수 있습니다. 두 models는 오직 sequence만을 유일한 입력값으로 사용하여(NMA는 structure를 입력으로 사용), IDRs에 대한 residue-level 및 pairwise dynamics 모두에서 우수한 성능을 보여주었으며, ordered 단백질의 residue-level dynamics에서도 만족스러운 성능을 보여주었습니다. SeqDance는 IDRs에서 더 뛰어난 성능을 보인 반면 ESMDance는 ordered 단백질에서 더 뛰어난 성능을 보였는데, 이는 test losses에서 관찰된 경향(SI Appendix, Fig. S1)과 일치하며, evolutionary information이 ordered 단백질에 대해서는 더 유익하지만 IDRs에 대해서는 효과가 떨어진다는 사실과 부합합니다. 이어지는 내용에서 우리는 먼저 SeqDance의 attention mechanism과 embeddings를 평가한 다음, predicted dynamic properties를 단백질 stability에 미치는 mutation effect와 비교하고, mutation effects 예측에 있어 ESMDance가 ESM2 및 SeqDance 대비 갖는 이점을 검토했습니다.
SeqDance's Attentions Capture Dynamic Interactions and Comovement.
Transformer model은 다른 tokens로부터 정보를 통합하기 위해 self-attention mechanism을 채택하며, attention values는 tokens(단백질의 경우 아미노산) 간의 관계를 나타냅니다. 여기서 우리는 SeqDance의 attention mechanism이 dynamic interactions와 residue comovement를 포착하는지 평가했습니다. 이 분석은 404개의 high-resolution 단백질, 1,355개의 IDRome 단백질, 1,274개의 NMA 적용 단백질을 포함하는 test dataset을 대상으로 수행되었습니다. 추가적으로 우리는 Dynamic PDB dataset에서 추출한 29개의 MD trajectories로 구성된 독립적인 test set을 평가했습니다. 모든 test 단백질은 SeqDance training sequences와 50% 미만의 sequence identity를 공유하므로, unseen 단백질로의 generalization 능력을 평가할 수 있습니다. Dynamic PDB test set은 pretraining에 사용된 것과 다른 MD force field를 사용하여 생성되었으므로, 서로 다른 시뮬레이션 조건 전반에 걸친 SeqDance의 generalization 능력을 추가로 평가할 수 있었습니다. 모든 분석에 있어 CASP 권장사항에 따라 5개 이상의 아미노산 이상 떨어진 residue pairs만 고려되었습니다.
우리는 각 attention head의 attention values와 residue pairs의 dynamic properties(상호작용 빈도 및 운동 상관관계)를 비교했습니다. 총 240개의 attention heads 전반에 대해 Spearman correlations를 계산하고 Fig. 2에 상위 5개 heads를 강조 표시했습니다. 상호작용 빈도의 경우, SeqDance의 가장 우수한 attention heads는 high-resolution test set에서 0.41, IDRome test set에서 0.52, Dynamic PDB test set에서 0.52의 중간값 Spearman correlations를 달성했습니다(Fig. 2 A–C; 데이터마다 최적의 attention head는 다를 수 있음). MD ensemble에서 양(positive)의 운동 상관관계를 갖는 residue pairs에 대해, SeqDance는 IDRome test set에서 특히 뛰어난 성능을 보여 가장 우수한 attention head의 경우 중간값 Spearman correlation 0.74를 달성했습니다. 대조적으로 두 ordered test sets(high-resolution 및 Dynamic PDB)에 대한 최적 attention heads의 중간값 Spearman correlations는 0.22에 불과했으며(Fig. 2 D–F), 이는 Fig. 1 E 및 G의 결과와 일치합니다. SeqDance의 attention은 MD ensemble에서 음(negative)의 운동 상관관계를 갖는 residue pairs를 잘 포착하지 못했습니다(SI Appendix, Fig. S3 A–C). NMA data의 경우, 최적 attention heads는 저주파, 중주파, 고주파 modes의 양의 상관관계 pairs에 대해 각각 0.34, 0.29, 0.22의 중간값 Spearman correlations를 달성했고(Fig. 2 G–I), 세 가지 주파수 modes의 음의 상관관계 pairs에 대해서는 각각 $-0.04$, $-0.26$, $-0.35$의 Spearman correlations를 달성했습니다(SI Appendix, Fig. S3 D–F; 음의 상관관계는 이 특성을 더 잘 포착함을 의미).
ESMDance는 ESM의 parameters를 동결한 상태로 trained되어 동일한 attentions를 공유하므로, 우리는 ESM2-35M을 추가로 평가했습니다. Test 단백질들은 SeqDance의 training data와는 상이하지만, ESM2 training data에 직접 나타나거나 homologs를 가지고 있다는 점에 주목해야 합니다. 이전 연구들에서는 ESM의 attention heads가 evolutionary information을 학습함으로써 PDB structures에서 관찰되는 native interactions와 MD simulations에서 관찰되는 nonnative interactions를 모두 포착함을 보여주었습니다. 모든 평가 전반에 걸쳐 ESM2-35M과 SeqDance는 대등한 성능을 보였습니다(Fig. 2 및 SI Appendix, Fig. S3). SeqDance는 4가지 평가(상호작용 빈도, MD ensemble 내 음의 상관관계 pairs, NMA 내 양의 상관관계 및 음의 상관관계 pairs 모두)에서 약간 더 우수한 성능을 보였고, ESM2-35M은 1가지 평가(MD ensemble 내 양의 상관관계 pairs)에서 약간 더 우수한 성능을 보였습니다. 전반적으로 이러한 결과는 우리의 pretraining strategy를 통해 SeqDance의 attention이 sequence로부터 직접 dynamic interactions 및 residue comovement를 포착할 수 있게 되었으며, unseen 단백질 및 서로 다른 시뮬레이션 조건에서도 ESM2와 대등한 성능을 발휘함을 입증합니다. Dynamic properties를 포착하는 ESM2의 능력 덕분에 우리는 훨씬 적은 수의 trainable parameters를 사용하면서도 SeqDance와 대등한 test loss를 달성하는 ESMDance를 train할 수 있었습니다(SI Appendix, Fig. S1).
SeqDance's Embeddings Encode Global Protein Conformation Properties.
다음으로 SeqDance의 generalization 능력을 평가하기 위해, SeqDance가 pretraining tasks에 포함되지 않은 단백질 conformational properties를 학습하는지 조사했습니다. 구체적으로 우리는 운동 범위, 구형으로부터의 벗어남, 조밀도(compactness)를 각각 정량화하는 end-to-end distance($R_e$), asphericity, radius of gyration($R_g$)을 고려했습니다. 이러한 properties는 model로부터 직접 얻을 수 없기 때문에, 우리는 지도학습(supervised manner) 방식으로 embeddings를 사용하여 linear regression models를 trained했습니다. Fig. 1B에 제시된 다른 pLMs와의 공정한 비교를 위해(ESMDance embedding은 ESM2-35M과 동일함), 각 방법의 mean-pooled embeddings에 주성분 분석(PCA)을 적용하고 상위 200개 성분을 linear regression의 입력으로 사용했습니다.
우리는 먼저 SeqDance training set과 비교하여 서로 다른 coarse-grained force field를 사용하여 생성된 IDRs의 structure ensembles를 대상으로 이러한 pLMs를 평가했습니다. SeqDance training sequence와 20%를 초과하는 sequence identity 및 50% 초과의 coverage를 갖는 IDRs를 제거한 후 28,717개의 IDRs가 남았습니다(자세한 내용은 Methods 참조). 우리는 ensemble 내의 평균 $R_e$, asphericity, $R_g$를 사용했습니다($R_g$와 $R_e$의 고유한 길이 의존성을 보정한 방법에 대해서는 Methods 참조). 정보 누출(information leakage)을 방지하기 위해 20% sequence identity cutoff를 사용하여 training set과 test set을 $6:4$ 비율로 분할했습니다. 각 pLM에 대해 linear regression model을 trained했으며 실험은 20회 반복되었습니다. SeqDance는 pretraining 이전의 무작위 초기화 model 및 다른 pLMs를 크게 능가하여(Fig. 3 A–C), random model, ESM2-650M, METL, ProSE의 MAEs(mean absolute errors)를 평균적으로 각각 31%, 25%, 29%, 31% 감소시켰습니다.
Ordered 단백질의 경우, MD simulations의 계산 비용으로 인해 structure ensembles로부터 conformational properties를 얻는 데 어려움이 있습니다. 따라서 우리는 해당 논문의 PDB 데이터베이스에 수록된 10,000개 이상의 static monomer structures에서 얻은 $R_g$를 사용했습니다(자세한 내용은 Methods 참조). SeqDance는 거의 모든 대표적인 PDB 구조의 NMA를 바탕으로 trained되었기 때문에, SeqDance training set에 homologs가 있는 sequences를 제외하지 않았습니다. 위에서 설명한 것과 동일한 평가 방법을 사용하여 SeqDance는 random model, ProSE, METL을 능가했으며 ESM2와 대등한 성능을 보였습니다(Fig. 3D).
우리는 Pearson correlation을 사용하여 성능을 추가로 평가했으며 유사한 결과를 확인했습니다(SI Appendix, Fig. S4 A–D). 특히 첫 200개의 주성분 대신 full embeddings를 사용하는 경우에도, SeqDance는 가장 짧은 embedding 크기를 가졌음에도 대부분의 tasks에서 다른 pLMs를 여전히 능가했습니다(SI Appendix, Table S2). Fig. 3 E–H는 한 번의 실험에서 test 단백질들을 대상으로 full SeqDance embeddings를 사용한 linear model의 predictions를 보여줍니다. SeqDance를 통해 IDRs의 MD simulations 및 ordered 단백질의 PDB structures에서 관찰되는 conformational properties를 정확하게 predict할 수 있었습니다. 우리는 나아가 IDRs에 대해서는 STARLING과, ordered 단백질에 대해서는 ESMFold(30억 parameters)와 SeqDance를 비교했습니다. STARLING과 ESMFold 모두 우리의 평가에 사용된 것과 동일한 datasets로 trained되었으므로, test 단백질의 상당 부분이 이들의 training sets에 포함되어 있었다는 점에 유의해야 합니다. IDRs의 경우 SeqDance는 20개의 conformations를 generate하는 STARLING보다 우수했으나, 200개의 conformations를 generate하는 STARLING보다는 성능이 낮았습니다(Fig. 3 E–G 및 SI Appendix, Fig. S4 E–G). Ordered 단백질의 경우 SeqDance embeddings와 ESMFold는 대등한 성능을 산출했습니다(Fig. 3H 및 SI Appendix, Fig. S4H). 따라서 SeqDance는 structure 및 ensemble 기반 방법들과 대등한 성능을 달성하면서도 수주(orders of magnitude) 이상 빠르게 작동하여 단백질 conformational properties를 predict하기 위한 효율적인 대안을 제공합니다.
SeqDance Predicted Dynamic Property Changes Reflect Mutation Effect on Protein Stability.
SeqDance가 단백질 folding의 biophysics에 관한 정보를 포착하는지 평가하기 위해, 우리는 그 output을 단백질 folding stability에 미치는 mutation effects와 비교했습니다. 우리는 안정성을 저해하는(destabilizing) mutations는 단백질 dynamics에 유의미한 변화를 유도하는 반면, 영향이 미미한 mutations는 더 작은 dynamic 변화를 유도할 것이라는 가설을 세웠습니다. 이 가설을 검증하기 위해 SeqDance를 사용하여 wild-type 및 mutated sequences 모두에 대한 dynamic properties를 predict하고, 이들의 상대적 변화를 계산한 후 실험적으로 측정된 $\Delta\Delta G$ 값과 비교했습니다(Fig. 4A, 자세한 내용은 Methods 참조). 이 model은 mutation data에 대해 구체적으로 trained되지 않았으므로, 이 접근법은 zero-shot prediction으로 구성되었습니다. 우리는 천연 단백질과 designed 단백질을 모두 포함하는 412개 단백질에 걸친 379,865개의 single mutations 및 147,926개의 double mutations에 대한 $\Delta\Delta G$ 값을 포함하는 megascale protein folding stability dataset에 이 접근법을 적용했습니다.
개별 dynamic properties의 zero-shot 예측 성능을 평가하기 위해, 각 단백질의 mutations에 대한 각 property의 상대적 변화와 해당하는 $\Delta\Delta G$ 값 사이의 Spearman correlation을 계산했습니다. Pretraining 이전의 무작위 초기화 model은 전혀 예측 능력을 보여주지 못한 반면, SeqDance가 predict한 수많은 properties는 0.2 이상의 중간값 Spearman correlations를 달성하여(Fig. 4B 및 SI Appendix, Fig. S5), pretraining을 통해 SeqDance가 유의미한 biophysical dynamics를 포착할 수 있게 되었음을 확인해 주었습니다. 개별 properties 중에서는 SASA mean이 최고 성능을 보이는 properties 중 하나로 나타났는데, 이는 destabilizing mutations가 코어 패킹을 방해하고 용매 노출을 증가시킨다는 사실과 일치합니다. Dihedral angles $\phi$와 $\psi$ 역시 상위에 랭크되어 단백질 stability에서 backbone conformational flexibility의 역할을 부각했습니다. 또한 MD simulations 및 NMA로부터 도출된 pairwise movement correlations는 비교적 높은 성능을 보여주어 mutation effects 예측에서 집단 동역학(collective dynamics)의 중요성을 더욱 강조했습니다.
이러한 dynamic properties를 통합하기 위해, 우리는 분위수 정규화된(quantile-normalized) 상대적 변화들의 기하평균을 사용했습니다(자세한 내용은 SI Appendix, Table S3 및 Methods 참조). 통합 점수는 412개 단백질 전체에 걸쳐 0.24의 중간값 Spearman correlation을 산출했습니다.
SeqDance의 성능이 training set 내 homologs의 존재 여부에 의존하는지 평가하기 위해, 우리는 먼저 training set에서 가장 유사한 단백질과 비교한 성능을 분석했습니다. SeqDance는 training set에 sequence identity 95% 이상의 근접한 homologs가 있는 단백질에서 더 나은 성능을 보였습니다(Fig. 4C). 이러한 근접한 homologs를 가진 125개 단백질의 경우 중간값 Spearman correlation이 0.29인 반면, training set에 homologs가 없는 191개 단백질의 경우 중간값 상관관계는 0.20이었습니다. 20%에서 95%의 sequence identity를 갖는 homologs를 포함한 단백질들은 homologs가 없는 단백질들과 유사한 성능을 보였습니다. 우리는 또한 homologs의 수(20% 초과의 sequence identity 및 50% 초과의 coverage로 정의)의 함수로서 SeqDance의 성능을 조사했으며 경미한 상관관계만을 관찰했습니다(Fig. 4D).
나아가 우리는 evolutionary information을 기반으로 20개 아미노산의 확률을 추정하여 mutation effects의 zero-shot prediction을 수행할 수 있는 ESM2와 SeqDance를 비교했습니다. ESM2-35M은 0.33의 중간값 Spearman correlation을 달성하여 SeqDance를 능가했습니다. 이는 evolutionary information이 mutation effects를 predict하는 데 매우 효과적이라는 사실과 일치합니다. 그러나 ESM2의 성능은 training set인 UniRef50 내의 homologs 수에 크게 의존하며, 특히 100개 이상의 homologs를 가진 단백질에서 두드러졌습니다(Fig. 4E; SI Appendix, Fig. S6 A 및 B의 ESM2-650M 및 -15B). Homolog 풍부도의 영향을 분리하기 위해, UniRef50과 SeqDance training set 모두에서 유사한 수의 homologs(0개에서 146개 사이)를 갖는 257개 단백질의 subset을 평가했습니다. 이 subset에서 ESM2-35M은 0.22의 중간값 Spearman correlation을 달성하여 SeqDance의 성능인 0.24와 대등했습니다(SI Appendix, Fig. S6C). 이러한 결과는 model size와 training data 풍부도가 유사할 경우, SeqDance와 ESM2가 단백질 stability에 미치는 mutation effect를 predict하는 데 있어 유사한 성능을 냄을 시사합니다. 전반적으로 오직 wild-type sequences만을 대상으로 pretrained되고 evolutionary information에 의존하지 않았음에도 불구하고, SeqDance는 training set에 homologs가 없는 단백질에 대해서도 단백질 stability에 미치는 mutation effect에 관해 유의미한 predictions를 생성할 수 있습니다.
ESMDance Enhances Prediction of Mutation Effect on Protein Stability.
Evolutionary information을 활용하는 ESM2-35M과 단백질 dynamic properties를 포착하는 SeqDance 모두 단백질 stability에 미치는 mutation effect를 predict할 수 있지만, 3,500만 parameters라는 model size에서 개별적인 성능은 여전히 보통 수준에 머물러 있습니다. 두 접근법의 강점을 결합하기 위해, 우리는 진화적 정보와 동역학 정보를 통합하는 3,500만 parameters 크기의 ESMDance를 개발했습니다. Fig. 4A에 설명된 zero-shot 접근법을 사용하여 ESMDance는 412개 단백질 전체에 걸쳐 0.46의 중간값 Spearman correlation을 달성하여(Fig. 4F), ESM2-35M(0.33)과 SeqDance(0.24)를 유의미하게 능가했습니다. 주목할 만하게도 ESMDance는 유사한 model architecture를 갖추었으나 structure tokens를 추가 입력으로 사용하는 SaProt-35M(0.45; SI Appendix, Fig. S6D)과 일치하거나 이를 능가했으며, ESM2-650M(0.46; SI Appendix, Fig. S6A) 및 ESM2-15B(0.43; SI Appendix, Fig. S6B)를 포함하여 훨씬 더 큰 language models와도 대등하거나 능가했습니다. 더욱이 ESMDance는 견고한 generalization을 입증했습니다. 해당 성능은 training set이나 UniRef50 내의 homologs 존재 여부와 무관했습니다(Fig. 4 F 및 G, SI Appendix, Fig. S6E). UniRef50에 homologs가 없는 단백질은 ESMDance training set에도 homologs가 없다는 점에 주목해야 합니다. 따라서 이러한 단백질에서 관찰된 성능 향상은 ESMDance training에 이들의 dynamic data가 존재했기 때문이 아닙니다.
이들 models의 zero-shot predictions는 $\Delta\Delta G$와 상관관계를 갖지만, 동일한 물리적 척도 상에 있지는 않습니다. 이를 $\Delta\Delta G$와 일치시키기 위해 지도학습 linear regression models를 피팅했습니다. 각 단백질에 대해 mutations의 50%를 training을 위해 무작위 추출하고 나머지 50%를 testing에 사용했습니다. SeqDance 및 ESMDance가 predict한 dynamic property changes(23개의 상대적 변화, Fig. 4B)에 대한 linear regression models는 412개 단백질의 test mutations에서 각각 0.63 및 0.54 kcal/mol의 중간값 MAEs와 0.44 및 0.58의 중간값 Spearman correlations를 달성하여(Fig. 4 H 및 I), 각각의 zero-shot 상관관계를 크게 능가했습니다. Baseline으로서 세 가지 ESM2 models(35M, 650M, 15B)의 zero-shot predictions를 사용하는 linear regression model은 중간값 MAE 0.56 kcal/mol을 달성하여, SeqDance보다는 우수했으나 ESMDance보다는 낮았습니다(Fig. 4 H 및 I). 우리는 여러 방법들의 predictions를 입력값으로 사용하는 regression models를 추가로 trained했습니다. ESM2에 SaProt-35M predictions를 추가하면 MAE가 0.53 kcal/mol로 감소한 반면, SeqDance 또는 ESMDance predictions를 추가하면 더 큰 개선이 나타났습니다. ESM2 + SeqDance는 0.52 kcal/mol에 도달했고, ESM2 + ESMDance는 0.48 kcal/mol에 도달했으며, ESM2, SeqDance, ESMDance를 모두 결합했을 때 중간값 MAE 0.47 kcal/mol 및 중간값 Spearman correlation 0.70으로 최고의 성능을 달성했습니다(Fig. 4 H 및 I).
전반적으로 이러한 결과는 ESM2가 학습한 evolutionary information을 단백질 dynamic properties와 통합함으로써 ESMDance가 단백질 stability에 미치는 mutation effect를 predict하는 데 있어 탁월한 성능을 달성함을 입증합니다. 나아가 우리의 models는 진화 기반 models에 추가적인 정보를 제공하며, 이들의 결합은 훨씬 더 뛰어난 predictive power를 산출합니다.
Biophysics-Based Pretraining Improves Mutation Effect Prediction for Designed and Viral Proteins.
ESM2의 한 가지 한계점은 천연 단백질로부터 학습한 evolutionary information이 de novo designed 단백질에는 generalize되지 못할 수 있다는 점입니다. ESMDance가 이러한 한계를 해결할 수 있는지 평가하기 위해, 우리는 UniRef50과 SeqDance/ESMDance training set 모두에 homologs가 없는 135개의 designed 단백질 subset을 분석했습니다. ESM2-35M, -650M, -15B는 각각 0.21, 0.32, 0.29의 중간값 Spearman correlations를 달성했는데, 이는 이들의 평균 성능보다 유의미하게 낮은 수치입니다(Figs. 4E 및 5A, SI Appendix, Fig. S6 A 및 B). 대조적으로 ESMDance는 0.46의 중간값 Spearman correlation을 달성하여 SeqDance(0.20), SaProt-35M(0.06) 및 모든 ESM2 models를 실질적으로 능가했습니다(Fig. 5A). 개별 단백질 수준에서의 추가 분석을 통해 서로 다른 ESM2 models의 성능은 높은 상관관계를 보인다는 점이 밝혀졌습니다(Fig. 5B). 이와 달리 SeqDance와 ESMDance는 모두 ESM2와 직교하는(orthogonal) 성능 패턴을 보였으며(Fig. 5 C 및 D), ESMDance는 ESM2-35M과 비교하여 대부분의 단백질에서 상당한 개선을 나타냈습니다(Fig. 5D).
나아가 우리는 두 가지 designed 단백질에 대한 zero-shot predictions를 시각화했습니다(Fig. 5 B–D에 강조 표시됨). 첫 번째 단백질인 r10_572_TrROS_Hall(Fig. 5E)은 TrRosetta hallucination을 사용하여 설계되었습니다. SeqDance와 ESMDance 모두 ESM2 models(ESM2-35M, -650M, -15B에 대해 각각 0.18, 0.25, 0.20)와 비교하여 상당히 높은 상관관계(두 model 모두 0.52)를 달성했습니다. 두 번째 단백질인 GG|run4_0284_0002(Fig. 5F)는 EEHH 방법을 사용하여 설계되었습니다. 여기서 ESM2와 SeqDance는 모두 낮은 성능(ESM2-35M, -650M, -15B, SeqDance에 대해 각각 0.02, 0.09, $-0.02$, 0.18)을 보인 반면, ESMDance는 눈에 띄게 높은 0.53의 상관관계를 달성했습니다. Linear regression models는 두 단백질의 test mutations에 대해 유사한 결과를 보여줍니다(SI Appendix, Fig. S7). 이 결과는 model training 동안 dynamic properties와 evolutionary information을 직접 통합하여 두 model의 개별 predictions를 능가하는 ESMDance의 이점을 강조합니다.
추가적으로 우리는 기존에 확립된 몇 가지 structure-based models를 벤치마킹했습니다. 여기에는 structure로부터 sequence를 predict하고 predicted sequence likelihood가 stability에 미치는 mutation effects와 상관관계를 갖는 inverse-folding model인 ProteinMPNN과, mutation $\Delta\Delta G$ 값을 직접 추정하는 biophysics-based models인 Rosetta 및 FoldX가 포함되었습니다(자세한 내용은 Methods 참조). Buried sites의 mutations는 일반적으로 더 큰 영향을 미치는 반면 surface mutations는 더 작은 영향을 미치는 경향이 있으므로, structure를 입력값으로 사용하는 것은 본질적으로 stability prediction을 단순화한다는 점에 주목해야 합니다(Fig. 5G). 먼저 Spearman correlation을 평가했을 때, ESMDance zero-shot은 ProteinMPNN을 능가했으나 FoldX 및 Rosetta보다는 낮았으며, ESMDance linear regression은 FoldX 및 Rosetta와 대등한 성능을 보였습니다(Fig. 5H). 우리는 또한 mean absolute error(MAE)를 평가했으며, 우리의 linear regression models는 FoldX 및 Rosetta의 원시(raw) $\Delta\Delta G$ 값보다 실질적으로 낮은 MAE를 산출했습니다. Linear regression을 사용하여 FoldX 및 Rosetta의 raw $\Delta\Delta G$ 값을 실험적 측정값으로 calibration한 후, 이들의 MAE는 ESMDance linear regression model과 대등해졌으나 여전히 약간 더 높았습니다(Fig. 5H). 전반적으로 이러한 결과는 우리의 linear regression models가 수주(orders of magnitude) 이상 빠르며 오직 sequence 입력만을 요구하면서도 전통적인 biophysics-based models를 대체할 수 있는 대안으로 기능할 수 있음을 시사합니다.
Designed 단백질 외에도 우리는 급격하게 진화하며 UniProt에 데이터가 부족한 viral 단백질을 대상으로 한 성능을 조사했습니다. ProteinGYM의 deep mutational scanning 실험에서, ESM2 models와 SaProt-35M은 model size와 상관없이 다른 단백질들과 비교하여 viral 단백질에서 일관되게 더 낮은 성능을 보였습니다(SI Appendix, Fig. S8). ESM2-35M은 viral 단백질에서 0 부근의 중간값 Spearman correlation을 달성했습니다(SI Appendix, Fig. S8). 1,024 residues보다 짧고 187,902개의 mutations를 아우르는 23개의 viral 단백질에 대해, SeqDance와 ESMDance는 Fig. 4A의 zero-shot 접근법(stability를 넘어서는 mutation effects에 대해서는 최적의 전략이 아닐 수 있음, Discussion 참조)을 사용하여 각각 0.18 및 0.25의 중간값 Spearman correlations를 달성했습니다(Fig. 5 I 및 J). 이들은 ESM2-35M(0.03)과 SaProt-35M(0.14)을 능가했으나 ESM2-15B(0.36; Fig. 5I)만큼 우수하지는 못했습니다.
Research Note: Results 핵심 요약
1. 대규모 단백질 동역학 데이터셋 큐레이션 및 모델 아키텍처
- 데이터셋 파이프라인: High-resolution(7,799개: all-atom MD 궤적, PDB 실험 데이터)과 Low-resolution(56,604개: IDRome coarse-grained MD, PDB 기반 NMA)을 결합하여 총 64,403개 단백질의 동역학 프로파일 구축.
- 학습 타깃: Residue-level(RMSF, SASA, 8-class 이차 구조, 이면각 $\phi, \psi, \chi_1$) 및 Pairwise($C_\alpha$ comovement, 수소결합, 염다리, $\pi$-interaction, 반데르발스 등 비공유 결합 빈도).
- Two-track 사전학습 설계:
- SeqDance: ESM2-35M 구조(12 layers, 20 heads, dim 480)를 base로 파라미터를 무작위 초기화하여 동역학 데이터만으로 Scratch 학습.
- ESMDance: 사전학습된 ESM2-35M 백본을 완전히 동결(freeze)하고, 상단에 120만 개 파라미터 규모의 동역학 예측 헤드(prediction heads)만 학습시켜 진화 정보와 물리적 동역학 정보를 결합.
2. 동역학 예측 벤치마크 및 표상(Representation) 분석
- 서열 기반 직접 추론 능력:
- 비정형 단백질(IDRs): SeqDance는 잔기 유연성($r = 0.87$)과 상관 운동($r = 0.89$) 예측에서 구조 앙상블 생성 전문 모델인 STARLING(200개 앙상블 기준 $r = 0.82 / 0.85$)을 능가함.
- 정형 단백질: 3D 좌표 전체를 입력으로 요구하는 물리 기반 NMA(ANM/GNM) 대비, 서열만을 입력받아 대등하거나 경쟁력 있는 예측치 달성.
- Attention 및 Embedding의 전이성:
- SeqDance의 Attention heads는 서열 상동성이 50% 미만인 미학습 단백질 및 상이한 force field 환경에서도 잔기 간 상호작용 빈도와 양의 상관 운동을 정확히 포착($\rho$ 최대 0.74).
- 학습 목적 함수에 없었던 전역 입체 형태 특성(말단 간 거리 $R_e$, 비구형도 asphericity, 회전 반경 $R_g$)을 선형 프로빙(Linear probing)한 결과, SeqDance 임베딩이 ESM2-650M, METL, ProSE 대비 MAE를 25%~31% 낮추며 우수한 일반화 성능 입증.
3. 돌연변이 안정성($\Delta\Delta G$) 예측 성능
- 동역학 기반 제로샷 매커니즘: 돌연변이 발생 시 계산되는 동역학 상대 변화량(특히 코어 패킹 붕괴를 반영하는 SASA 및 주쇄 유연성을 반영하는 이면각)이 $\Delta\Delta G$와 직접 비례함을 검증.
- ESMDance의 파라미터 효율성:
- 제로샷 $\Delta\Delta G$ 예측에서 ESMDance는 412개 단백질 대상 Spearman $\rho = 0.46$을 기록하여 원본 ESM2-35M($\rho = 0.33$) 및 SeqDance($\rho = 0.24$)를 압도함.
- 이는 구조 토큰을 사용한 SaProt-35M($\rho = 0.45$)뿐만 아니라, 파라미터가 수십~수백 배 큰 ESM2-650M($\rho = 0.46$), ESM2-15B($\rho = 0.43$)와 대등하거나 상회하는 수준임.
- Supervised Calibration: 동역학 변화량을 입력으로 선형 회귀 피팅 시, ESMDance 단독으로 MAE 0.54 kcal/mol 달성. 진화 모델과 결합(ESM2 + SeqDance + ESMDance) 시 MAE 0.47 kcal/mol, Spearman $\rho = 0.70$으로 SOTA급 성능 확보.
4. 진화 정보 결핍(Designed & Viral) 도메인에서의 차별적 우위
- 인공 설계 단백질(De novo designed): 상동 서열이 없는 135개 인공 단백질에서 기존 ESM2 계열은 성능이 붕괴($\rho = 0.21 \sim 0.32$)되는 반면, ESMDance는 $\rho = 0.46$을 유지하며 완전한 직교(orthogonal) 보완성을 증명함.
- 물리 기반 전통 툴 대체: 구조 좌표를 입력받는 FoldX, Rosetta 수준의 정확도를 달성하면서도, 3D 구조 없이 오직 1차 아미노산 서열만으로 수만 배 빠른 추론 속도 제공.
- 바이러스 단백질(Viral proteins): 변이 속도가 빨라 진화 모델의 취약 지점인 ProteinGYM 바이러스 벤치마크에서, ESM2-35M($\rho \approx 0.03$) 및 SaProt-35M($\rho = 0.14$) 대비 ESMDance는 $\rho = 0.25$로 크게 앞섬.
쉬운 설명 :
1. AI 모델들의 족보 의존증을 고쳤습니다
기존의 강력한 단백질 AI(ESM2 등)는 수많은 생물들의 단백질 족보(진화 정보)를 외워서 "이 자리는 중요한 자리니까 바뀌면 위험해"라고 판단했습니다. 하지만 인간이 컴퓨터로 완전히 새롭게 창작한 인공 단백질이나, 돌연변이가 너무 빨라 족보가 엉망인 바이러스 앞에서는 힌트가 없으니 작동을 멈추거나 엉뚱한 답을 냈습니다.
2. 뼈마디가 어떻게 움직이는지(물리 법칙)를 배웠습니다
연구팀은 족보 대신, 단백질의 관절과 부품들이 실제로 어떻게 요동치고 부딪히는지 시뮬레이션한 6만 4천 개의 움직임 데이터를 AI에게 주입했습니다.
- SeqDance: 족보를 아예 안 보고 오직 단백질 서열과 움직임의 물리 법칙만 맨땅에서 학습한 모델입니다.
- ESMDance: 기존 족보 천재 모델(ESM2)의 머리는 그대로 둔 채, 물리적인 움직임 해석 레이어만 얹어서 결합한 융합 모델입니다.
3. 결과가 왜 대단한가요?
- 체급을 뛰어넘는 효율: 겨우 3,500만 개짜리 가벼운 모델인 ESMDance가, 150억 개 파라미터를 가진 거대 모델(ESM2-15B)보다 돌연변이 예측을 더 정확하게 해냈습니다.
- 족보 없는 곳에서의 독보적 성능: 족보가 전혀 없는 인공 합성 단백질을 가져왔을 때 기존 ESM2는 점수가 바닥을 쳤지만, 물리적 움직임을 이해하는 ESMDance는 정확도를 그대로 유지했습니다.
- 초고속 계산: 원래 단백질의 안정성을 물리적으로 정밀 계산하려면 거대한 3차원 입체 좌표를 넣고 슈퍼컴퓨터로 오래 돌려야(FoldX, Rosetta) 했습니다. 하지만 이 모델은 1차원 글자(서열)만 쓱 보고도 그에 맞먹는 물리적 안정성 변화를 순식간에 계산해 냅니다.
용어 설명
structure ensemble
구조는 고정된게 아니라 여러개임. 그러한 구조들의 모음이 스트럭처 앙상블인데
구조 하나를 보통 conformation 라고 도 함
IDRs (Intrinsically Disordered Regions)
단백질 안에서 하나의 안정된 3D 구조로 고정되지 않는 영역, 스트럭처 앙상블과도 연결 되는데
이게 무슨말이냐면 단백질 안에서 자유롭게 변하는 부분이 있고 잘 변하지 않는 부분이 있음.
IDR: 하나의 안정된 구조로 고정되지 않고 훨씬 크게/다양하게 conformation이 변하는 영역
Ordered region: 구조가 비교적 안정적이지만 아예 안 움직이는 건 아님
All-atom MD vs. Coarse-grained MD
All-atom MD
- 단백질의 거의 모든 atom을 하나하나 표현해서 움직임을 계산
Coarse-grained MD
- 여러 atom을 묶어서 하나의 bead 같은 단위로 단순화해서 계산
NMA (Normal Mode Analysis)
NMA (Normal Mode Analysis)는 하나의 기준 구조를 놓고,
그 구조 주변에서 단백질이 어떤 집단적인 방식으로 움직이기 쉬운지를 수학적으로 분해해서 찾는 방법
Hv 람다v가 나오는데
v가 특정 모드인셈 : 모든 원자의 displacement direction을 한 줄에 담은 벡터로 보면됨
그럼 Hv는 뭐냐
H는 어떤 변위를 줬을때 복원 힘이 어떻게 생기는지를 결정하는 행렬
평형점 근처에서는 F ~ -H 델타x
자세한건 수식 정의하면 되는데
단백질의 기준 구조 주변에서 가능한 작은 움직임을 몇 개의 대표적인 움직임 패턴(mode)으로 분해하는 방법
위에서 말한
v가 원자의 디스플레이스먼트 디렉션을 담고 있다 했으니 싸게 가능
potential energy를 좌표에 대해 두 번 미분해서 구함
:::
equilibrium structure 를 두고 포텐셜 에너지인 V(x)를 태일러 확장
\[ V(x) \approx V(x_0) + \frac12 (x-x_0)^T H (x-x_0) \]
\[ H_{ij}=\frac{\partial^2 V}{\partial x_i \partial x_j} \]
- 그다음 Hessian을 eigen decomposition 합니다.
\[ H u_k = \lambda_k u_k \]
여기서
- \(u_k\): normal mode = 움직이는 방향/패턴
- \(\lambda_k\): 그 방향으로 움직이기 얼마나 어려운지, 즉 stiffness와 관련
그래서:
\[ \lambda_k \text{ 작음} \Rightarrow \text{soft mode} \Rightarrow \text{low frequency} \Rightarrow \text{큰 collective motion} \]
반대로
\[ \lambda_k \text{ 큼} \Rightarrow \text{high frequency} \Rightarrow \text{작고 local한 vibration} \]
평형 구조
가장 안정적으로 머무르는 기준 구조 (보통 에너지 기준)
에너지
변위 제곱합. 근데 헤시안이 각 방향의 stiffness(강성), coupling(결합)을 가중한다.
displacement direction
즉 어떤 원자나 residue가 현재 위치에서 어느 방향으로 이동하려는지를 뜻함
GNM — Gaussian Network Model
일반적인 all-atom NMA에는 이런 부담이 있음
모든 atom 좌표 + 복잡한 potential energy → 큰 Hessian 계산
계산량이 좀 많은데
그래서 모든걸 안보고 amino acid residue 하나 = Cα 점 하나 를 보게됨 : 똑같은 spring으로 연결
스프링 연결은 가까우면 연결하는데 spring energy같은걸 두는데 연결된 두 residue의 상대적 변위 차이의 제곱의 강성 곱해지는걸 ..
그럼 가까운 레지듀들은 뭔가 영향을 주게됨.
스프링 네트워크로 행렬을 만듬.
어떤 residue와 어떤 residue가 연결돼 있는지
residue 하나가 주변에 몇 개와 연결되어 있는지
Cα spring network의 연결 관계를 행렬화한 Kirchhoff matrix
그래서 그 행렬을 아이겐 디컴포지션 하면
감마 u 는 람다 u
NMA와 비슷하게 mode들이 나옴
u는 레지듀마다 숫자 하나씩, 절대값이 높을수록 참여정도
ANM
도 레지듀 하나를 씨알파 하나로 표현
가까운 거리 스프링으로 연결
같은 elastic network로 보는 건 GNM과 동일
ANM는 reference 위치를 토대로 (거리차이 V를)
그 상태에서 헤시안 행렬 만들고
residue \(i\)를 x/y/z 방향으로 움직였을 때
residue \(j\)의 x/y/z 방향 움직임과 어떻게 연결되는가
아이겐 디컴포지션 하면댐
즉 mode \(k\)에서 모든 residue가 어느 3D 방향으로 움직이는지가 들어 있음
RMSF
→ 각 residue가 시간 동안 얼마나 흔들렸는지
변위 제곱의 루트 느낌
SASA (Solvent-Accessible Surface Area)
단백질의 어떤 뭔자 표면중에서 물 같은 solvent가 실제로 접근할 수 있는 면적
Dihedral Angles (phi, psi, chi1, 이면각)
단백질에서 결합을 축으로 원자들이 얼마나 회전해 있는지 나타내는 각도
\(\phi\) (phi): backbone에서 N–Cα 결합 주위 회전
\(\psi\) (psi): backbone에서 Cα–C 결합 주위 회전
\(\chi_1\) (chi1): side chain의 첫 번째 회전각
Comovement Correlation (동반 움직임 상관관계)
RMSF가
residue 하나가 얼마나 많이 움직이냐
를 본다면, Comovement Correlation은
residue \(i\)와 residue \(j\)의 움직임이 얼마나 연관돼 있냐
Re (End-to-end distance) & Rg (Radius of gyration) & Asphericity
Re — End-to-end distance
단백질의 맨 처음 residue와 맨 마지막 residue 사이 거리
Rg — Radius of gyration
이건 단백질 전체가 중심 주변에 얼마나 퍼져 있는지를 나타냄
Asphericity
이건 단백질 모양이 완전한 구(sphere)에서 얼마나 벗어났는지
MSA
여러 단백질 서열을 같은 위치끼리 맞춰서 정렬한 것
pLM
자연어 처럼 단백질 언어 모델
SaProt & Structure Tokens
서열 뿐만 아니라 구조까지 토큰으로
ProteinMPNN
단백질의 3D 구조를 입력으로 받고, 그 구조를 만들 수 있는 amino acid sequence를 예측하는 모델
SeqDance
amino acid sequence만 보고 RMSF, SASA, residue comovement 같은 protein dynamics 정보를 예측하도록 학습한 protein language model
ESMDance
ESM2가 이미 학습한 evolutionary information을 그대로 유지한 채, 그 위에 protein dynamics 예측 능력을 붙인 모델
Pairwise Dynamic Embedding Head
두 residue의 embedding과 attention 관계를 조합해서, 두 residue가 같이 움직이는 정도나 상호작용 빈도를 예측하는 head
Quantile Normalization
서로 다른 score들의 절대값 scale은 버리고, 순위 구조를 기준으로 분포를 맞추는 방법입니다.
데이터는
mdCATH, ATLAS, GPCRmd, PED 여기서
논문 흐름
기존 문제
기존 protein model은 protein dynamics를 직접 학습하지 않는다
① Evolutionary information
대표적으로 MSA나 **protein language model(pLM)**이 이용하는 정보인데
SM 같은 pLM은 inference 때 MSA를 만드는 건 아닙니다.
대량의 protein sequence를 가지고 masked residue prediction 등을 학습하면서,
빈칸 맞추기 하면서 그 패턴을 스스로 파악
② Static structure information
AlphaFold 같은 모델로 얻은 구조나 PDB의 experimental structure를 이용해서
- residue가 어디에 위치하는지
- 어떤 residue끼리 가까운지
- 표면/내부가 어디인지
- interaction이 어떻게 생겼는지
같은 biophysical information을 얻을 수 있음
근데 논문은 스트럭처 하나가 아니라 컨포메이션 간의 계속 움직임을 모델리 하지 않는다고 함
논문은 그래서 AlphaFold, ESM 같은 기존 state-of-the-art 모델들이 static structure와 sequence에 초점을 맞추며 protein dynamics를 직접 capture하지 못한다고 문제를 제기
그 한 장만 보면
“현재 residue들이 어디에 있는가?”
는 알 수 있지만,
“이 residue가 얼마나 흔들리는가?”
“이 두 residue가 같이 움직이는가?”
“이 구조가 어떤 다른 conformation으로 쉽게 변하는가?”
같은 건 직접 알기 어렵습니다.
논문은 static structural snapshot에는 특히
- thermodynamics
- allostery
- folding
- dynamic interaction
정보가 부족하다고 지적
IDR은 애초에 하나의 안정적인 3D structure로 고정되지 않는 영역이라서, static structure 하나로 표현하는 것 자체가 제한적
기존 protein model은 sequence에서 evolutionary pattern을 배우거나 static structure를 사용해 왔지만, 실제 protein function과 mutation effect에 중요한 structure ensemble의 dynamics 자체를 직접 학습하는 모델은 부족하다.
그 dynamics를 모델한테 어떻게 가르칠 건데? 라는 질문이 떠오를텐데
저자들은 먼저 많은 protein의 dynamics 데이터를 모읍니다.
- All-atom MD / experimental ensemble → 비교적 정밀한 dynamics
- Coarse-grained MD → 더 싸게 얻은 dynamics
- NMA (GNM, ANM) → static structure에서 더 싸게 추정한 dynamics
이렇게 합쳐서 총 64,403개 protein의 dynamics 데이터를 구성합니다. 고해상도 7,799개 + 저해상도 56,604개
논문 전체 데이터가 6천만 frame 이상이라 full structure ensemble 자체를 예측하게 만드는 건 너무 크기때문에 md 자체를 학습하진 않고
Residue 하나씩 뽑는 정보
예를 들어 residue \(i\)에 대해
- RMSF → 얼마나 흔들리는가
- SASA → solvent에 얼마나 노출되는가
- Secondary structure
- Dihedral angle \(\phi,\psi,\chi_1\) → 얼마나 비틀려 있는가
이런거를 뽑는다고 함
Residue 두 개씩 뽑는 정보
residue \(i,j\) pair에 대해서는
- Cα movement correlation → 둘이 얼마나 같이 움직이는가
- hydrogen bond
- salt bridge
- hydrophobic interaction
- van der Waals interaction
- 기타 interaction frequency
페어에서는 이렇게
NMA 데이터에서도 low / medium / high frequency mode별로
- residue fluctuation
- pairwise movement correlation
를 뽑음.
이제 SeqDance의 학습 문제는 아주 단순해집니다.
\[
\boxed{\text{Amino acid sequence}}
\rightarrow
\boxed{\text{SeqDance}}
\rightarrow
\boxed{\text{Dynamic properties 예측}}
\]
구조나 MD trajectory는 입력으로 주지 않습니다. Sequence만 줌
레지듀마다 임베딩이 되고 하나의 레지듀는 위에서 말한걸 맞추고
두개의 페어도 똑같이 다른 헤드로 위에서 말한걸 맞추게함
“Dynamics만 새로 배우는 것보다, 기존 pLM이 이미 가진 evolutionary information까지 같이 쓰면 더 좋지 않을까?”