
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- ing
- put
- IS
- 0528
- 자리
- GPT
- #삼립수박샌드 #수박샌드 #삼립신상 #삼립빵 #신상빵 #편의점신상 #편의점빵 #편의점디저트 #세븐일레븐신상 #세븐일레븐빵 #편의점간식 #신상과자리뷰 #신상리뷰 #수박맛 #수박맛빵 #수박바맛 #수박디저트 #여름간식 #여름디저트 #크림샌드 #크림카스테라 #카스테라 #빵리뷰 #간식추천 #편의점추천
- TO 부정사
- 영어학습법
- From
- 딥시크
- \
- AS
- be to 부정사
- #뱅크시 #뱅크시전시 #뱅크시전시회 #뱅크시서울전시 #뱅크시스틸히어 #BANKSY #BANKSYSTILLHERE #더현대뱅크시 #더현대서울뱅크시 #더현대서울전시 #더현대전시 #더현대전시회 #더현대서울ALT1 #ALT1 #현대백화점전시 #서울전시 #서울전시회 #서울전시추천 #서울전시회추천 #서울미술전시 #서울미술관 #서울가볼만한곳 #서울실내데이트 #서울데이트 #서울데이트코스 #서울데이트추천 #여의도전시 #여의도데이트 #여의도가볼만한곳 #여의도데이트코스 #
- deekseek
- 중국AI
- 김원스쿨
- Into
- 자리의힘
- 5형식
- TO
- Today
- Total
AI바라기의 인공지능
bench : 빠른 논문 리뷰 : LONGVIDEOBENCH: A Benchmark for Long-context Interleaved Video-Language Understanding 본문
bench : 빠른 논문 리뷰 : LONGVIDEOBENCH: A Benchmark for Long-context Interleaved Video-Language Understanding
AI바라기 2026. 9. 20. 16:48용어 설명
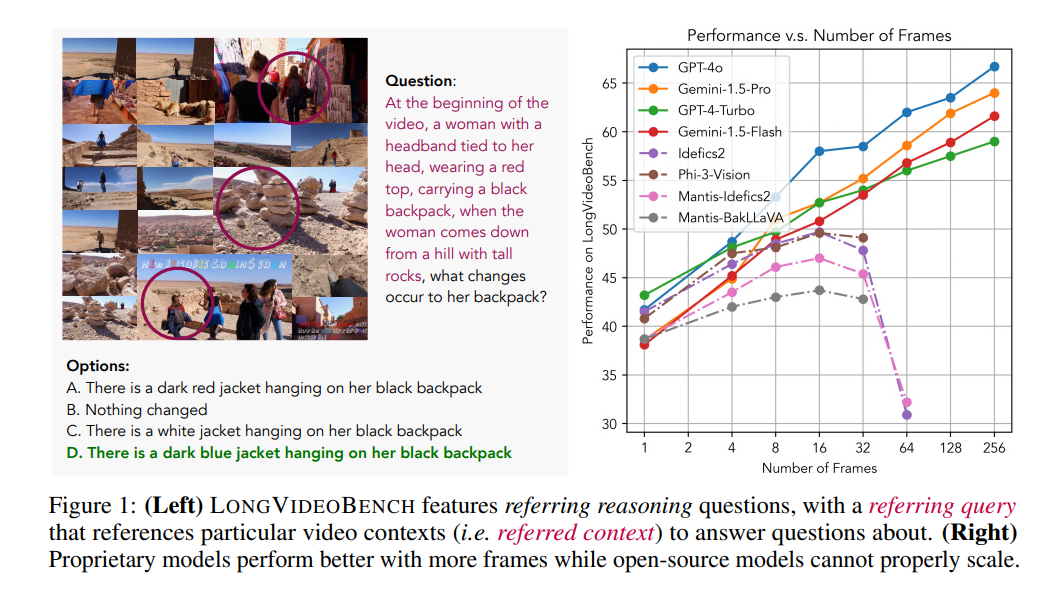
- Single-frame Bias: 기존 비디오 벤치마크에서 영상 전체를 보지 않고 단 1장의 프레임(또는 소수의 대표 프레임)만 보고도 질문의 정답을 맞출 수 있어, 입력 프레임 수를 늘려도 모델 성능이 향상되지 않는 현상.
- Referring Reasoning: 비디오 내 특정 시점이나 상황을 지칭(referring)하는 단서를 질문에 제공하고, 모델이 해당 참조 문맥(referred context)을 찾아 세부 시각 정보와 시간적 관계를 논리적으로 추론(reasoning)하도록 설계한 평가 태스크.
- Referring Query & Referred Context: Referring Query는 비디오 내 특정 순간이나 대상을 지목하는 질문 부분이며, Referred Context는 쿼리가 가리키는 실제 비디오 구간(프레임 및 자막).
- Interleaved Video-Language Input: 비디오 프레임과 자막(subtitle) 텍스트를 각각 독립적으로 처리하지 않고, 자막의 타임스탬프 중간 지점에 맞춰 프레임 사이에 자막 텍스트를 시간순으로 교차 삽입하여 구성한 멀티모달 시퀀스 입력 방식.
- Needle In A Haystack (NIAH): 방대한 분량의 컨텍스트(건초더미) 속에 숨겨진 매우 구체적인 단편 정보(바늘)를 모델이 정확히 검색 및 인출해낼 수 있는지 측정하는 스트레스 테스트.
- Sequence of Scenes (SSS): 비디오 전반에 걸쳐 등장하는 3개 이상의 장면들의 발생 시간 순서를 올바르게 배열하는 고난도 관계 추론 태스크로, 오답 선지들이 정답 순서의 순열(permutation)로 구성됨.
- Duration Groups: 비디오 길이에 따른 성능 변화를 분석하기 위해 나눈 4단계 구간: (8초, 15초], (15초, 60초], (180초, 600초], (900초, 3600초].
Purpose of the Paper
- 기존 비디오 벤치마크의 치명적 결함 극복: 기존 데이터셋(MSVD-QA, ActivityNet-QA 등)은 전체 요약형 질문에 치우쳐 있어 심각한 Single-frame Bias를 보였으며, 긴 영상을 처리할 수 있는 최신 LMM이 더 많은 프레임을 입력받아도 점수가 오르지 않는 병목이 존재했음.
- 장시간·다양한 도메인 벤치마크의 부재 해결: 기존 롱폼 비디오 벤치마크(EgoSchema, MovieChat-1K)는 길이가 3~10분 수준에 머물거나 1인칭 시점/영화 등 특정 도메인에 한정되어 있었음.
- 롱컨텍스트 검색 및 관계 추론 능력 동시 검증: 최대 1시간 분량의 영상에서 세부적인 멀티모달 단서를 인출하는 능력(Detail Retrieval)과 여러 장면 간의 시간적·인과적 연결을 이해하는 능력(Relational Reasoning)을 엄격하게 평가할 수 있는 새로운 표준 제시.
Key Contributions & Novelty
- LONGVIDEOBENCH 벤치마크 구축:
- 최대 60분 길이, 10개 콘텐츠 카테고리(영화 요약, 일상, 뉴스, 지식/과학 등)를 포괄하는 3,763개 영상과 6,678개의 정밀 검수된 인간 주석 객관식(MCQ) 데이터 구축.
- 8초의 짧은 영상부터 3,600초의 초장문 영상까지 4단계의 점진적 Duration Groups로 설계.
- Referring Reasoning 태스크 체계화 (Novelty):
- Single-frame Bias를 구조적으로 배제하기 위해 질문 내에 특정 시점을 지목하는 Referring Query를 필수 포함.
- (L1) Perception (8개 카테고리: 단일 시점의 객체, 속성, 이벤트 인식)과 (L2) Relation (9개 카테고리: 다중 시점 간 전후 관계, 속성 변화, 객체 추적, 장면 순서 배열)의 총 17개 세부 태스크로 분기.
- 진정한 Interleaved Video-Language 평가 환경 조성:
- Whisper-V3-Large 기반 전사 자막을 영상 프레임 사이사이에 타임스탬프 정렬로 삽입하여 인간이 자막과 영상을 동시에 소비하는 방식을 구현.
- 대규모 LMM 평가를 통한 새로운 통찰 도출:
- 상용(Proprietary) 모델과 오픈소스(Open-source) 모델 간의 프레임 스케일링 격차 규명.
- 비디오 특화 LMM이 이미지 기반 LMM 대비 롱컨텍스트에서 오히려 뒤처지는 이상 현상 및 영상 내 쿼리 위치(Depth)에 따른 취약점 실증.
Experimental Highlights
- 프레임 스케일링에 따른 성능 향상 실증 (Single-frame Bias 타파):
- Proprietary 모델(GPT-4o, Gemini-1.5-Pro)은 입력 프레임 수가 증가할수록 일관되게 성능이 향상됨.
- GPT-4o는 검증셋 기준 1 프레임 41.7%에서 256 프레임 66.7%로 대폭 상승.
- 180초 이상 비디오 구간에서 GPT-4o와 Gemini-1.5-Pro는 프레임을 16개에서 256개로 늘렸을 때 10% 이상의 비약적 성능 향상을 기록함 (EgoSchema에서 Gemini-1.5-Pro가 16→150 프레임 시 단 2.5% 향상에 그친 것과 극명히 대비).
- 오픈소스 LMM의 컨텍스트 확장 한계 및 붕괴 현상:
- 오픈소스 모델(Idefics2, Mantis-Idefics2 등)은 16 프레임 초과 입력 시 성능이 정체되거나, 컨텍스트 한계에 도달하기 전인 64 프레임 설정에서 급격한 성능 붕괴(Idefics2: 16프레임 49.7% → 64프레임 30.9%)를 겪음.
- Video LMM vs Image LMM 역전 현상:
- 동일 계열 아키텍처에서 비디오 데이터로 추가 학습된 LLaVA-Next-Video-M7B(43.5%)가 단일 이미지 기반 멀티프레임 모델인 LLaVA-Next-Mistral-7B(47.1%)보다 낮은 점수를 기록.
- 기존 비디오 사전학습 데이터가 짧은 클립과 요약성 태스크에 치우쳐 있어 장시간 세부 비디오 이해 능력이 퇴화되었음을 시사.
- L2 Relation 및 Sequence of Scenes(SSS)의 극단적 난이도:
- 모든 모델에서 L1 Perception 대비 L2 Relation 성능이 크게 떨어졌으며, 특히 장면 순서를 맞추는 SSS 태스크는 최고 성능 모델인 GPT-4o조차 44.3%에 그쳐 시간 순서 파악에 취약함을 노출.
- 입력 모달리티 영향 (Modality Ablation):
- 비디오 프레임 없이 자막만 제공할 경우 GPT-4o의 성능은 66.7%에서 44.6%로 폭락하여 시각 정보의 필수성을 입증.
- 자막을 함께 결합했을 때 GPT-4o는 6.1%p 향상되었으나, 오픈소스 모델들은 자막 정보를 결합해도 유의미한 성능 향상을 이끌어내지 못함.
- Referring Query Depth (NIAH 현상 관측):
- 질문이 지칭하는 대상이 영상의 시작 부분이나 중간(Middle)에 위치할수록 모델들의 정답률이 크게 떨어지는 "Lost-in-the-Middle" 현상이 롱 비디오 이해에서도 동일하게 발생.
Limitations and Future Work
- Audio Modality 배제:
- 비디오의 핵심 요소인 배경음, 음향 효과, 화자의 억양 등 오디오 모달리티가 제외되고 시각 프레임과 텍스트 자막만 평가 대상에 포함됨.
- 향후 오디오-비디오-언어를 결합한 진정한 Tri-modal 롱컨텍스트 평가 체계로의 확장이 필요함.
- 비디오 길이의 상한선 (1시간):
- 장시간 영상을 다루었으나 최대 길이가 3,600초(1시간)로 제한되어 있어, 수 시간 이상의 영화 전편이나 라이브 스트리밍 영상을 다루는 극단적 장기 컨텍스트(Extremely Long-form) 모델 평가는 다루지 못함.
- 오픈소스 아키텍처의 프레임 확장성 부족에 대한 대안 탐색:
- 현재 대다수 오픈소스 모델이 16프레임 이상을 의미 있게 소화하지 못하므로, 토큰 압축 기법이나 메모리 증강(Memory-augmented) 구조를 도입한 새로운 롱폼 비디오 아키텍처 연구가 필수적임.
Overall Summary
LONGVIDEOBENCH는 기존 비디오 벤치마크들이 단일 프레임만으로도 풀리던 'Single-frame Bias'를 타파하고, 최대 1시간 길이의 영상에서 세부 시각 정보의 검색과 시간적 관계 추론을 엄밀히 측정하기 위해 고안된 새로운 벤치마크이다. 질문 내 특정 시점을 명시적으로 참조하는 Referring Reasoning 태스크와 시간 정렬 자막-비디오 교차 입력을 도입하여 총 6,678개의 고품질 QA를 구축했다. 평가 결과, 최상위 상용 모델(GPT-4o, Gemini-1.5-Pro)은 프레임 수가 증가함에 따라 뚜렷한 성능 향상을 보이며 롱컨텍스트 능력을 증명한 반면, 오픈소스 모델들은 16 프레임을 넘어서면 성능이 정체되거나 붕괴되는 명확한 한계를 드러냈다. 본 연구는 향후 LMM이 진정한 장시간 멀티모달 이해를 달성하기 위해 나아가야 할 모델 스케일링 및 아키텍처 개선 방향을 명확히 제시한다.
쉬운 설명
기존의 비디오 AI 시험은 2시간짜리 영화를 주고 "이 영화의 전체 줄거리가 뭐야?"라고 묻는 것과 같았습니다. 이 방식은 영화의 포스터나 예고편 한 장면만 대충 봐도 찍어서 맞출 수 있었기 때문에, AI가 실제로 영화 전체를 꼼꼼히 봤는지 알 수 없었습니다.
반면, 이 논문이 만든 시험지는 "영화 시작 10분에 주인공이 메고 있던 검은 가방이, 40분 뒤 높은 바위 언덕을 내려올 때 어떻게 바뀌었는가?"처럼 영상의 아주 특정한 순간들을 정확히 찾아내서 앞뒤 상황을 대조해야만 풀 수 있는 문제들로 구성되어 있습니다. 그 결과, 실제로 많은 장면을 꼼꼼하게 기억하고 연결해서 볼 수 있는 고급 모델(GPT-4o 등)만 고득점을 받을 수 있게 되었으며, 긴 영상을 처리한다고 홍보하지만 실제로는 앞부분 몇 장면만 보고 넘겨짚던 모델들의 밑천을 정확히 드러내 주는 정밀한 시험지 역할을 합니다.